Recuperación de clústeres cerebrales divididos para un tiempo de actividad del 100 %
NCache Es una caché distribuida en memoria extremadamente rápida y escalable para .NET, Java, Python y Node.js. Se utiliza ampliamente en producción para aplicaciones críticas. Para garantizar una alta disponibilidad y un tiempo de actividad del 100 %, NCache Ofrece un amplio conjunto de funciones de alta disponibilidad. Una de ellas es su capacidad para detectar y resolver el cerebro dividido en un clúster para evitar tiempos de inactividad.
¿Qué es un grupo de cerebros divididos?
NCache crea un Clúster de caché dinámico de autorrecuperación Consta de varios servidores que se comunican entre sí mediante TCP. Todos los servidores de caché están interconectados en el clúster. Su membresía se mantiene en tiempo de ejecución y se comparte con servidores y clientes.
Sin embargo, como cualquier sistema distribuido, la NCache El clúster puede encontrarse con una situación en la que uno o más servidores de caché se desconectan del resto de los servidores del clúster, aunque siguen en funcionamiento. Esto suele ocurrir debido a fallos de red.
Cuando esto sucede, cada conjunto de servidores de caché se considera el servidor superviviente del clúster de caché original y asume que los demás servidores de caché han dejado de funcionar. De ahí el término "Cerebro Dividido", que en términos médicos significa que el hemisferio izquierdo del cerebro no percibe al hemisferio derecho. Los clientes de caché también pueden dividirse de forma similar o continuar comunicándose con todos los servidores de caché según la pertenencia al clúster original.
Sin un mecanismo de recuperación automatizado, los escenarios de cerebro dividido conducen a inconsistencias de datos y conflictos de integridad, ya que dos conjuntos independientes de clientes actualizan diferentes versiones de los mismos datos simultáneamente.
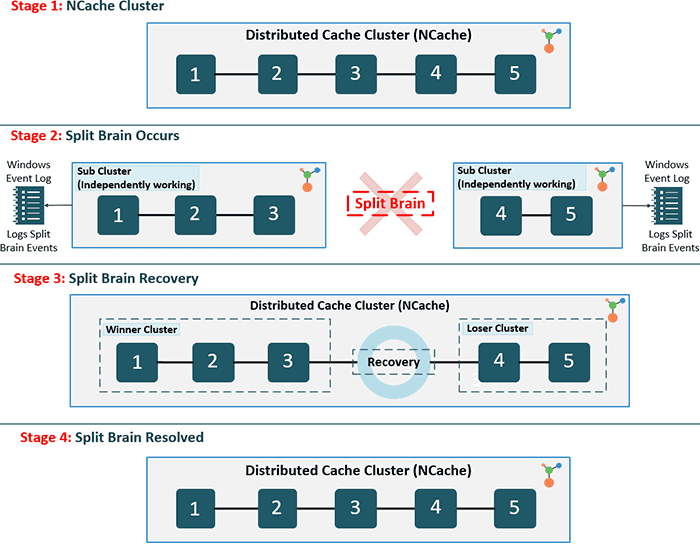
Cerebro dividido en clúster de caché

Esto conduce a errores en operaciones de caché Y, lo más importante, problemas de integridad de los datos. Cada "clúster dividido" ahora tiene su propia copia de datos, que los clientes actualizan de forma independiente. Y, como resultado, se obtienen dos o más copias de los mismos datos que se actualizan sin sincronización, lo que provoca inconsistencias.
Cómo NCache ¿Detecta cerebro dividido en clústeres distribuidos?
NCache Tiene la capacidad de detectar automáticamente cuándo se produce un clúster de Split Brain. Normalmente, el administrador de caché utiliza el NCache Centro de gestion o lo necesario Cmdlet de PowerShell Para eliminar un servidor de caché del clúster, se registran estos eventos. Por lo tanto, en el caso de un cerebro dividido, cada subclúster... registra eventos al Registro de eventos de Windows indicando que algunos de sus miembros originales se han ido. Por lo tanto, en caso de un cerebro dividido, NCache El administrador ve eventos de "nodo abandonado" para casi todos los servidores de caché e intenta reconectarse con los "servidores perdidos".
Solo cuando se restablece la conexión de red entre los subclústeres divididos se detecta que se ha producido una división cerebral. Tras ello, cada subclúster registra los eventos en el Registro de eventos de Windows y también notifica al administrador de caché mediante un... Notificación Por Correo Electrónico: que se ha producido un Split Brain.
Cómo Se Compara NCache ¿Función de recuperación automática del cerebro dividido?
Habilitar la recuperación del cerebro dividido a través de config.ncconf agregando el etiqueta debajo de la Etiqueta. Cuando la etiqueta se establece como Verdadero, puede detectar posibles problemas de cerebro dividido en clúster. Sin embargo, solo funciona en la topología de Partición-Réplica.
<cache-settings...>
  <split-brain-recovery enable="True" detection-interval="60"/>
</cache-settings>
Durante la fase de detección, NCache Utiliza latidos basados en TCP para supervisar el estado del nodo. Si se produce una partición de red, el clúster la identifica según la configuración. intervalo de detección. Una vez detectado, NCache aplica la regla de nodo mayoritario o la regla de clúster complejo para determinar el "Ganador".
NCache determina el grupo ganador basándose en estos criterios:
- Regla de la mayoría: El subclúster con el mayor número de nodos será designado ganador.
- Regla de complejidad: Si los números de nodos son iguales, el subclúster con la configuración interna y la conectividad más complejas gana.
Si el usuario ha configurado la recuperación automática en un escenario de cerebro dividido, todos los subclústeres negocian entre sí para determinar al "ganador". Una vez hecho esto, los demás subclústeres se unen a este clúster desechando sus datos y actuando como si fueran nuevos nodos que se unen a un clúster existente.
Las reglas para determinar qué subclúster debe ganar son sencillas. El subclúster con el mayor número de nodos miembro es el ganador. Si varios subclústeres tienen el mismo número de nodos miembro, gana el que tenga la dirección IP de coordinador más pequeña.
¿Qué hacer a continuación?
- Solicite una demostración EN VIVO personalizada
- Documentos sobre el grupo de cerebros divididos
- Comparación de ediciones