NCache Architecture
Aujourd'hui, je vais parler de NCache Architecture. NCache est un magasin distribué en mémoire pour les applications .NET et Java. C’est extrêmement rapide et évolutif. Et vous pouvez l'utiliser dans vos applications serveur à transactions élevées pour améliorer les performances et l'évolutivité de vos applications.
Utilisations courantes de NCache
Cache distribué
Les deux manières courantes NCache est utilisé. Le numéro un est comme un Cache distribué où vous mettez en cache les données de l'application pour réduire ces déplacements coûteux dans la base de données et, le numéro deux est un Messagerie et flux plate-forme. Je vais passer en revue ces deux points brièvement avant d'aborder l'architecture.
-
Mise en cache des données d'application
Ainsi, dans le cache distribué, la mise en cache des données d'application signifie que vous utilisez un NCache L'API sert généralement à mettre en cache les données de votre application. Vous n'avez donc pas besoin d'accéder à la base de données aussi souvent, car le cache est beaucoup plus rapide que la base de données. Elle est également plus évolutive car elle est en mémoire, ce qui la rend rapide. Proche de votre application, elle est rapide et distribuée, donc évolutive. Si vous utilisez une application .NET avec EF Core, vous pouvez utiliser NCache via EF Core, ainsi que NHibernate et EF 6. Si vous avez des applications Java, vous pouvez utiliser NCache comme cache Hibernate de second niveau. Vous pouvez également l'utiliser comme cache Spring ou le programmer avec JCache. -
Mise en cache des applications Web
La deuxième partie de l'utilisation du cache distribué est, si vous avez des applications Web, que vous pouvez stocker vos séances en NCache et puis NCache réplique ces sessions sur plusieurs serveurs, de sorte que s'il y en a un NCache Si le serveur tombe en panne, vous ne perdez aucune donnée. Ces sessions sont très évolutives grâce à leur stockage distribué et sont donc extrêmement rapides. La fonctionnalité de sessions multisites est également disponible dans tous les langages : .NET, Java, Node.js, etc. Outre les sessions, par exemple, les applications ASP.NET Core pour .NET 6 peuvent stocker leurs sessions. Cache de réponse dans NCache et ils peuvent également utiliser NCache car fond de panier pour SignalRSignalR est destiné aux applications web en direct qui doivent envoyer des événements aux clients. Si vous utilisez .NET 4.8, vous pouvez également stocker l'état de votre session. Afficher l'état, Cache de sortie, et aussi SignalR.
NCache pour les applications critiques
Laissez-moi vous montrer rapidement ce NCache Voici à quoi cela ressemble. Voici à quoi cela ressemble en tant que cache distribué pour les applications critiques. J'utilise le terme « critique » car, dans la plupart des cas, les clients l'utilisent. NCache Dans des applications très sensibles, destinées aux clients et essentielles à leur activité. NCache est, vous savez, une partie de votre infrastructure très critique dans ce cas.

Et, comme je l'ai dit, il s'agit d'applications serveur à haut volume de transactions. Ce sont des applications web. Ce sont des microservices, des API web ou d'autres applications serveur. Évidemment, vous pouvez utiliser .NET, Java, Node.js ou Python. Et, ces applications tentent d'accéder à votre base de données, qu'il s'agisse d'une base de données relationnelle comme SQL Server, Oracle, Db2, MySQL ou toute autre base de données relationnelle, ou bien elles accèdent à vos données mainframe héritées, ou encore elles utilisent une base de données NoSQL comme MongoDB, Cosmos DB, Cassandra ou autre. Dans ce cas, NCache devient un cache distribué par… vous utilisez NCache comme deux ou plusieurs serveurs en tant que niveau de mise en cache distinct, bien que vous n'ayez pas besoin d'avoir un niveau de mise en cache distinct, votre application peut s'exécuter dans la même boîte que NCache et fonctionne parfaitement bien, mais l'architecture de déploiement la plus populaire consiste à avoir un niveau de mise en cache séparé, c'est juste une manière plus propre d'utiliser NCache.
Alors, disons que vous démarrez avec un cluster de cache à 2 serveurs, NCache grappe, NCache regroupe la mémoire, le processeur et les ressources de la carte réseau de tous ces serveurs dans une capacité logique et, disons, vous mettez plus de charge de transaction via vos applications sur NCache et ces deux serveurs sont au maximum, vous pouvez facilement ajouter un troisième serveur, ou un quatrième serveur, ou un cinquième serveur et ainsi de suite, NCache Cela ne constitue jamais un goulot d'étranglement. C'est impossible avec les bases de données traditionnelles. Les bases de données ne sont pas évolutives. Les bases de données NoSQL le sont, mais nous avons constaté que, dans la plupart des cas, les entreprises doivent utiliser des bases de données relationnelles pour diverses raisons métiers et disposent également d'anciens systèmes mainframe. Ainsi, comme la couche de stockage de données n'est pas évolutive, le système ne peut pas être mis à l'échelle. NCache Aide votre application à évoluer en vous permettant de mettre en cache un maximum de données. L'objectif général est de pouvoir trouver les données dans environ 80 % des cas. NCache Au lieu d'accéder à votre base de données, si vous parvenez à atteindre ce ratio, vous allégerez la pression sur les bases de données et votre application évoluera.
Messagerie et flux
Le deuxième cas d'utilisation courant, ou utilisation de NCache est de l'utiliser comme une plate-forme de messagerie et de flux où vous pouvez avoir plusieurs applications qui peuvent communiquer entre elles via Messagerie Pub/Sub, par Requête continue, NCache Événements basés sur des événements. Je vais vous montrer à quoi cela ressemble. Par exemple, si vous avez une application serveur à transactions élevées nécessitant de nombreux messages en temps réel ou un traitement de flux, vous pouvez utiliser NCache. Maintenant la même chose NCache Ce qui était un cache distribué est devenu une plateforme de messagerie et de flux. Il s'agit d'un stockage distribué en mémoire. Son évolutivité est linéaire. Il réplique les messages sur plusieurs serveurs. En fait, NCache il y a aussi de la persistance en lui.

Ainsi, différentes applications sont possibles. Par exemple, la messagerie Pub/Sub est très répandue. C'est une méthodologie, un paradigme où plusieurs éditeurs et abonnés peuvent communiquer entre eux de manière découplée. L'éditeur ignore l'identité de l'abonné : il publie simplement des messages sur certains sujets, et ces abonnés peuvent les recevoir. Les requêtes continues fonctionnent de la même manière. Ce sont donc les deux méthodes les plus courantes. NCache est utilisé.
Applications .NET et Java
Parlons maintenant de la façon dont NCache gère les applications .NET et Java. NCache a une capacité multiplateforme native très unique que vous trouverez très intéressante, laissez-moi vous en parler.
Édition .NET
NCache Nous essayons de vous fournir une solution native pour .NET et Java. Autrement dit, avec une application .NET, toute votre pile applicative utilise .NET, vous n'utilisez que .NET. Par exemple, NCache dispose d'un client .NET natif, qui correspond à ce que votre application utilisera. Il s'exécute sur votre serveur d'applications et NCache a développé cela en 'C Sharp' (C#), à 100%.
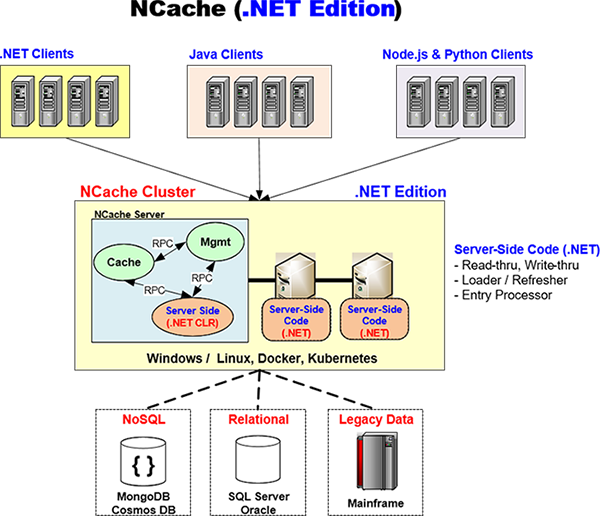
De même, si vous avez du code côté serveur comme Read-through, Write-through, Right-behind, Loader/Refresher que vous avez écrit en .NET, NCache exécutera ce code dans son propre processus CLR .NET. Je vais vous montrer comment. Je reviendrai sur ce diagramme à plusieurs reprises. Par exemple, voici un exemple NCache Vous avez ici une application .NET qui peut s'exécuter sous Windows ou Linux. Elle possède une architecture native NCache Client .NET. Et, ceci parle à un NCache cluster qui est une édition .NET NCache Cluster. Cela signifie donc que le code côté serveur est également .NET.
Maintenant le chemin NCache Son architecture est particulièrement performante pour la prise en charge native multiplateforme grâce à ses processus de cache et de gestion, distincts du processus de code côté serveur. Il s'agit également d'un RPC très performant, en mémoire. NCache utilise, que NCache a développé son propre RPC propriétaire, ultra-rapide. C'est ainsi que le cache communique avec votre code côté serveur. Par exemple, s'il doit appeler le gestionnaire de lecture, celui-ci s'exécutera dans ce processus CLR .NET pour accéder à votre base de données et récupérer les données, puis les transmettre au cache. Il en va de même pour l'écriture, le chargeur et le rafraîchisseur. Ainsi, toute l'expérience de votre application est .NET.
Édition Java
Passons maintenant au côté Java. De la même manière, nous avons un code Java côté serveur. NCache Il dispose d'un client 100 % Java qui s'exécute sur votre serveur d'applications, comme pour .NET. Voici l'édition Java. Imaginons que vous ayez une application Java qui s'exécute probablement sous Linux, voire Windows, Docker ou Kubernetes. Cette application intégrera donc le NCache Le client Java, comme je l'ai dit, est 100 % Java natif. Ce client Java est identique au client .NET. Il communique également avec NCache Regroupez de la même manière que le client .NET en utilisant NCacheson propre protocole de socket propriétaire et le NCache le serveur est conçu de manière à ce que votre code Java côté serveur s'exécute sur sa propre JVM.
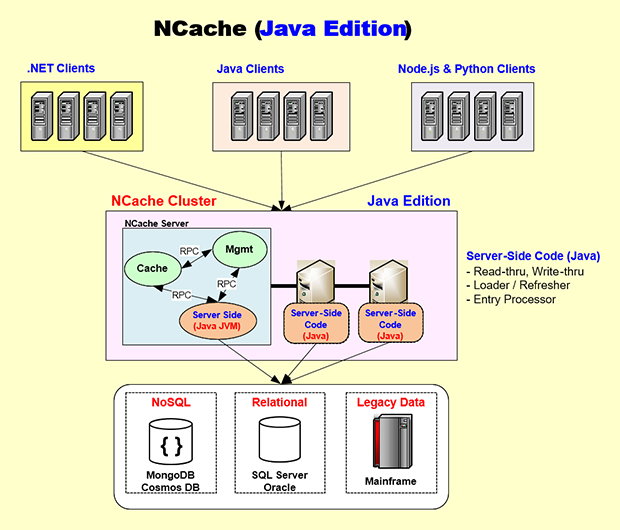
Ainsi, tout le développement, les tests et le débogage seront effectués dans des processus JVM natifs. Ce processus de cache appellera, par exemple, le gestionnaire de lecture, qui accédera à une base de données Oracle, DB2 ou même SQL Server pour récupérer les données et les transmettre au processus de cache. Le même RPC hautes performances en mémoire est utilisé. Ainsi, grâce à une architecture encapsulant le code .NET et Java dans leurs propres processus natifs, NCache est capable de vous fournir une pile native pour Java et .NET.
Et, encore une fois, dans le cas d'une application Java, vous souhaiterez peut-être effectuer votre développement sur Windows ou Mac OS et NCache le prend en charge complètement, ou même Linux et, alors, vous êtes plus susceptible d'utiliser Docker et Kubernetes, que les gens de .NET NCache Vous disposez d'images Docker et d'une prise en charge complète de Kubernetes, d'Azure AKS, d'AWS EKS, de Google GKE et de Red Hat OpenShift. Son utilisation est très fluide.
Alors, NCache est unique. Il vous offre une expérience .NET native et Java native à la fois. Ainsi, si vous êtes un développeur Java, vous n'avez pas l'impression d'utiliser un produit non Java, et si vous êtes un développeur .NET, vous n'avez pas l'impression d'utiliser un produit non .NET. C'est là tout l'intérêt de NCache la façon dont c'est architecturé.
Cluster dynamique
Architecture peer to peer (auto-guérison)
- Pas de point de défaillance unique (pas de maître/esclave)
- Coordonnateur de groupe nœud le plus ancien, le suivant le plus ancien est le successeur automatique
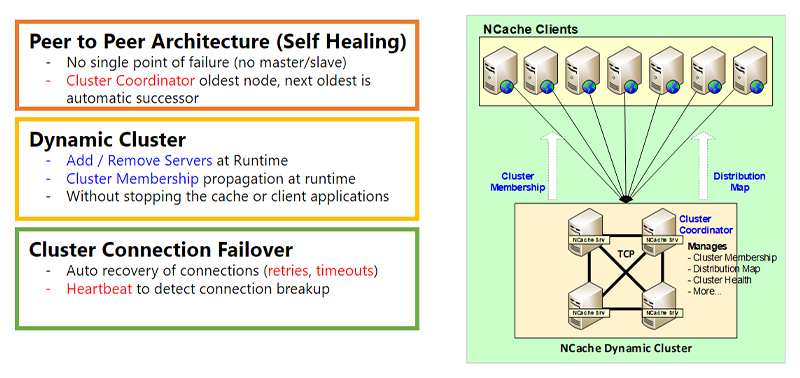
Ok, passons maintenant à la Clustering Dynamique une partie de NCache Architecture de haute disponibilité. Et, une seconde, d'accord. La première partie est le cluster dynamique. Quand j'utilise le mot cluster, je ne parle pas de cluster Kubernetes, ni d'un autre cluster au niveau du système d'exploitation. Il s'agit NCacheLe cluster TCP de Microsoft est le sien. Ce cluster possède une architecture pair-à-pair. Ce qui signifie qu'il n'y a ni maître ni esclave. Le problème du mode maître/esclave est que si le maître tombe en panne, l'esclave devient inopérant ou limité, alors que dans une architecture pair-à-pair, tous les nœuds ont les mêmes capacités. Il existe évidemment un nœud coordinateur de cluster, qui est le nœud le plus ancien. En cas de panne de ce nœud, le suivant est automatiquement sélectionné comme coordinateur. Le coordinateur de cluster gère l'appartenance au cluster. Il gère la carte de distribution, l'état du cluster et bien d'autres aspects que je détaillerai plus loin.
Cluster dynamique
- Ajouter / Supprimer des serveurs au moment de l'exécution
- Adhésion au cluster propagation à l'exécution
- Sans arrêter le cache ou les applications clientes
Le clustering dynamique vous permet d'ajouter ou de supprimer des serveurs au cluster pendant l'exécution, sans interrompre le cache ni l'application. Il n'y a aucune interruption. Par exemple, si vous ajoutez un nouveau serveur au cluster, l'appartenance au cluster est mise à jour à l'exécution et ces informations sont ensuite transmises aux clients. J'y reviendrai plus en détail dans la diapositive suivante.
Basculement de connexion au cluster
- Récupération automatique des connexions (tentatives, délais)
- Battement de coeur pour détecter une rupture de connexion
Il existe également une fonctionnalité de basculement de connexion de cluster. Comme il s'agit de sockets, les serveurs du cluster se trouvent généralement dans le même sous-réseau, à proximité les uns des autres, mais ce n'est pas toujours le cas. Certains de nos clients ont des serveurs déployés dans différentes régions et cela fonctionne parfaitement, même si nous recommandons, dans la plupart des cas, que NCache Les serveurs devraient être assez proches les uns des autres. Cependant, une panne de connexion pourrait survenir. Si tel est le cas, NCache Il y a une logique de relances, des délais d'attente et une logique de pulsation, tout cela pour garantir le bon fonctionnement du processus.
Clients dynamiques et configuration dynamique
Connexions client dynamiques
- Ajouter/supprimer des clients lors de l'exécution
- Sans s'arrêter le cache ou les applications clientes
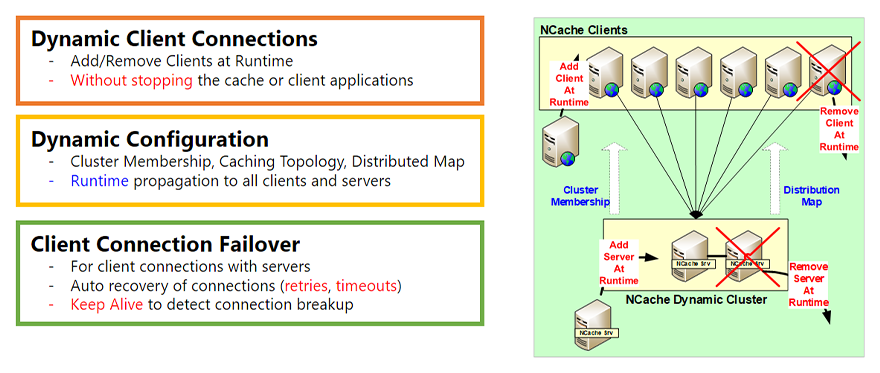
L'autre partie de l'architecture dynamique est constituée des clients dynamiques. Ainsi, le cluster permettait d'ajouter ou de supprimer des serveurs lors de l'exécution, et il permettait également d'ajouter ou de supprimer des clients lors de l'exécution. Qu'entend-on par client ? Un client est le NCache Le client qui s'exécute sur votre serveur d'applications, votre serveur web, est la partie avec laquelle votre application communique. Vous pouvez donc ajouter ou supprimer un client à l'exécution sans interruption. NCache, le cache ou votre application sans interruption. Voilà pour la première partie.
Configuration dynamique
- Appartenance au cluster, topologie de mise en cache, carte distribuée
- Runtime propagation à tous les clients et serveurs
La deuxième partie concerne la configuration dynamique. Comme je l'ai mentionné dans la diapositive précédente, l'ajout d'un serveur au cluster modifie son appartenance. Cette modification est propagée à tous les clients existants connectés, qui savent ainsi qu'un nouveau serveur doit être connecté. S'ils le souhaitent, en fonction de la topologie de mise en cache, ils peuvent également se connecter à ce serveur. De plus, selon la topologie, une carte de distribution peut être utilisée. Elle est davantage destinée au cache partitionné et au cache réplica partitionné. Cependant, à mesure que vous ajoutez un serveur, celui-ci est mis à jour et propagé à l'exécution. De nombreuses autres modifications de configuration sont également possibles. Une fonctionnalité d'application à chaud est disponible et propagée à l'exécution. Voilà donc la deuxième partie.
Basculement de connexion client
- Pour les connexions client avec les serveurs
- Récupération automatique des connexions (tentatives, délais)
- Rester en vie pour détecter une rupture de connexion
Le troisième aspect concerne le basculement de connexion client, similaire au basculement de connexion cluster. Cependant, il est d'autant plus nécessaire que les clients ne seront probablement pas toujours très proches des serveurs cluster. De plus, des routeurs ou des pare-feu peuvent se trouver entre les deux. La connexion entre les clients et le cluster est donc plus susceptible d'être interrompue. NCache Il dispose d'une fonction de relance et de temporisation relativement intelligente. Il dispose également d'une fonction de maintien de connexion, permettant au client de rester connecté même en cas de coupure. NCache Groupe.
Détection et récupération du cerveau divisé
Un autre sujet important de l’aspect dynamique de NCache L'architecture est un phénomène appelé « Split Brain ». Ce phénomène peut se produire dans un cluster.
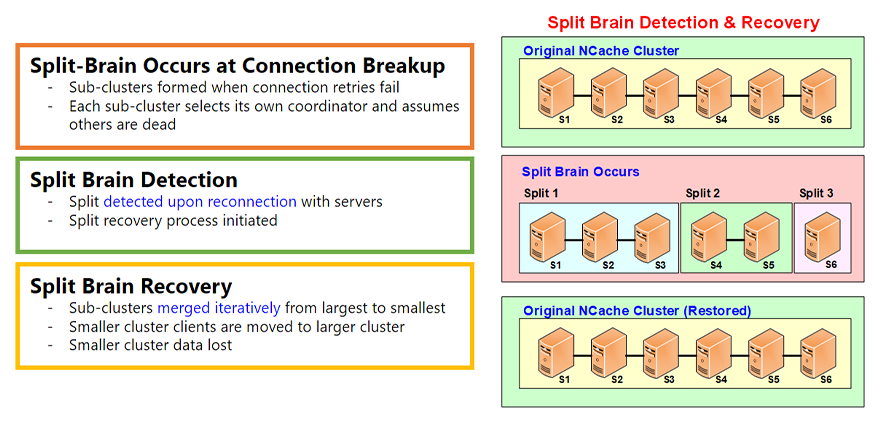
Le split-brain se produit lors de la rupture d'une connexion
- Sous-clusters formés lorsque les tentatives de connexion échouent
- Chaque sous-cluster sélectionne son propre coordinateur et suppose que les autres sont morts
Un split brain se produit lorsque, par exemple, un cluster sain de six serveurs est interrompu. Un split brain se produit lorsque la connexion entre certains de ces serveurs est interrompue pour une raison quelconque. Chaque fois qu'une connexion réseau est interrompue, des sous-clusters se forment. Prenons l'exemple d'un split 1, d'un split 2, d'un split 3. Chaque sous-cluster se prend pour le survivant. Il crée alors son propre coordinateur de cluster et devient un cluster indépendant.
Détection de cerveau divisé
- Diviser détecté lors de la reconnexion avec des serveurs
- Processus de récupération fractionné lancé
Cependant, toutes ces divisions se souviennent qu'elles faisaient partie d'un cluster sain et que ces serveurs n'ont pas quitté volontairement, ni en douceur. Vous n'avez pas effectué de « sortie de nœud » depuis le NCache L'outil de gestion a interrompu la connexion. Ils continueront donc de rechercher ces serveurs pour voir si la connexion réseau est rétablie. La plupart du temps, la connexion sera probablement rétablie cinq, dix minutes, une demi-heure ou une heure plus tard.
Récupération du Cerveau Divisé
- Sous-groupes fusionné de manière itérative du plus grand au plus petit
- Les clients de cluster plus petits sont déplacés vers un cluster plus grand
- Perte de données de cluster plus petites
Lorsque cela se produit, une récupération de cerveau divisé est effectuée. C'est là que ces divisions sont fusionnées. Ces sous-clusters sont fusionnés de manière itérative, du plus grand au plus petit. Il y a évidemment une perte de données, car ces clusters sont devenus indépendants et une partie des données doit être perdue. Mais tout cela est effectué automatiquement selon les règles que vous spécifiez.
Il y a plus de détails sur le cerveau divisé dans un article séparé. face Mais cela vous donne un aperçu. C'est une fonctionnalité très importante qui garantit que votre NCache Le cluster reste en bonne santé et peut récupérer chaque fois qu'une division cérébrale se produit.
Topologies de mise en cache
Ok, maintenant, passons à Topologies de mise en cacheLes topologies de mise en cache concernent essentiellement le stockage des données, les stratégies de réplication et les stratégies de connexion client. Il existe quatre topologies : le cache partitionné, la réplication de partition, le cache répliqué et le cache miroir. Prenons le cache partitionné.
Cache partitionné
- Cache divisé en partitions lors de l'exécution
- Une partition par serveur de cache. 100 buckets pour l'ensemble du cluster de cache répartis uniformément
- L'ajout/la suppression d'un serveur crée/supprime une partition
Cache partitionné En résumé, le cache est divisé en partitions : chaque serveur en possède une. Il existe également le concept de compartiments. Chaque partition possède des compartiments. Au total, 100 compartiments couvrent l'ensemble du cache. Ainsi, selon le nombre de partitions, ces compartiments sont répartis équitablement.
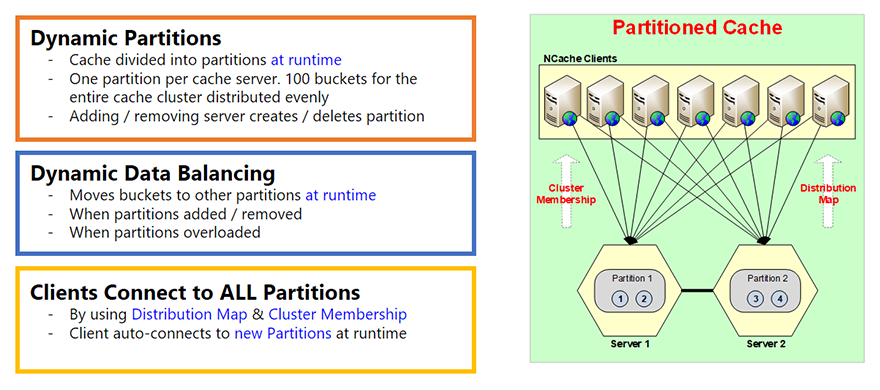
Ces partitions sont créées à l'exécution, ce qui est crucial. Ainsi, lorsque vous ajoutez un serveur, une partition est créée. Imaginons que vous commenciez avec un serveur unique, contenant les 100 buckets. Si vous ajoutez un second serveur à l'exécution, non seulement les informations d'appartenance au cluster sont mises à jour, comme mentionné dans les diapositives précédentes, mais la carte de distribution est également mise à jour. Une carte de distribution indique quelles partitions contiennent quels buckets. Par exemple, si vous ajoutez une seconde partition, la carte de distribution est modifiée. Il s'agit en fait d'une carte de hachage qui mappe les buckets. La valeur de la carte de hachage s'étend aux buckets. Elle ne varie pas en fonction de la quantité de données ajoutées ; elle change uniquement lorsque vous modifiez le nombre de serveurs, le nombre de partitions ou le rééquilibrage des données. Les partitions sont donc dynamiques.
Équilibrage dynamique des données
- Déplace les buckets vers d'autres partitions lors de l'exécution
- Lorsque des partitions sont ajoutées/supprimées
- Lorsque les partitions sont surchargées
Le deuxième aspect concerne l'équilibrage dynamique des données. Comme tout cela repose sur une table de hachage, il est fort possible que, selon le type de clés utilisées, certains compartiments reçoivent plus de données que d'autres. Certaines partitions seront alors presque pleines et d'autres presque vides. Dans ce cas, NCache Il existe une fonctionnalité permettant de définir un seuil. Par exemple, si une partition est remplie à plus de 80 %, il suffit d'en supprimer 20 %, 10 % ou 5 %. Il ne s'agit pas de supprimer, mais d'équilibrer dynamiquement les données. L'équilibrage des données consiste à copier ou déplacer les données de la partition 1 vers d'autres partitions. L'équilibrage des données garantit ainsi une répartition homogène des données et de toutes les partitions.
Le client se connecte à toutes les partitions
- En utilisant Carte de répartition & Adhésion au cluster
- Le client se connecte automatiquement à nouvelles partitions lors de l'exécution
Dans le cache partitionné, chaque client se connecte à toutes les partitions ou à tous les serveurs. Cela permet d'accéder directement à l'élément souhaité en un seul appel. S'il n'est connecté qu'à un seul serveur, par exemple, et qu'il souhaite accéder à l'élément numéro 3, il contactera le serveur 1. Ce dernier se rendra ensuite au serveur 1 pour l'obtenir. Il s'agit d'une opération à deux sauts, moins optimisée que si le client pouvait accéder directement aux données. Le client le sait grâce à une carte de distribution. C'est pourquoi cette carte est créée pour permettre aux clients de savoir où se trouvent les données et de les récupérer directement.
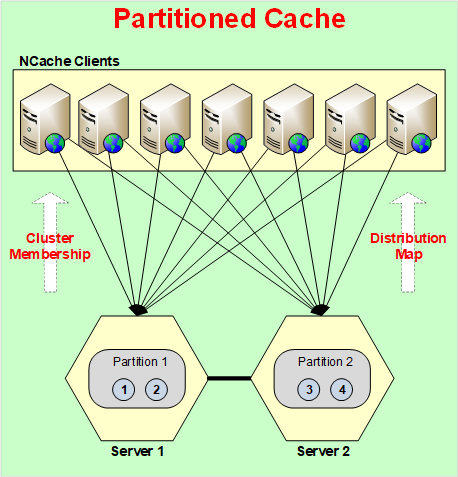
Le cache partitionné n'offre donc aucune réplication. Ainsi, si un serveur tombe en panne, vous perdez vos données. Il n'y a aucun moyen de le faire, sauf en utilisant la « Persistance », dont je parlerai plus loin. Dans ce cas, même le cache partitionné ne perd aucune donnée.
Cache de Partition-Réplica
Répliques de partitions (dynamiques)
- Créé lors de l'exécution lorsque des partitions sont ajoutées/supprimées
- Situé sur un serveur différent que la partition
- Aucun client ne leur parleLes clients parlent aux partitions.
Les partitions communiquent/répliquent avec les répliques.
La topologie suivante est le cache partition-réplique. C'est d'ailleurs notre topologie la plus populaire, car elle offre le meilleur des deux mondes : le partitionnement, qui assure l'évolutivité, et la réplication, qui assure la haute disponibilité. Il n'y a donc aucune perte de données. Par exemple, c'est le même principe que le cache partitionné : tout est identique, mais chaque partition possède désormais une réplique sur un serveur différent. Ainsi, la partition 1 se trouve sur le serveur 1, et sa réplique est appelée Réplique 2, qui se trouve, par exemple, sur le serveur XNUMX. Ainsi, tout comme les partitions ont été créées dynamiquement au moment de l'exécution, les répliques sont également créées lors de l'ajout ou de la suppression de partitions. Et elles sont toujours situées sur un serveur différent.
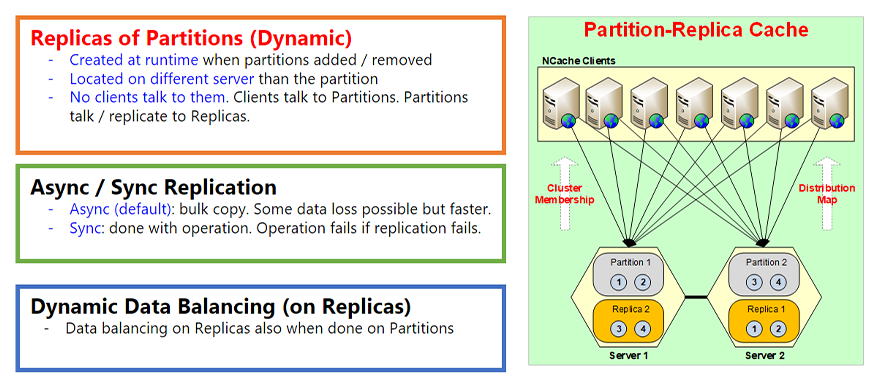
L'autre point important est que toutes les répliques sont passives. Passives signifie qu'aucun client ne communique directement avec elles. Les clients communiquent uniquement avec les partitions, qui mettent ensuite à jour leur réplique. Ainsi, chaque mise à jour d'une partition est effectuée par la partition dans la réplique. Cette mise à jour est par défaut asynchrone, ce qui la rend plus rapide. Premièrement, le client n'a pas besoin d'attendre la réplication ; deuxièmement, une réplication en masse est possible. Vous pouvez ainsi combiner des centaines, voire des milliers de mises à jour, et les déplacer ou les envoyer vers la réplique simultanément. En effet, ce transfert réseau est beaucoup plus rapide ou coûteux que la combinaison de données.
Réplication asynchrone/synchrone
- Asynchrone (par défaut)Copie en masse. Perte de données possible, mais plus rapide.
- Sync: L'opération est terminée. L'opération échoue si la réplication échoue.
Cependant, la réplication asynchrone présente évidemment un défaut de cohérence. Elle finit par l'être, ce qui est suffisant dans 95 à 99 % des cas, et dans 1 à 5 % des cas où l'on traite des données très sensibles. Il est donc préférable d'utiliser une réplication synchrone plutôt qu'une réplication asynchrone. Il existe une fonctionnalité appelée « Réplication synchrone » que vous pouvez activer. Ainsi, lorsque le client met à jour des éléments de la partition, l'opération ne se termine qu'après la mise à jour de la réplique par la partition. Ainsi, si la réplication échoue, l'opération échoue également. Ainsi, si l'opération réussit, la réplication réussit également. C'est une fonctionnalité très importante.
Équilibrage dynamique des données (sur les réplicas)
- Équilibrage des données sur les réplicas également lorsqu'il est effectué sur des partitions
Enfin, tout comme pour la topologie partitionnée et la topologie de cache partitionnée, l'équilibrage dynamique des données est également appliqué aux réplicas. Ainsi, lorsque les partitions sont équilibrées dynamiquement, les réplicas doivent s'y conformer, car ils sont toujours identiques à la partition. Ils sont donc également soumis à un équilibrage des données.
Partitionnement dynamique
Voyons rapidement comment fonctionne le partitionnement dynamique. Imaginons que vous ayez un cluster de deux serveurs contenant six éléments et que vous souhaitiez ajouter un troisième serveur. Je n'ajoute pas encore de données, car il s'agit d'un autre cas d'utilisation. Il s'agit simplement de déplacer les données vers d'autres partitions lors de l'ajout d'un nœud.
Supposons que vous ajoutiez un nœud. Il y a maintenant un troisième serveur. La partition 3 est créée et reçoit les données des partitions 3 et 1. Elle reçoit donc des données de la partition 2 et de la partition 1. Supposons que l'élément 2 de la partition 3 et l'élément 1 de la partition 4 deviennent la partition 2.
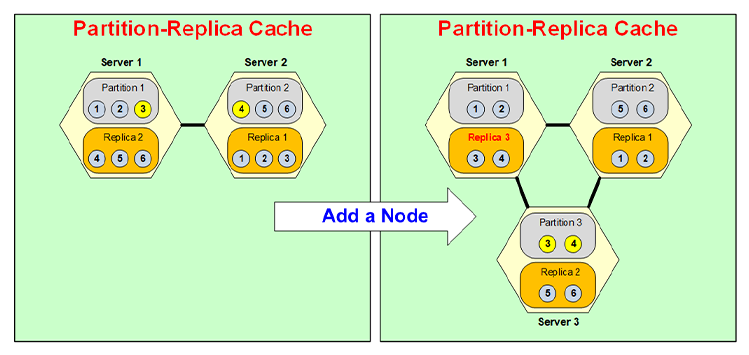
Maintenant qu'elle est devenue la partition 3, sa réplique doit être sur un serveur différent, donc, disons, elle est placée sur le serveur 1. Ainsi, le serveur 1 avait auparavant la réplique 2, il est converti en réplique 3, puis la réplique 2 est déplacée vers le serveur 3. Ainsi, par exemple, maintenant la réplique 3 contiendra 3, 4 au lieu de 4, 5, 6, et la réplique 2 contiendra 5, 6. Tout cela va être fait dynamiquement au moment de l'exécution sans que votre application ne subisse d'interruption.
La même chose se produit à l'envers : si un serveur tombe en panne, disons que vous aviez un système à trois partitions. NCache Le cluster et le serveur 3 sont tombés en panne. Soit vous les avez arrêtés, soit ils sont tombés en panne. Dès que cela se produit, car la partition 3 n'est plus disponible. La réplica 3, comme vous pouvez le voir, j'ai changé sa couleur et elle devient active. Normalement, comme je l'ai dit, les réplicas ne sont pas actifs, n'est-ce pas ? Seules les partitions sont actives, mais celle-ci devient partitionnée. Mais ce n'est que temporaire, car il est préférable d'éviter d'avoir deux partitions sur la même machine sans réplica.
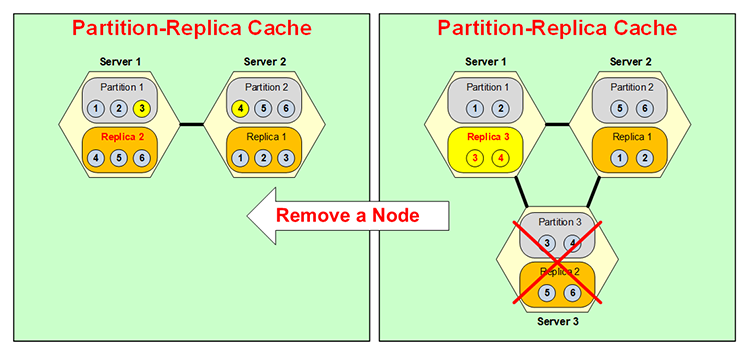
Ainsi, ceci fusionne ici avec la partition 1. Par exemple, l'élément 3 est transféré à la partition 1, l'élément 4 à la partition 2, et la situation est la suivante : la réplique 3 devient la réplique 2. Le même phénomène se produit à l'envers, tout cela à l'exécution : le partitionnement dynamique est très flexible et dynamique. Ce dynamisme ajoute la haute disponibilité de NCache.
Mode de maintenance
Bien que le partitionnement dynamique soit très utile et puissant, il existe des cas où il est préférable de ne pas repartitionner, notamment lors d'une maintenance planifiée. Imaginons que vous appliquiez un correctif au système d'exploitation, qui va interrompre le serveur pendant cinq ou dix minutes. Votre cluster de cache peut contenir des dizaines de gigaoctets de données. Il est donc déconseillé de repartitionner uniquement pendant ces cinq minutes, puis de repartitionner à nouveau lors de la remise en service du nœud. Vous pouvez donc activer une fonctionnalité de maintenance planifiée. NCache dans ce cas, lorsque vous arrêtez ce nœud, vous devez à nouveau le faire via votre outil de gestion, cela déclenche des choses qui font que cette réplique devient active mais il n'y a pas de repartitionnement.
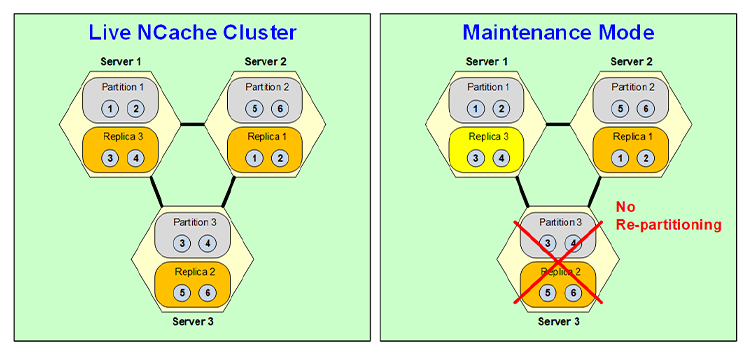
La configuration à deux serveurs reste donc la même : la Partition 1 (Réplique 3), la Partition 2 (Réplique 1). Cette Réplique 3 est en réalité la Partition 3, ce qui signifie qu'elle est active et opérationnelle. Bien sûr, la haute disponibilité n'est pas assurée, car la Partition 1 est sauvegardée, mais la Partition 2 et la Réplique 3 n'en ont pas. Ce n'est que temporaire, car vous n'en avez besoin que pendant 5 à 10 minutes. Dès que ce serveur est redevenu opérationnel, il revient à son état initial et redevient une réplique lorsque la partition redevient une partition. C'est ainsi que fonctionne la fonctionnalité de maintenance planifiée. NCache œuvres.
Cache répliqué
La topologie suivante est appelée une Cache répliquéDans cette topologie, vous pouvez avoir deux serveurs ou plus, chacun disposant d'une copie complète du cache et étant actif, ce qui signifie que des clients y sont connectés. Cependant, ici, chaque client ne se connecte qu'à un seul serveur, car ce serveur dispose de l'intégralité du cache. Il n'a donc pas besoin de se connecter à deux serveurs, comme une partition ou une réplique de partition.

Avec cette topologie, toutes les lectures sont ultra-rapides car l'intégralité du cache est centralisée. Cependant, les mises à jour doivent être effectuées de manière synchrone. Comme ces deux serveurs sont actifs, un même élément peut être mis à jour simultanément, sans risque de problème d'intégrité des données. L'exécution est synchrone : un schéma d'indexation, un index et un numéro de séquence sont attribués, et chaque élément est mis à jour dans le même ordre. Cela permet des mises à jour toujours correctes. Cependant, une mise à jour synchrone implique que si un client met à jour l'élément 1, ce serveur en informe l'élément 2. Une fois que les deux serveurs ont mis à jour l'élément 1 avec succès, la mise à jour est réussie et le contrôle est rétabli. Ce n'est donc pas aussi rapide qu'une topologie de partition ou de réplication de partition, mais l'opération est garantie. Si la mise à jour réussit, elle est appliquée à tous les serveurs.
Cette topologie est idéale pour les opérations de lecture intensive. Pour un cluster à deux serveurs, même les écritures sont assez rapides, certes moins rapides qu'une réplication de partition, mais raisonnablement rapides dans la plupart des situations. Cependant, plus vous ajoutez de serveurs, plus les performances des mises à jour diminuent. En réalité, elles ralentissent car davantage de serveurs doivent être mis à jour de manière synchrone. Cette topologie a donc ses propres avantages, c'est pourquoi nous la conservons. Nombre de nos clients l'utilisent dans des situations particulières.
Cache en miroir
La quatrième topologie est appelée la Cache en miroirIl s'agit là encore d'une topologie très spécifique. Elle ne comporte que deux nœuds. On distingue un nœud actif et un nœud passif. Le nœud actif dispose de l'intégralité du cache, et une copie de ce cache est stockée sur le nœud passif. Tous les clients se connectent au nœud actif et mettent à jour le nœud actif pour tous leurs éléments. Ces mises à jour sont mises en miroir ou répliquées de manière asynchrone sur le nœud passif. Ce caractère asynchrone signifie également une grande rapidité, tout comme Partition Replica.

Dans cette topologie, si un nœud actif tombe en panne, le nœud passif redevient automatiquement actif et tous les clients migrent automatiquement vers le nœud passif ou le nœud nouvellement actif. Ainsi, il n'y a aucune interruption, et c'est ce que j'entends par là : le basculement automatique. Et lorsque le nœud actif redémarre, il redevient actif, et le même phénomène se produit, mais en sens inverse.
La topologie miroir est également très utile pour des cas spécifiques. Elle n'est pas évolutive au-delà de ces deux serveurs, mais elle présente un intérêt particulier car tous les clients s'y connectent, ce qui permet de créer une réplique sur une autre machine. Cela pourrait notamment être utile en cas de reprise après sinistre.
Persistance en direct
Une autre fonctionnalité très puissante de NCache est appelé Persistance en directLa persistance en direct est disponible uniquement pour les topologies de partitions et de réplicas de partitions. Elle est en direct, ce qui signifie que lorsque vous mettez à jour le cache à l'exécution, le magasin de persistance est également mis à jour immédiatement. La mise à jour du magasin de persistance est asynchrone. Elle n'interfère donc pas avec les performances de votre application. NCache Les performances. C'est ainsi que votre application peut rester très rapide. La persistance est gérée au niveau des compartiments. Il y a donc 100 compartiments qui représentent l'intégralité du cache et qui sont stockés dans un système de stockage de documents NoSQL. Il s'agit d'un système de stockage basé sur des fichiers, et non sur un serveur. Ce n'est pas un serveur de base de données NoSQL, mais un système de stockage de documents NoSQL. NCache utilisations. Vous pouvez l'utiliser dans un emplacement commun à tous les serveurs du NCache cluster, et de cette façon, ils peuvent tous s'appuyer sur le même magasin persistant.
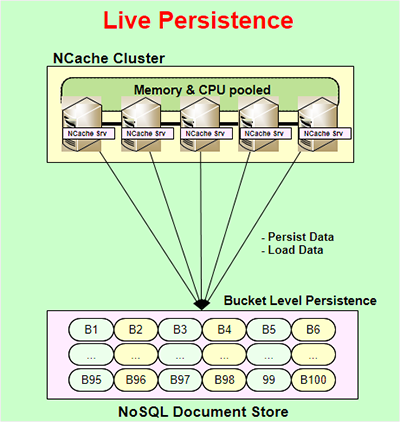
L'un des avantages de cette fonctionnalité, et la raison d'être de cette fonctionnalité, est qu'elle permet, par exemple, de conserver l'intégralité du cache, quel que soit le contenu persistant. Ainsi, les modifications apportées au cache sont conservées, à quelques millisecondes près, dans la mémoire persistante. Vous pouvez ainsi les recharger dans un autre cache, ou redémarrer les serveurs depuis les mémoires persistantes en cas de panne. Aucune donnée n'est perdue, sauf une infime quantité. Vous pouvez également transférer facilement le cache d'un environnement à un autre.
L'autre avantage est qu'il renforce la haute disponibilité des topologies de partitions et de réplications de partitions. J'y reviendrai plus en détail. Comme je l'ai mentionné précédemment, le cache partitionné ne propose aucune réplication. Ainsi, si une partition ou un serveur tombe en panne, vous perdez cette partition. En revanche, si la persistance est activée, ce n'est pas le cas. En effet, une copie de ces données est également conservée dans ces buckets. Ainsi, si ce serveur tombe en panne, les buckets en mémoire sont réaffectés, sans données, à d'autres serveurs. Ces derniers savent alors que ces buckets sont vides et que leurs données sont stockées dans le magasin de persistance. Ils rechargent donc ces données depuis ce magasin.
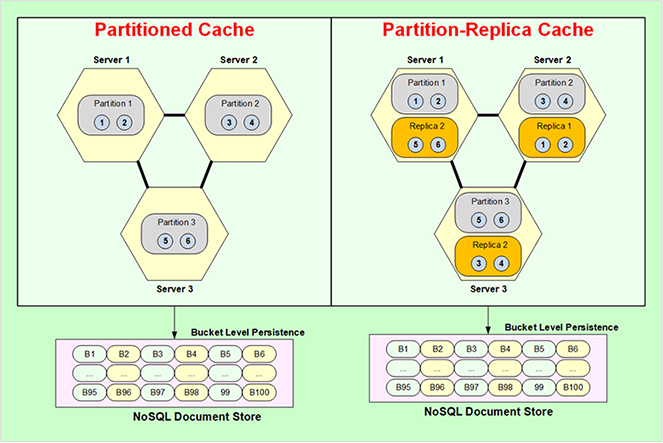
Ainsi, vous ne perdez aucune donnée même en cas de panne d'un serveur, même avec le cache partitionné. De plus, vous bénéficiez des mêmes avantages qu'une réplication de partition.
L'avantage ici est de pouvoir utiliser plus de mémoire. Vous pouvez stocker plus de données dans le cache, car vous devez allouer plus de mémoire à la réplication, ce qui n'est pas obligatoire, mais nécessite l'allocation du magasin de persistance. C'est l'avantage du cache partitionné. Le mode Partition-Replica présente également un avantage. Il est intéressant de noter que, même si ce mode offre déjà une haute disponibilité, cette haute capacité ne se produit qu'en cas de panne d'un serveur à un moment donné. Par exemple, si deux serveurs tombent en panne simultanément sans persistance, même avec Partition-Replica, vous perdriez des données. En effet, il n'existe qu'une seule copie de chaque partition, et si deux serveurs tombent en panne, vous en perdriez plus que vous ne pouvez vous le permettre. Avec la persistance, aucun problème : vous pouvez simplement recharger toutes les données depuis le magasin de persistance.
Évidemment, dans les deux cas, il faut garder à l'esprit que lorsque vous chargez des données depuis le magasin de persistance, vous aviez trois serveurs et vous en avez maintenant deux. Les données peuvent être trop volumineuses pour tenir sur les deux serveurs ; un autre problème peut se poser : vous devez vous assurer que ces deux serveurs restants disposent de suffisamment de mémoire pour accueillir l'équivalent des trois serveurs. C'est donc la seule limite. Par ailleurs, la persistance apporte une réelle valeur ajoutée aux caches partitionnés et réplica de partition.
Cache Client
D'accord, une autre fonctionnalité très importante de NCache est appelé Cache ClientCela vous permet d'accélérer les processus dans un environnement de stockage distribué. Par exemple, vous disposez d'un environnement distribué. NCache Votre application s'exécute ici. Il s'agit généralement d'un cache placé au-dessus de votre base de données ou de toute autre activité. Un cache client est généralement utilisé dans un scénario de cache distribué. Il s'agit d'un cache placé au-dessus de ce cluster de cache, situé très près de votre application. Il se trouve sur le serveur d'applications ou NCache Boîte client. Il peut même s'agir d'une procédure entrante ou sortante, selon vos préférences. Un cache InProc est ultra-rapide, car il conserve les données sous forme d'objet désérialisé sur votre tas. C'est comme si cet objet était sur votre tas, mais avec une vitesse encore plus élevée.

Ainsi, un cache InProc est ultra-rapide mais en même temps, sa beauté est qu'il est synchronisé avec le NCache Cluster. La synchronisation est assurée par le cluster, qui connaît tout ce qui est conservé dans le cache client. Ainsi, si un élément de ce cache client est mis à jour par un autre client du cluster, celui-ci informe ce cache client de se mettre à jour. Ce cache client se met alors à jour de manière asynchrone. Il y a évidemment un délai de quelques millisecondes, mais comme je l'ai dit, la cohérence finale est le modèle dans la plupart des cas, et elle est généralement acceptable dans 99 % des cas.
Si cela n’est pas acceptable, alors NCache La synchronisation optimiste est la valeur par défaut, avec un délai de quelques millisecondes. Il est donc possible que vos données soient obsolètes, ce qui est acceptable dans 99 % des cas, comme je l'ai dit. Mais si ce n'est pas le cas et que vos données sont très sensibles, mais que vous souhaitez tout de même utiliser le cache client, vous pouvez utiliser une synchronisation pessimiste. Avant que votre application ne récupère quoi que ce soit du cache client, celui-ci vérifie uniquement s'il existe une version plus récente de ces données. C'est plus rapide que d'obtenir les données elles-mêmes, car… NCache Il conserve ensuite plusieurs informations de version. Si une version plus récente de ces données est disponible, le cache client la récupère ; sinon, il la renvoie directement depuis le cache client.
Un cache client utilisable sans modification de code. Il s'intègre simplement à votre environnement et est idéal pour les situations de lecture intensive. Pour les lectures fréquentes, un rapport d'au moins 5:1 est idéal, mais en cas de rapport 10:1, par exemple pour les sessions web, le cache client est totalement inefficace. En fait, il est fortement déconseillé.
Réplication WAN
Multi-Zone / Multi-Région
Ok, une autre partie de NCache est le où NCache cela Réplication WAN Pour gérer le déploiement multizone ou multirégional de vos applications. Par exemple, vous pourriez déployer votre application sur deux sites distincts pour la reprise après sinistre, l'un étant actif, l'autre passif. Et vous avez cette application, NCache Il est en cours d'exécution, et une application est inactive. Cependant, vous souhaitez vous assurer qu'en cas de panne du site, celui-ci puisse immédiatement prendre en charge la charge. Vous pouvez donc installer un pont. Un pont est un cluster à deux nœuds pouvant être installé sur les mêmes machines que le serveur. NCache Le cache principal, ou un cache dédié distinct, à vous de choisir. Ensuite, tout ce que vous mettez à jour dans ce cache est répliqué de manière asynchrone sur le WAN vers l'autre cache. C'est donc la configuration active-passive.

Vous pouvez faire la même chose avec un système actif-actif. Imaginons que même ce site soit actif, que faire exactement avec un système actif-actif où les deux sites peuvent se mettre à jour mutuellement ? Dans ce cas, un conflit peut survenir. Un conflit signifie que le même élément, la même clé, est mis à jour simultanément sur les deux sites. Dans ce cas, le pont applique par défaut la logique « la dernière mise à jour l'emporte ». Ainsi, la mise à jour la plus récente est la plus importante. Par exemple, vous pouvez également fournir un gestionnaire de résolution de conflits, utilisant votre code .NET ou Java, appelé par le pont. Ce dernier transmettra les deux copies des données ou de l'objet à ce gestionnaire. Vous pourrez ensuite analyser le contenu pour déterminer lequel est le plus correct. Vous pourrez alors décider que cette mise à jour l'emporte et qu'elle est appliquée aux deux sites. Tant que cette mise à jour est appliquée aux deux parties, il n'y a pas de conflit.
Le NCache Il est possible de vous proposer trois sites ou plus en mode actif-actif, actif-passif, ou une combinaison des deux. Par exemple, il vous faut au moins un site actif, mais tous ces sites peuvent être passifs, actifs ou une combinaison des deux. De même, la présence de plusieurs sites actifs peut être source de conflit.

Conteneurs (Docker et Kubernetes)
Enfin, les conteneurs Docker et Kubernetes sont devenus très populaires. Donc, NCache Ils les prennent évidemment en charge, car ils sont encore plus populaires sous Java et Linux que sous .NET et Windows, mais je suis sûr que cela va changer avec le temps. Quoi qu'il en soit, NCache est parfaitement capable de gérer les deux environnements. Voici, par exemple, un exemple typique Déploiement de Kubernetes NCache.

Voici un NCache déploiement. Il y a NCache possède son propre service de découverte. Ce sont des pods évolutifs, et des applications au sein du cluster Kubernetes. NCache Clients, notamment Azure, AKS, AWS, EKS, Google GKE ou Red Hat OpenShift. Red Hat OpenShift est généralement un autre cloud comme AWS, Azure ou Google, ou peut-être un autre cloud. NCache prend en charge tous ces éléments. Ce pod pourrait être Linux, ce qui est le cas le plus courant dans Kubernetes. NCache Cela fonctionne parfaitement. L'application peut être Linux ou Windows. Donc, il peut s'agir de Linux ou Windows, ou Linux ou Windows.
Docker / Kubernetes (Multi-Zone)
De la même manière que la réplication WAN intervient, si vous souhaitez, par exemple, disposer de plusieurs zones de disponibilité grâce au cloud, comme par exemple un Kubernetes multizone.

Nous vous recommandons donc de créer un cluster Kubernetes et d'en avoir deux. NCache Les déploiements peuvent être actifs-actifs ou actifs-passifs. Le pont peut alors être entièrement déployé ici ou ici. On peut même avoir un pont divisé : une partie est sur une zone et l'autre sur une autre, la réplication étant alors asynchrone.
Je pense que cela résume bien le sujet d'aujourd'hui. Je vous recommande vivement de visiter notre site web et d'y jeter un œil. NCache cour de récréation qui est vraiment un moyen très rapide et facile à partir de votre navigateur pour utiliser une copie en direct de NCache, et vous pouvez même obtenir un 2-Node NCache Cluster avec tous les outils sans aucune installation. Ou, si vous êtes prêt, venez ici ! s'inscrire et télécharger non plus NCache Édition Entreprise pour .NET ou NCache Édition Enterprise pour Java. Comme je l'ai dit, vous pouvez obtenir le fichier .tar.gz pour Linux, le fichier .msi, ou encore l'image Docker. Il vous suffit de télécharger une image Docker. NCacheVoilà qui conclut ma présentation. Merci beaucoup.