Recupero del cluster di cervello diviso per un uptime del 100%
NCache È una cache distribuita in memoria estremamente veloce e scalabile per .NET, Java, Python e Node.js. È ampiamente utilizzata in produzione per applicazioni mission-critical. Per garantire elevata disponibilità e uptime del 100%, NCache Offre un ricco set di funzionalità ad alta disponibilità. Una di queste è la capacità di rilevare e risolvere gli Split Brain in un cluster per prevenire qualsiasi downtime.
Cos'è uno Split Brain Cluster?
NCache crea a cluster di cache dinamica autoriparante costituito da più server che comunicano tra loro tramite TCP. Tutti i server cache sono interconnessi nel cluster. La sua appartenenza viene mantenuta in fase di esecuzione e condivisa sia con i server che con i client.
Tuttavia, come ogni sistema distribuito, il NCache Un cluster può trovarsi in una situazione in cui uno o più server cache vengono disconnessi dal resto dei server del cluster, pur essendo ancora in esecuzione. Ciò si verifica solitamente a causa di problemi di rete.
Quando ciò accade, ogni set di server cache si considera il server superstite del cluster cache originale e presume che gli altri server cache siano disattivati. Da qui il termine "Split Brain", che in termini medici significa che il lato sinistro del cervello non è a conoscenza del lato destro. Anche i client cache possono essere divisi in modo simile o continuare a comunicare con tutti i server cache in base all'appartenenza al cluster originale.
Senza un meccanismo di ripristino automatizzato, gli scenari split-brain portano a incoerenze nei dati e conflitti di integrità, poiché due set indipendenti di client aggiornano simultaneamente versioni diverse degli stessi dati.
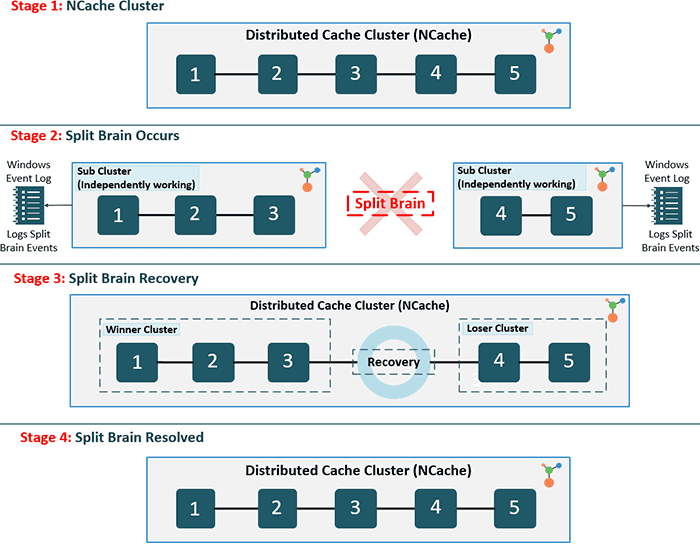
Dividi il cervello nel cluster di cache

Ciò porta ad errori in operazioni di cache e, cosa più importante, problemi di integrità dei dati. Ogni "cluster diviso" ora ha una propria copia di dati che viene aggiornata in modo indipendente dai client. E si finisce per avere due o più copie degli stessi dati aggiornate senza alcuna sincronizzazione, causando incongruenze.
Come NCache Rileva il cervello diviso in cluster distribuiti?
NCache ha la capacità di rilevare automaticamente quando si verifica un cluster Split Brain. Normalmente, l'amministratore della cache utilizza NCache Centro di gestione o il necessario Cmdlet di PowerShell Per rimuovere un server cache dal cluster, questi eventi vengono registrati. Pertanto, nel caso di un cervello diviso, ogni sottocluster registra gli eventi al registro eventi di Windows che indica che alcuni dei suoi membri originali se ne sono andati. Quindi, in caso di Split Brain, il NCache l'amministratore vede gli eventi "nodo rimasto" per quasi tutti i server cache e tenta di riconnettersi con i "server persi".
Solo quando la connessione di rete tra i sottocluster divisi viene ripristinata, si scopre che si è verificato uno Split Brain. A quel punto, ogni sottocluster registra gli eventi nel registro eventi di Windows e ne informa anche l'amministratore della cache tramite un notifica per email che si è verificato uno Split Brain.
Come si confronta la NCache Funzione di recupero automatico del cervello diviso?
Abilita il recupero Split Brain tramite config.ncconf aggiungendo il file tag sotto il Tag. Se impostato su True, il tag può rilevare possibili problemi di cluster split-brain. Tuttavia, è disponibile solo nella topologia Partition-Replica.
<cache-settings...>
  <split-brain-recovery enable="True" detection-interval="60"/>
</cache-settings>
Durante la fase di rilevamento, NCache utilizza heartbeat basati su TCP per monitorare lo stato di salute dei nodi. Se si verifica una partizione di rete, il cluster identifica la suddivisione in base alla configurazione intervallo di rilevamentoUna volta rilevato, NCache applica la regola del nodo di maggioranza o la regola del cluster complesso per determinare il "vincitore".
NCache determina il Cluster Vincitore in base a questi criteri:
- Regola della maggioranza: Il sottocluster con il numero più alto di nodi viene designato vincitore.
- Regola della complessità: Se il numero di nodi è uguale, vince il sottocluster con la configurazione interna e la connettività più complesse.
Se l'utente ha configurato il ripristino automatico in uno scenario split brain, tutti i sottocluster negoziano tra loro per determinare il "vincitore". Dopodiché, gli altri sottocluster si uniscono a questo cluster eliminando i propri dati e comportandosi come se fossero nuovi nodi che si uniscono a un cluster esistente.
Le regole utilizzate per determinare quale sottocluster dovrebbe vincere sono semplici. È il sottocluster con il maggior numero di nodi membri. E, se più sottocluster hanno lo stesso numero di nodi membri, vince quello con l'indirizzo IP del coordinatore più piccolo.