100% の稼働率を実現するスプリット ブレイン クラスタ リカバリ
NCache は、.NET、Java、Python、Node.js向けの非常に高速でスケーラブルなインメモリ分散キャッシュです。ミッションクリティカルなアプリケーションの運用現場で広く利用されています。高可用性と100%の稼働率を保証するために、 NCache 豊富な高可用性機能を提供します。その一つが、クラスタ内のスプリットブレインを検出・解決し、ダウンタイムを防止する機能です。
スプリットブレインクラスターとは何ですか?
NCache を作成します 自己修復動的キャッシュクラスター TCPを介して相互に通信する複数のサーバーで構成されます。すべてのキャッシュサーバーはクラスター内で相互接続されています。そのメンバーシップは実行時に維持され、サーバーとクライアントの両方で共有されます。
しかし、他の分散システムと同様に、 NCache クラスタでは、1台以上のキャッシュサーバーが稼働中に、クラスタ内の他のサーバーから切断される状況が発生する可能性があります。これは通常、ネットワークの不具合が原因で発生します。
このような状況が発生すると、各キャッシュサーバー群は、自分たちが元のキャッシュクラスターの生き残ったサーバーであると認識し、他のキャッシュサーバーがダウンしたと想定します。これが「スプリットブレイン」と呼ばれる現象です。これは医学用語で、脳の左側が右側の情報を認識していない状態を意味します。キャッシュクライアントも同様に分割されるか、元のクラスターのメンバーシップに基づいてすべてのキャッシュサーバーと通信を継続する可能性があります。
自動回復メカニズムがないと、独立した 2 セットのクライアントが同じデータの異なるバージョンを同時に更新するため、スプリット ブレイン シナリオではデータの不整合と整合性の競合が発生します。
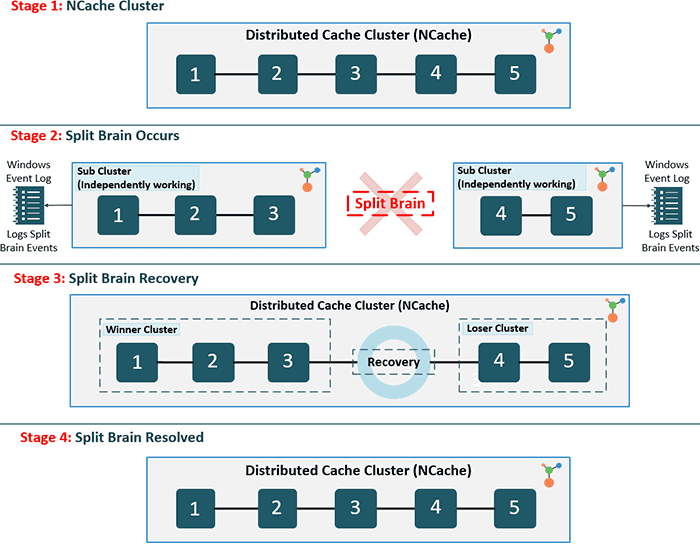
キャッシュクラスターのスプリットブレイン

これにより、 キャッシュ操作 そして最も重要なのは、データの整合性の問題です。各「分割クラスタ」は、クライアントによって個別に更新されるデータのコピーを独自に持つことになります。その結果、同じデータの複数のコピーが同期されずに更新され、不整合が発生します。
認定条件 NCache 分散クラスター内のスプリット ブレインを検出しますか?
NCache スプリットブレインクラスタの発生を自動的に検出する機能があります。通常、キャッシュ管理者は NCache 管理センター または必要な PowerShellコマンドレット キャッシュサーバーをクラスタから削除する場合、これらのイベントがログに記録されます。したがって、スプリットブレインの場合、各サブクラスタは イベントをログに記録 Windowsイベントログに、元のメンバーの一部が離脱したことを示すメッセージが記録されます。つまり、スプリットブレインの場合、 NCache 管理者は、ほぼすべてのキャッシュ サーバーで「ノード離脱」イベントを確認し、「失われたサーバー」との再接続を試みます。
分割されたサブクラスタ間のネットワーク接続が回復した場合にのみ、スプリットブレインが発生したことが検出されます。その際、各サブクラスタはWindowsイベントログにイベントを記録し、キャッシュ管理者に通知します。 電子メール通知 スプリットブレインが発生したこと。
どのように NCache スプリットブレイン自動回復機能?
スプリットブレインリカバリを有効にするには config.ncconf を追加して 下のタグ タグ。このタグをTrueに設定すると、クラスタのスプリットブレイン問題の可能性を検出できます。ただし、これはパーティション・レプリカ・トポロジでのみ有効です。
<cache-settings...>
  <split-brain-recovery enable="True" detection-interval="60"/>
</cache-settings>
検出段階では、 NCache TCPベースのハートビートを使用してノードの健全性を監視します。ネットワーク分割が発生した場合、クラスタは設定された値に基づいて分割を識別します。 検出間隔一度検出されると、 NCache 多数ノードルールまたは複合クラスタールールを適用して、「勝者」を決定します。
NCache 以下の基準に基づいて勝者クラスターを決定します。
- 多数決: 最も多くのノードを持つサブクラスターが勝者として指定されます。
- 複雑さのルール: ノード数が等しい場合、最も複雑な内部構成と接続性を持つサブクラスターが優先されます。
ユーザーがスプリットブレインシナリオで自動回復を設定している場合、すべてのサブクラスタは互いにネゴシエーションを行い、「勝者」を決定します。これが完了すると、他のサブクラスタはデータを破棄し、既存のクラスタに参加する新しいノードのように動作することで、このクラスタに参加します。
どのサブクラスタが優先されるかを決定するルールはシンプルです。メンバーノード数が最も多いサブクラスタが優先されます。また、複数のサブクラスタのメンバーノード数が同数の場合は、コーディネーターのIPアドレスが最も小さいサブクラスタが優先されます。