데이터가 계속해서 엄청난 가치를 지니면서, Apache Lucene은 역색인을 사용하여 방대한 양의 텍스트 데이터를 효율적으로 검색하는 능력으로 유명한 선도적인 풀텍스트 검색 엔진으로 부상했습니다. 그러나 독립형 솔루션인 Lucene은 데이터 볼륨이 증가함에 따라 확장성 문제가 발생하여 성능을 크게 저하시킬 수 있는 빈번한 인덱스 재구성이 필요합니다. Java 및 REST 기반 대안은 이제 풀텍스트 검색을 위한 확장 가능한 옵션을 제공하지만, .NET 스택은 여전히 이 중요한 기능을 위한 완벽하게 통합되고 확장 가능한 솔루션이 부족합니다.
분산 Lucene 사용 NCache .NET 용
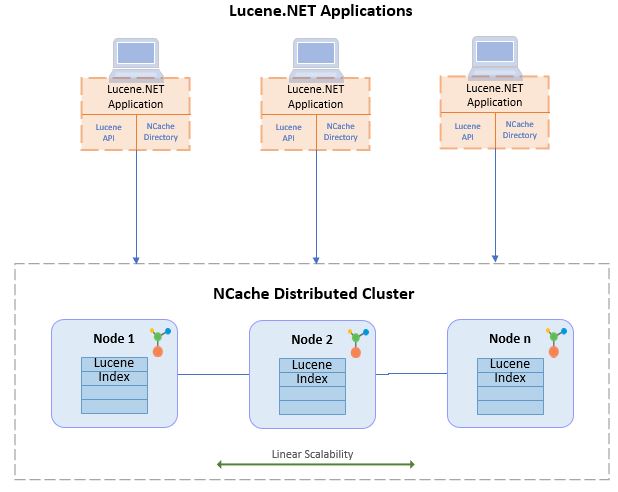
NCache강력하고 인기 있는 .NET 인메모리 데이터 저장소인 .NET은 분산 아키텍처에 네이티브 Lucene.NET API를 구현했습니다. 표준 Lucene.NET API이므로 확장 가능한 방식으로 사용하기 위해 코드를 변경할 필요가 없습니다. NCache.
NCache 또한 동적으로 확장 가능한 환경에서 인덱스를 생성하기 위해 Lucene.NET을 활용합니다. 분산된 전체 텍스트 검색. 이러한 검색 결과는 애플리케이션으로 다시 전송되기 전에 병합됩니다. 이를 통해 독립형 Lucene이 빠르고 선형적으로 확장 가능한 전체 텍스트 검색 솔루션으로 향상됩니다.
이를 통해 단독 Lucene이 빠르고 선형적으로 확장 가능한 전체 텍스트 검색 솔루션으로 강화됩니다.
.NET 앱에서 Lucene 사용
수천 개의 제품, 주문 및 고객 세부 정보에 대한 정보를 보관하는 전자상거래 사이트를 고려해 보겠습니다. 따라서 모든 속성, 특히 검색하는 동안 사용되지 않는 비텍스트 필드를 인덱싱하는 것은 캐시 메모리를 고갈시키기 때문에 현명한 방법이 아닙니다.
예를 들어 제품에 대한 문서는 다음과 같습니다.
|
1 2 3 4 5 6 7 8 |
{ “ID”: “ABC34”, “Name”: “Tupperware”, “Description”: “Microwaveable, dishwasher-friendly, reusable Tupperware in three sizes”, “RetailPrice”: 15.00, “Discount”: 3.00 } |
이제 우리는 클라이언트가 문서 내의 제품 설명 필드에 대해 특히 전체 텍스트 검색을 수행한다는 것을 알고 있습니다. 이 프로세스를 최적화하기 위해 검색 가능한 필드만 인덱싱하고 데이터베이스나 파일 시스템과 같은 지속성 저장소의 해당 문서로 다시 연결되는 키와 연관시키는 것을 제안합니다. 예를 들어, "식기 세척기 친화적인 터퍼웨어"와 같은 제품을 쿼리할 때 이러한 용어와 일치하는 모든 관련 제품은 해당 제품 ID가 문서 키로 사용되어 검색됩니다. 그런 다음 전체 문서를 지속성 있는 인덱스에서 효율적으로 페치하여 검색 작업을 간소화할 수 있습니다.
기존 애플리케이션에서 Distributed Lucene을 사용하려면 다음 사항을 지정하면 됩니다. NCache디렉토리를 열 때 디렉토리. 이것은 필요합니다 NCache 캐시 이름과 인덱스 이름. 다음 코드 스니펫은 캐시 LuceneCache에서 디렉토리를 엽니다. NCache 및 ProductIndex라는 색인이 있습니다.
|
1 2 3 4 5 6 |
// Specify the cache name and index path for Lucene string cache = "LuceneCache"; string index = "ProductIndex"; // Create directory and open it on the cache Directory directory = NCacheDirectory.Open(cache, index); |
Lucene은 주어진 문자열을 Lucene 쿼리로 해석하는 광범위한 쿼리 언어를 제공합니다. 이는 용어, 다중 용어, 와일드카드 또는 퍼지 단어에 대해 수행할 수 있습니다. Lucene 쿼리에 대해 자세히 알아보려면 Lucene 쿼리 문서.
다음 코드 조각은 IndexSearcher에서 사용하는 디렉토리에 IndexReader를 만듭니다. 데이터는 StandardAnalyzer를 기반으로 분석되고 토큰화됩니다. 결과의 첫 50개 히트가 애플리케이션으로 반환됩니다. 분석기는 인덱스 생성 중에 사용된 것과 동일해야 합니다.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
// The 'applyAllDeletes' is true so all enqueued deletes are applied on writer IndexReader reader = DirectoryReader.Open(indexWriter, true); // A searcher is opened to perform searching IndexSearcher indexSearcher = new IndexSearcher(reader); // Specify the searchTerm, fieldName and analyzer string searchTerm = "Beverages"; string fieldName = "Category"; // Note that the analyzer should be same as the one used during index creation Analyzer analyzer = new StandardAnalyzer(LuceneVersion.LUCENE_48); // Create a query parser to parse the query QueryParser parser = new QueryParser(LuceneVersion.LUCENE_48, fieldName, analyzer); Query query = parser.Parse(searchTerm); // Returns the top 50 hits from the result set ScoreDoc[] docsFound = indexSearcher.Search(query, 50).ScoreDocs; reader.Dispose(); |
분산 인덱스를 구축하기 위해 데이터 로드
Lucene을 사용하면 인덱스를 빌드하고 필요에 따라 데이터를 로드할 수 있습니다. 인덱스에는 필요에 따라 데이터를 분석하고 토큰화하는 분석기가 필요합니다. 여기에는 공백, 비문자, 구두점 등이 포함됩니다. Lucene 인덱스에 대한 작성자를 만들면 문서를 만들고 필드를 추가할 수 있습니다. 그런 다음 이 문서는 다음에서 인덱싱됩니다. NCache Commit()을 호출하면 분산 인덱스로 사용됩니다. Lucene 분석기에 대한 자세한 내용은 다음을 참조하세요. Lucene 분석기 문서.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 |
// Specify the cache name and index path for Lucene string cache = "LuceneCache"; string indexPath = "ProductIndex"; // Create directory and open it on the cache Directory directory = NCacheDirectory.Open(cache, indexPath); // The same analyzer is used as for the reader Analyzer analyzer = new StandardAnalyzer(LuceneVersion.LUCENE_48); IndexWriterConfig config = new IndexWriterConfig(LuceneVersion.LUCENE_48, analyzer); // Create indexWriter on NCache directory IndexWriter indexWriter = new IndexWriter(directory, config); Product[] products = FetchProductsToIndex(); foreach (var product in products) { Document doc = new Document { new StoredField("id", product.ID), new TextField("name", product.Name, Field.Store.YES), new TextField("description", product.Description, Field.Store.YES), new StringField("category", product.Category, Field.Store.No), new StoredField("retail_price", product.RetailPrice), }; indexWriter.AddDocument(doc); } indexWriter.Commit(); |
NCache 분산 Lucene을 위해?
사용 NCache Distributed Lucene을 사용하면 다음과 같은 이점을 얻을 수 있습니다.
- 매우 빠르고 선형적으로 확장 가능: NCache 인 메모리 분산 데이터 저장소이므로 구축 분산된 Lucene 또한 전체 텍스트 검색에 대해 동일한 최적의 성능을 제공합니다. 게다가 때문에 NCache분산 아키텍처에서 Lucene 인덱스는 클러스터의 모든 서버에 분할됩니다. 데이터 부하가 증가함에 따라 이동 중에 더 많은 서버를 추가할 수 있으므로 확장이 가능하고, Lucene 인덱스는 클라이언트 개입 없이 자동으로 재분배됩니다.
- 안정성 및 고가용성을 위한 데이터 복제: 와 NCache'의 Partition-Replica 토폴로지에서 Lucene 인덱스는 모든 서버에 걸쳐 분할될 뿐만 아니라 각 파티션도 클러스터의 다른 서버에 복제됩니다. 따라서 서버가 다운되면 파티션의 복제본이 해당 인덱스에 대한 모든 쿼리를 처리하여 안정성을 보장합니다. 마찬가지로 서버 노드가 다운되면 NCache 동적으로 자가 치유 중단 시간이나 Lucene 인덱스에 대한 영향 없이 나머지 노드 내의 데이터를 재조정하여 고가용성을 보장합니다.
맺음말
요약하자면, 강력한 검색 엔진 Lucene 덕분에 전체 텍스트 검색은 이제 거의 모든 비즈니스에서 기본이 되었습니다. 그러나 데이터가 증가함에 따라 인덱스를 재구성하면 이득보다 피해가 더 클 수 있으며, 여기서 메모리 내 분산 .NET 솔루션(예: NCache 필요한 것은 기존 Lucene 애플리케이션에서 한 줄의 코드만 변경하면 메모리 내 분산 전체 텍스트 검색 메커니즘으로 두 가지 장점을 모두 누릴 수 있다는 것입니다.