분산 캐시와 함께 SQL 쿼리 사용
저자: 이크발 칸
NCache 중간 계층에 분산 캐시를 생성하여 데이터베이스 접속에 드는 비용을 줄이고 애플리케이션 성능을 크게 향상시킬 수 있습니다. 또한, 단일 데이터베이스 서버에 의존하는 대신, 자주 액세스하는 데이터를 확장성이 뛰어난 캐시에서 제공함으로써 확장성을 향상시킵니다.
애플리케이션은 일반적으로 캐시를 해시 테이블로 사용하는데, 여기에는 모든 것이 키 기반으로 저장되고 항목을 가져오려면 이 키가 필요합니다. 이는 기본 키만 사용하여 데이터를 찾을 수 있는 관계형 데이터베이스와 같습니다. 이 방법은 많은 경우에 효과적이지만, 복잡한 애플리케이션에서는 일반적으로 기본 키 이외의 속성을 기반으로 데이터를 검색해야 합니다. 또한 많은 데이터를 캐시에 보관하므로 이러한 방식으로 캐시를 검색할 수 있다면 매우 유용할 것입니다. NCache 바로 그런 시설을 제공합니다.
이 기사에서는 SQL 쿼리가 어떻게 작동하는지 설명합니다. NCache.
SQL 쿼리 실행 NCache
NCache 당신은 할 수 있습니다 질문 캐시된 데이터를 사용하여 SQL과 유사한 구문기본 키에만 의존하는 대신, ProductID, Category, Price와 같은 특정 속성을 기준으로 캐시된 객체를 필터링할 수 있습니다. 다음 코드는 .NET 애플리케이션에서 캐시 쿼리를 수행하는 방법을 보여줍니다.
// Precondition: Cache is already connected
// Items are already present in the cache
// Create a query that will be executed on the dataset
// Use the Fully Qualified Name (FQN) of your own custom class
string query = "SELECT * FROM FQN.Product WHERE ProductID > ?";

// Use QueryCommand for query execution
var queryCommand = new QueryCommand(query);

// Providing parameters for query
queryCommand.Parameters.Add("ProductID",50000);

// Executing QueryCommand through ICacheReader
ICacheReader reader = cache.SearchService.ExecuteReader(queryCommand, false, 0);

// Check if the result set is not empty
if (reader.FieldCount > 0)
{
    while (reader.Read())
    {
        string result = reader.GetValue<string>(0);
        // Perform operations using the retrieved keys
    }
}
else
{
    // Null query result set retrieved
}
위 코드는 캐시에서 매개변수화된 쿼리를 실행하여 ProductID가 50000보다 큰 제품을 찾습니다. QueryCommand를 사용하여 쿼리와 해당 매개변수를 전달합니다. ExecuteReader 일치하는 키를 검색하려면 다음을 수행합니다. ICacheReader루프는 각 결과를 하나씩 읽어서 전체 데이터를 한 번에 로드하지 않고도 일치하는 항목에 대한 효율적인 반복을 가능하게 합니다. 개별 객체가 필요한 경우, 각 키를 사용하는 별도의 가져오기 작업이 필요합니다.
검색 외에도, NCache 또한 다음을 사용하여 캐시된 데이터를 삭제할 수 있습니다. SQL과 유사한 DELETE 쿼리. 그러나 INSERT 및 UPDATE 작업은 현재 지원되지 않습니다.
검색 가능한 속성 인덱싱
참고하여 주시기 바랍니다 NCache 검색 가능한 모든 속성을 인덱싱해야 합니다. 인덱싱을 하지 않고, NCache 사용자가 찾고 있는 항목을 찾으려면 전체 캐시를 탐색해야 합니다. 이는 매우 비용이 많이 드는 작업이며, 전체 캐시 속도를 저하시키고 사람들이 사용하는 주된 이유를 무효화할 가능성이 있습니다. NCache즉, 애플리케이션 성능과 확장성을 높이는 것입니다.
NCache 이러한 인덱스를 정의하는 두 가지 방법을 제공합니다.
- 인덱스 정의 프로그래밍 방식으로.
- 구성 정적 인덱스를 통해 NCache 관리센터.
다양한 캐싱 토폴로지 쿼리
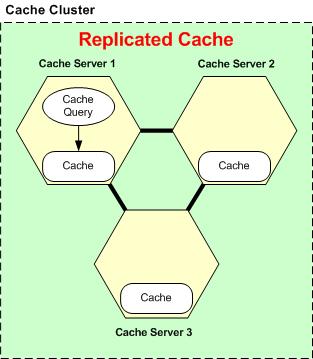
클라이언트 애플리케이션 관점에서 검색 동작은 사용하는 캐싱 토폴로지에 관계없이 동일하지만, 기본 검색 동작은 토폴로지마다 다릅니다. 예를 들어 복제된 캐시를 검색하는 경우, 검색은 검색을 시작한 캐시 서버에서만 수행됩니다. 전체 캐시가 해당 서버에서 사용 가능하기 때문입니다. 쿼리가 실행되는 방식은 다음과 같습니다. 복제된 캐시.
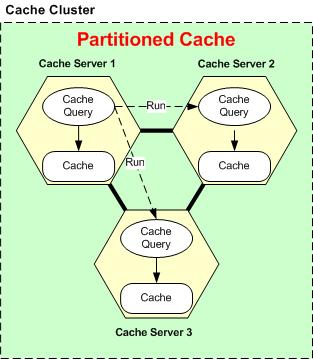
그러나 파티션 된 or 파티션-복제본 캐싱 토폴로지에서 데이터는 클러스터의 모든 노드에 분산됩니다. 이 경우, 쿼리가 시작된 캐시 서버는 클러스터의 다른 모든 서버로 쿼리를 전송하고 로컬에서도 실행합니다. 쿼리는 모든 서버에서 병렬로 실행되고, 그 결과는 모든 노드에서 원래 서버 노드로 반환됩니다. 이 서버 노드는 모든 결과를 결합("union")하여 클라이언트로 반환합니다. 아래는 이 모든 과정을 보여주는 다이어그램입니다.
SQL 프로젝션을 사용한 쿼리
NCache 클래스의 모든 인덱스된 속성이나 특정 속성만 검색할 수 있습니다. 계획안 SQL 유사 쿼리를 사용하여 캐시 저장소에서 데이터를 가져옵니다. 이러한 예측은 효율적인 검색을 지원하고 쿼리 성능 최적화에 중요한 역할을 하도록 설계되었습니다. 예를 들어, 특정 카테고리 내 제품의 사용 가능한 단위 열만 필요한 경우 아래와 같은 쿼리를 사용할 수 있습니다.
SELECT UnitsInStock FROM FQN.Product WHERE Category = "Sample_Category"필요한 열만 선택하면 클래스의 모든 인덱스된 속성을 가져오는 오버헤드를 피할 수 있습니다. 이 접근 방식은 쿼리 실행을 개선하고 전반적인 성능을 유지하는 데 도움이 되므로 NCache 더 빠르고 효율적인 결과를 제공합니다.
맺음말
보시다시피 NCache 분산 캐시 쿼리를 매우 간편하게 만들어 줍니다. 이는 캐시를 더욱 의미 있게 활용하고 원하는 정보를 더 쉽게 찾을 수 있게 해 주는 강력한 기능입니다.
다음에 무엇을할지?
저자: 이크발 칸(Iqbal Khan)이 근무하는 곳 Alachisoft , .NET 및 Java 분산 캐싱, O/R 매핑 및 SharePoint 스토리지 최적화 솔루션을 제공하는 선도적인 소프트웨어 회사입니다. 당신은 그에게 연락할 수 있습니다 iqbal@alachisoft.com.