읽기 캐시 및 쓰기 캐시 사용
대용량 트랜잭션을 처리하는 웹 애플리케이션, 서비스 지향 아키텍처(SOA), 그리드 컴퓨팅 및 기타 서버 애플리케이션이 빠르게 성장함에 따라 기존 데이터 저장 시스템은 종종 이러한 수요를 따라가지 못하고 있습니다. 그 이유는 데이터 저장 시스템이 서버 추가를 통해 확장할 수 있는 애플리케이션 아키텍처와 달리 확장이 불가능하기 때문입니다. 이 글에서는 분산 시스템에서 사용되는 캐싱 전략을 예시와 함께 설명합니다. NCache.
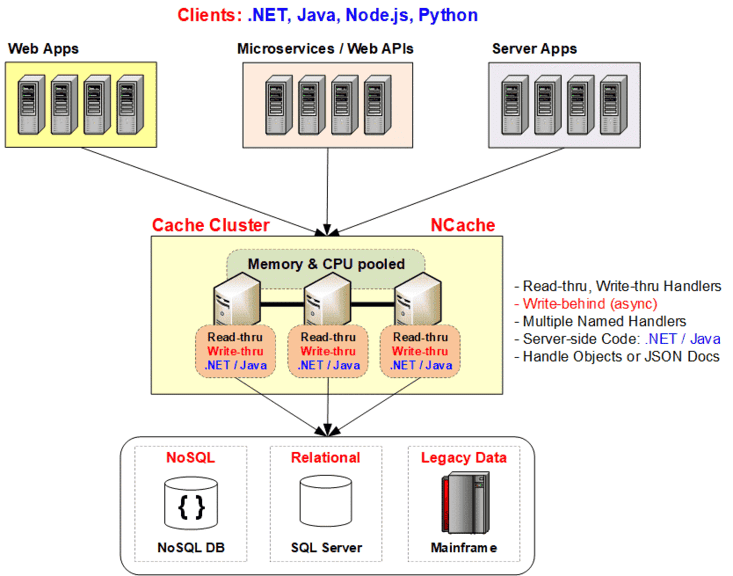
이러한 상황에서 인메모리 분산 캐시는 데이터 저장 병목 현상에 대한 탁월한 해결책을 제공합니다. 여러 서버를 클러스터로 분산시켜 메모리를 풀링하고 모든 노드에서 캐시를 동기화합니다. 이 클러스터는 애플리케이션 서버처럼 무한대로 확장할 수 있습니다. 이를 통해 기본 데이터 저장소의 부하를 줄여 확장성 병목 현상을 제거합니다.
주요 요점
- 읽기-스루 캐시 특징 NCache 애플리케이션이 데이터를 요청할 때, 캐시에 데이터가 없으면 자동으로 데이터베이스에서 데이터를 가져와 애플리케이션 코드를 간소화합니다.
- 연속 기입 캐시 데이터베이스를 동기적으로 업데이트하여 캐시와 데이터베이스 간의 데이터 일관성을 보장합니다. 또한 이를 통해 애플리케이션 코드를 간소화할 수 있습니다. 이 기능은 다음을 통해 제공됩니다. NCache.
- 쓰기 지연 캐시 특징 NCache 캐시를 즉시 업데이트하고, 데이터베이스 업데이트를 큐에 추가한 다음, 나중에 백그라운드에서 비동기적으로 데이터베이스에 적용합니다. 이렇게 하면 애플리케이션이 느린 데이터베이스 업데이트를 기다릴 필요가 없으므로 애플리케이션 쓰기 성능이 크게 향상됩니다.
- 캐시 사이드 대비: 읽기/쓰기 관통 전략은 캐시를 기본 데이터 저장소로 취급하여 애플리케이션에서 데이터베이스와의 상호 작용을 추상화합니다. 반면 캐시 사이드 패턴에서는 애플리케이션이 데이터베이스와 직접 통신하고 가져온 데이터를 캐시에 저장합니다.
캐시사이드 방식과 읽기/쓰기 방식의 차이점
사람들이 분산 캐시를 사용하는 두 가지 주요 방법이 있습니다.
- 캐시 제외: 애플리케이션이 데이터베이스에서 읽고 쓰는 작업을 담당하는 경우, 캐시는 데이터베이스와 전혀 상호 작용하지 않습니다. 캐시는 더 빠르고 확장 가능한 인메모리 데이터 저장소로 "비워져" 있습니다. 애플리케이션은 데이터베이스에서 데이터를 읽기 전에 캐시를 확인하고, 데이터베이스에 업데이트를 적용한 후에는 캐시를 업데이트합니다. 이렇게 하면 애플리케이션은 캐시는 데이터베이스와 동기화된 상태로 유지됩니다..
- 읽기/쓰기: 여기서 애플리케이션은 캐시를 기본 데이터 저장소로 취급하고 데이터를 읽고 데이터를 씁니다.. 캐시는 이 데이터를 읽고 데이터베이스에 기록함으로써 이 책임의 적용을 완화합니다.
비교: 캐시사이드 vs. 읽기 전용 vs. 쓰기 전용
| 제품 특장점 | 캐시-어사이드 | 전체 읽기 | 연속 기입 | 뒤에 쓰기 |
|---|---|---|---|---|
| 주요 책임 | 애플리케이션은 데이터베이스와의 상호 작용을 관리합니다. | 캐시는 데이터베이스 읽기를 관리합니다. | 캐시는 데이터베이스 쓰기(동기화)를 관리합니다. | 캐시는 데이터베이스 쓰기(비동기)를 관리합니다. |
| 코드 복잡성 | 높음 (앱의 DB 로직) | 낮음 (캐시 제공자의 DB 로직) | 낮음 (캐시 제공자의 DB 로직) | 낮음 (캐시 제공자의 DB 로직) |
| 읽기 확장성 | 중등도 ("떼지어 날뛰는" 위험) | 높음 (요청이 캐시에 통합됨) | N/A | N/A |
| 쓰기 성능 | 속도가 느립니다 (앱이 데이터베이스를 기다립니다). | N/A | 속도가 느립니다 (앱이 데이터베이스를 기다립니다). | 가장 빠름 (앱이 데이터베이스를 기다리지 않음) |
| 데이터 일관성 | 높음 | 높음 | 높음 | 최종적 (데이터베이스 업데이트 전 짧은 지연 시간) |
캐시-어사이드에 비해 읽기-스루 캐시 및 쓰기-스루 캐시의 이점
캐시 어사이드는 매우 강력한 기술로, 조인 및 중첩 쿼리를 포함하는 복잡한 데이터베이스 쿼리를 실행하고 원하는 방식으로 데이터를 조작할 수 있도록 해줍니다. 그럼에도 불구하고, 전체 읽기 / 연속 기입 아래에 언급된 것처럼 캐시 제외에 비해 다양한 이점이 있습니다.
- 애플리케이션 코드 단순화: 캐시를 배제하는 방식에서는 애플리케이션 코드가 여전히 복잡하고 데이터베이스에 직접적으로 의존하며, 여러 애플리케이션이 동일한 데이터를 처리하는 경우 코드 중복까지 발생합니다. 읽기/쓰기 방식은 일부 데이터 액세스 코드를 애플리케이션에서 캐싱 계층으로 이전합니다. 이를 통해 애플리케이션이 획기적으로 간소화되고 데이터베이스의 추상화가 더욱 명확해집니다.
- Read-through Cache로 더 나은 읽기 확장성: 하는 상황이 많다. 캐시 항목 만료여러 개의 병렬 사용자 스레드가 데이터베이스에 부하를 가하게 됩니다. 여기에 수백만 개의 캐시된 항목과 수천 개의 병렬 사용자 요청이 곱해지면 데이터베이스 부하가 눈에 띄게 증가합니다. 하지만 Read-through는 데이터베이스에서 캐시 항목의 최신 복사본을 가져오는 동안 캐시 항목을 캐시에 보관합니다. 그런 다음 캐시 항목을 업데이트합니다. 결과적으로 애플리케이션은 이러한 캐시 항목을 찾기 위해 데이터베이스로 이동하지 않고 데이터베이스 부하를 최소화합니다.
- Write-behind로 쓰기 성능 향상: 캐시를 따로 사용하는 경우 애플리케이션은 동기 방식으로 데이터베이스를 직접 업데이트합니다. 반면 후기 쓰기 캐싱을 사용하면 애플리케이션이 캐시를 빠르게 업데이트하고 반환할 수 있습니다. 그런 다음 캐시가 백그라운드에서 데이터베이스를 업데이트하도록 합니다.
- Write-behind로 데이터베이스 확장성 향상: Write-behind를 사용하면 다음을 지정할 수 있습니다. 제한 제한 따라서 데이터베이스 쓰기 속도가 캐시 업데이트 속도보다 느리므로 데이터베이스에 가해지는 부하가 크지 않습니다. 또한, 부하를 최소화하기 위해 사용량이 적은 시간에 데이터베이스 쓰기가 수행되도록 예약할 수 있습니다.
- 만료 시 캐시 자동 새로 고침: 전체 읽기 캐시가 만료되면 데이터베이스에서 개체를 자동으로 다시 로드할 수 있습니다. 이는 최신 데이터가 항상 캐시에 있기 때문에 애플리케이션이 피크 시간에 데이터베이스에 도달할 필요가 없음을 의미합니다.
- 데이터베이스 변경 시 캐시 자동 새로 고침: 읽기 캐시는 데이터베이스에서 해당 데이터가 변경되면 데이터베이스에서 객체를 자동으로 다시 로드합니다. 즉, 캐시는 항상 최신 상태를 유지하며, 최신 데이터가 항상 캐시에 저장되므로 애플리케이션이 사용량이 많은 시간에 데이터베이스를 열람할 필요가 없습니다.
읽기/쓰기는 애플리케이션의 모든 데이터 액세스에 사용하도록 설계된 것이 아닙니다. 데이터베이스에서 개별 행을 읽거나 개별 캐시 항목에 직접 매핑될 수 있는 데이터를 읽는 상황에 가장 적합합니다. 또한 데이터가 주기적으로 변경되더라도 자주 읽기 위해 캐시에 보관해야 하는 참조 데이터에도 이상적입니다.
읽기 캐시 구현
읽기 제공자 NCache 사용자 정의 클래스입니다 IReadThruProvider 캐시에서 데이터를 찾을 수 없는 경우 소스(예: SQL Server)에서 데이터를 가져오는 .NET입니다. NCache LoadFromSource를 자동으로 호출합니다. 사용하려면 공급자를 구현하고 다음을 사용하여 배포합니다. NCache 관리 센터 or 명령줄 도구예산 및 가능 캐시 설정에 넣어 두세요.
using System.Collections;
using Alachisoft.NCache.Runtime.DatasourceProviders;

public class SampleReadThruProvider : IReadThruProvider
{
    public void Init(IDictionary parameters, string cacheId)
    {
        // Initialize resources if needed
    }

    // Modern "Expression-bodied member" for conciseness
    public ProviderCacheItem LoadFromSource(string key) =>
        new(Database.GetData(key));

    // Using LINQ instead of a foreach loop for cleaner bulk loading
    public IDictionary<string, ProviderCacheItem> LoadFromSource(ICollection<string> keys)
    {
        return keys.ToDictionary(
            key => key,
            key => new ProviderCacheItem(Database.GetData(key))
        );
    }

    public ProviderDataTypeItem<IEnumerable> LoadDataTypeFromSource(string key, DistributedDataType dataType)
    {
        // "Switch Expression" with "Collection Expressions"
        return dataType switch
        {
            DistributedDataType.List => new([Database.GetData(key)]),

            DistributedDataType.Dictionary => new(new Dictionary<string, object>
            {
                [key] = Database.GetData(key)
            }),

            DistributedDataType.Counter => new(1000),

            _ => null! // null-forgiving operator if nullable context is enabled
        };
    }

    public void Dispose()
    {
        // Clean up resources if needed
    }
}
Init() 기본 데이터 소스에 대한 연결 설정과 같은 특정 리소스 할당 작업을 수행하는 반면 Dispose() 이러한 모든 할당을 재설정하기 위한 것입니다.
쓰기 캐시 구현
Write-Through 제공자 NCache 는 다음을 구현하는 사용자 정의 클래스입니다. IWriteThruProvider 캐시가 업데이트될 때마다 캐시 업데이트(추가, 업데이트, 제거)를 데이터베이스에 직접 유지합니다.
이를 사용하려면 인터페이스를 구현하고 공급자를 사용하여 배포합니다. NCache 관리 센터예산 및 가능 캐시 구성에 있습니다.
using System.Collections;
using Alachisoft.NCache.Runtime.DatasourceProviders;

public class SampleWriteThruProvider : IWriteThruProvider
{
    public void Init(IDictionary parameters, string cacheId)
    {
        // Initialize resources if needed
    }

    public void Dispose()
    {
        // Clean up resources if needed
    }

    public OperationResult WriteToDataSource(WriteOperation operation)
    {
        var product = operation.ProviderItem.GetValue<Product>();

        // Standard switch is still best for side-effects (void actions)
        switch (operation.OperationType)
        {
            case WriteOperationType.Add:
                // Database.Add(product);
                break;

            case WriteOperationType.Update:
                // Database.Update(product);
                break;

            case WriteOperationType.Delete:
                // Database.Delete(product);
                break;
        }

        // Target-typed "new" infers the class type automatically
        return new(operation, OperationResult.Status.Success);
    }

    // Modern "Expression-bodied member" using LINQ projection
    public ICollection<OperationResult> WriteToDataSource(ICollection<WriteOperation> operations) =<
        operations.Select(WriteToDataSource).ToList();

    // Handling Data Structures with LINQ
    public ICollection<OperationResult> WriteToDataSource(ICollection<DataTypeWriteOperation> operations) =>
        operations.Select(op =>
            new OperationResult(op, OperationResult.Status.Success)
        ).ToList();
}