Campo 31 do Código de Boston
Otimize o desempenho do ASP.NET Core com cache distribuído.
Por Iqbal Khan
Presidente e Evangelista de Tecnologia
O ASP.NET Core está se tornando rapidamente popular para o desenvolvimento de aplicações web com alto tráfego. Aprenda como otimizar o desempenho do ASP.NET Core para lidar com cargas extremas de transações sem comprometer a velocidade, utilizando um cache distribuído .NET de código aberto. Esta palestra aborda:
- Visão geral rápida dos gargalos de desempenho do ASP.NET Core
- Visão geral do cache distribuído e como ele resolve problemas de desempenho
- Onde você pode usar o cache distribuído em seus aplicativos
- Alguns recursos importantes de cache distribuído
- Exemplos práticos usando código aberto NCache como o cache distribuído
Ok, obrigado a todos, todos podem me ouvir bem? Ok, esqueci de incluir o slide, agradecendo a todos os patrocinadores. Vou entrar no site e mostrar os logos de todos os patrocinadores. nós somos um deles, então, eu vou mostrar isso no final também. Foi o que os organizadores nos disseram. Então, vou abordar este tópico e gostaria de manter esta conversa mais interativa, se possível. Então, se você tiver alguma dúvida, sinta-se à vontade para me parar. Deixe-me apenas ter certeza de que tudo está gravando.
Então, o tópico de hoje é como otimizar o desempenho do aplicativo ASP.NET core com cache distribuído? Vou usar um produto de código aberto chamado NCache. Quantos aqui, já ouviram falar NCache antes? Esse é um bom número. Ok, vou usar NCache como um exemplo. Esta conversa não é sobre NCacheEntão, trata-se do desempenho do ASP.NET Core e de como você pode usar o cache? Tenho certeza de que você está aqui porque o ASP.NET Core se tornou popular, está se tornando cada vez mais popular, é a nova arquitetura limpa e leve, é a tecnologia multiplataforma, a reestruturação do .NET é de código aberto, há muitos aplicativos legados do ASP.NET que também estão migrando para o ASP.NET Core. O ASP.NET Core será a principal tecnologia com a qual você desenvolverá aplicativos web em .NET.
Então, mais e mais pessoas agora estão desenvolvendo aplicativos que precisam de escalabilidade. Então, o ASP.NET core também precisa de escalabilidade. Deixe-me definir rapidamente o que é escalabilidade? Tenho certeza de que a maioria de vocês já sabe disso, mas para fins de completude, vou definir isso.
O que é escalabilidade?
Escalabilidade é se você tem um aplicativo que tem um tempo de resposta muito bom, tem um desempenho muito bom com cinco usuários, se você pode manter esse mesmo desempenho com cinco mil, cinquenta mil, quinhentos mil usuários, então seu aplicativo é escalável. Se o seu aplicativo não tiver um bom desempenho com cinco usuários, você terá outros problemas que não abordaremos aqui. Então, eu vou falar sobre como você pode manter esse bom desempenho de cinco usuários para cinquenta mil ou quinhentos mil usuários.
Escalabilidade linear
Escalabilidade linear significa que sua aplicação é arquitetada de tal forma que você pode adicionar mais servidores em produção à medida que sua carga cresce e à medida que você adiciona mais servidores, sua capacidade de transação cresce e é isso que lhe dá um bom desempenho se você puder manter escalabilidade linear. Se você não for capaz de manter a escalabilidade linear, haverá algum tipo de gargalo, que seu aplicativo enfrentará em breve à medida que você adicionar mais servidores, em breve não fará diferença se você adicionar mais servidores ou não e você vai acabou de acertar um gargalo, existe e vou falar sobre o gargalo.
Os seguintes aplicativos precisam de escalabilidade
Então, quais aplicativos precisam de escalabilidade? Geralmente, aplicativos de servidor, são aplicativos web, ASP.NET core, serviços web, que são usados por outros aplicativos web. Serviços web podem ser aplicativos independentes que estão sendo usados por aplicativos externos ou podem ser parte de aplicativos web que você está desenvolvendo, de qualquer forma, se eles são de alta transação, eles também vão precisar de escalabilidade.
Microsserviços está se tornando uma nova palavra da moda agora, é assim que você deseja rearquitetar seu aplicativo. Os microsserviços também vão para a tecnologia do lado do servidor, são usados em aplicativos de alta transação e precisarão de escalabilidade. Para qualquer outro aplicativo de servidor, muitas organizações grandes têm processamento em lote no back-end e precisam fazer o fluxo de trabalho no back-end. Um monte de aplicativos de servidor de back-end que precisam apenas tentar lidar com muitas transações, eles também precisarão de escalabilidade. Então, se sua empresa ou se você está engajado em algum desses tipos de aplicativos e quer ter aquele bom desempenho, esse é o papo para você.
O problema de escalabilidade
Então, agora que estabelecemos que vocês entenderam que esses aplicativos precisam de escalabilidade, existe um problema de escalabilidade? Sim, existe, e não está na camada de aplicação. No aplicativo ASP.NET Core, você pode adicionar mais servidores facilmente à medida que a carga de transações aumenta e, geralmente, há um balanceador de carga na frente da camada de aplicação que direciona o tráfego uniformemente para todos os servidores. Conforme o número de usuários aumenta, basta adicionar mais servidores, sem problemas. O problema, claro, está no armazenamento de dados ou nos bancos de dados. Esses são os bancos de dados relacionais, o mainframe, e essa é uma das razões pelas quais os bancos de dados NoSQL começaram a ganhar força. Mas, na maioria das situações, ainda é necessário usar bancos de dados relacionais, tanto por razões técnicas quanto não técnicas. Portanto, se vocês analisarem a maioria dos aplicativos que vocês desenvolveram ou estão desenvolvendo, verão que acabam usando bancos de dados relacionais. No caso do .NET, o mais popular é o SQL Server. Então, se você não consegue usar um banco de dados NoSQL, de que adianta para a escalabilidade? A razão é que o banco de dados NoSQL exige que você abandone o banco de dados relacional e migre os dados para o NoSQL, o que é possível para alguns dados, mas não para muitos dados empresariais. Todos os seus clientes, contas, atividades, tudo isso ainda precisa permanecer em um banco de dados relacional. Portanto, você precisa resolver esse problema de escalabilidade com os bancos de dados relacionais em jogo, e é por isso que digo que o banco de dados NoSQL nem sempre é a resposta, porque você não consegue usá-lo.
A Solução (Cache Distribuído)
Então, a maneira de resolver isso, é claro, é usar um cache distribuído e é assim que um cache distribuído é implantado em seu ambiente.
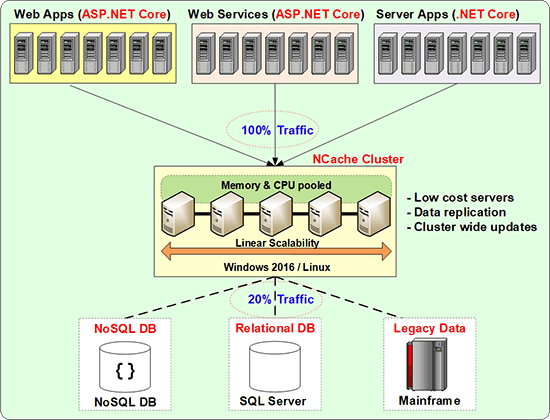
Então, esta é a camada de aplicação. Em alguns casos, você pode ter um balanceador de carga na frente, direcionando o tráfego para todos os servidores de aplicação. Em outros casos, pode não haver um balanceador de carga; pode haver alguma outra forma de compartilhamento de carga, já que se trata de aplicações de back-end. De qualquer forma, você tem vários servidores executando suas aplicações. Portanto, isso é muito escalável, mas no caso do banco de dados, você não pode continuar adicionando mais e mais bancos de dados. As empresas de bancos de dados relacionais estão tentando fazer o máximo possível para escalar seus sistemas, por exemplo, com tabelas em memória, que são muito mais rápidas. Acho que o SQL Server também não introduziu o conceito de réplicas somente leitura. Então, se você combinar tabelas em memória com réplicas somente leitura, obterá um aumento de desempenho, mas, como você verá, explicarei melhor. Quanto mais réplicas você cria, mais problemas terá, pois cada atualização precisa ser feita em todas as réplicas. Para obter o melhor desempenho com escalabilidade, é essencial garantir que haja no máximo uma réplica. Ou seja, uma cópia mestre e uma réplica de cada dado. Ao mesmo tempo, é preciso garantir a escalabilidade. O problema é que um banco de dados relacional não pode ser particionado da mesma forma que um cache distribuído ou um banco de dados NoSQL, pois ambos utilizam pares chave-valor, um design muito diferente do de um banco de dados relacional. No entanto, é necessário implementar um cache distribuído como camada intermediária entre a camada de aplicação e o banco de dados.
Então, como isso se parece em termos de qual é a configuração? Então, normalmente estas não são caixas muito caras. Geralmente são caixas de 8 núcleos para 16 núcleos, muita memória de 16 a 32 gigabytes de memória e placas de rede de 1 a 10 gigabits. Às vezes, você tem duas placas de rede, uma para o clustering e outra para as ferramentas, tipo os clientes, mas é isso, isso é muito diferente de obter um servidor de banco de dados de ponta e muito poder de processamento para fazer seu trabalho porque há apenas um deles ou muito poucos deles. Então, não há outra maneira de contornar isso. Dizemos aos nossos clientes que não recebem mais de 64 GB de RAM por caixa, porque quando você tem mais de 64 GB de RAM em um ambiente .NET, essa memória deve ser coletada por meio da coleta de lixo e coletada à medida que você coleta mais e mais memória do que você precisa de mais poder de processamento. Então, você entra na mesma questão de começar a comprar caixas muito caras. É melhor obter memória de 32, 16 a 32 bits, 16 a 32 GB, mas mais caixas mantêm-no mais barato.
Como funciona um Cache Distribuído?
Então, o que um cache distribuído faz? Na verdade, ele cria um cluster e, novamente, estou falando de um NCache perspectiva, há também outros como Redis que fazem coisas semelhantes, mas de uma maneira diferente. Então, o cache distribuído vai construir um cluster, é um cluster baseado em TCP e o mais importante em um cluster é que assim como você não quer que o banco de dados fique inativo e em produção, você não quer que o cache fique descer também. Portanto, esse cluster precisa ser altamente disponível. Portanto, a melhor maneira de torná-lo altamente disponível para os clientes é garantir que ele tenha uma arquitetura ponto a ponto, onde cada nó seja um cidadão igual e qualquer nó possa cair ou você possa adicionar mais caixas, não há mestre- slave porque isso cria complicações e problemas de alta disponibilidade. Então, ele reuniu os recursos, memória, CPU e placa de rede como recursos. Então, à medida que você adiciona mais, digamos que você tenha mais e mais tráfego ou mais e mais transações, você adiciona mais servidores a seguir em uma proporção de 4 para 1, 5 para 1, você normalmente adicionaria mais caixas. Mínimo de dois servidores de cache e então você continua adicionando mais, então você começará com dois, você começará a ter cada vez mais carga e de repente tudo começará a desacelerar e você adicionar uma terceira caixa tudo melhora quando você adiciona mais carregar e adicionar mais caixas, aqui as coisas começam a desacelerar até um certo ponto. Você adiciona uma quarta caixa e a imagem desaparece.
Então, é assim que escala linearmente, em teoria, nada é ilimitado, mas escala para mais situações, escala de forma ilimitada onde não há gargalo. Assim, isso permite que seu banco de dados não se torne um gargalo. Portanto, isso se tornou praticamente uma prática recomendada essencial da arquitetura do seu aplicativo. Se você está fazendo aplicativos de alta transação, você tem que incorporar o cache distribuído e porque essa é a única maneira, você poderá obter desempenho porque é tudo na memória, qualquer coisa que toque o disco nunca pode ser tão rápido quanto em -memória e escalabilidade porque é distribuído. Alguma dúvida sobre isso antes de ir? Na verdade, no caso de NCache você pode. NCache suporta .NET e Java, mas se você tiver outros aplicativos como Python ou outros, não poderá usar NCache, você precisa usar outras soluções de cache, mas o aplicativo precisa estar em um ambiente escalável. Basicamente, não importa qual idioma você use, a funcionalidade permanece a mesma. Existem alguns benefícios, se você é um aplicativo .NET, então NCache oferece muitos benefícios específicos do .NET que é uma pilha .NET completa, sua pilha de cursos .NET, então se encaixa muito bem. Existem produtos semelhantes no lado Java também que são chamados de grades de dados na memória e, portanto, eles se encaixam muito bem na pilha Java. Por exemplo, vou apenas compartilhar algumas informações. Então, NCache tem uma API Java mas as únicas pessoas que usam a API Java são as que compram NCache ou uso NCache de uma perspectiva .NET. Então, eles têm NCache internamente e eles disseram que poderia usá-lo para Java e uma loja Java iria procurar uma grade de dados na memória baseada em Java, uma loja .NET procuraria NCache. Então, é assim que o mercado é segmentado por causa de toda a experiência, se você é uma loja .NET, você tem toda a experiência .NET versus Java. Então, por que complicar a imagem? Para bancos de dados, então banco de dados não SQL qualquer banco de dados pode ser usado? Qualquer um, qualquer um porque a maneira como você acessa o banco de dados é por meio de seu próprio código personalizado que reside na camada de cache.
Então, esse é outro recurso, que vou abordar é que um dos recursos essenciais para garantir que o cache permaneça sincronizado com o banco de dados é que seu código personalizado precisa estar no servidor de cache. Se você tornar o cache uma caixa preta, onde não há nada no cache, exceto dados, é como ter um banco de dados relacional sem gatilhos e procedimentos armazenados ou outras coisas. Então, isso limita o uso do cache. Então, os caches começaram como sendo apenas a caixa preta. Memcached Era um cache popular, não fazia nada, era apenas um repositório, e com o tempo, evoluiu para uma entidade inteligente completa, capaz de executar seu código. Qualquer banco de dados NoSQL ou relacional pode ser usado com ele. E, novamente, todos esses recursos que mencionei são de código aberto e adequados para empresas. É por isso que estou mencionando, porque é de código aberto. Alguma outra pergunta? Ao lidar com NCache é principalmente cache automático ou você usa API para cache? Então, vou entrar em mais detalhes, mas depende do que você está armazenando em cache? Certos tipos de uso de cache são automáticos. Por exemplo, se você estiver colocando sessões do ASP.NET Core, então é um módulo plugável, ele apenas conecta e começa a armazenar as sessões no cache, então não há nada que você precise fazer, mas se você for armazenar em cache os dados do aplicativo, que é onde está a maior parte do benefício, então há uma API que você precisa chamar para determinar o que você quer armazenar em cache? Por quanto tempo você quer armazenar em cache? Como você quer sincronizá-lo com o banco de dados? Há muitas outras coisas que você precisa ter em mente. Então, vou abordar todos esses recursos de como você deve usar o cache distribuído, como NCache para garantir que você possa armazenar em cache todos os tipos de dados, mas há uma API. Sim.
Usando cache distribuído
OK. Então, agora que estabelecemos que um cache distribuído é importante. Ele oferece desempenho e escalabilidade, vamos ver como você usa um cache distribuído e há três maneiras possíveis de usá-lo. Os três grandes casos de uso técnico.
Cache de dados do aplicativo
E o número um é o cache de dados do aplicativo, sobre o qual tenho falado até agora e entrarei em mais detalhes sobre isso em breve. No cache de dados do aplicativo, há uma coisa que você deve ter em mente que os dados existem no banco de dados e no cache. Então, existem dois lugares em que os dados existem, quando os dados existem em dois lugares, qual é a coisa mais comum que pode dar errado? Eles podem ficar fora de sincronia, então um cliente pode retirar esses milhões de dólares duas vezes do banco, uma vez do cache, alguns do banco de dados e você não quer ter essa situação. Essa situação era tão ruim no passado que as pessoas usavam quando você menciona a palavra cache, o pensamento que veio para a maioria das pessoas é que eu vou armazenar em cache dados somente leitura. Os dados nunca mudam, porque se eu armazenar em cache qualquer coisa que mude, eu não poderia ter problemas. Então, vou explicar como você pode garantir que isso não aconteça, mas essa é a coisa mais importante a ter em mente no cache de dados do aplicativo.
Cache específico do ASP.NET Core
O segundo caso de uso é o cache específico do núcleo do ASP.NET e há duas coisas que você pode armazenar em cache do núcleo do ASP.NET. Uma são as sessões, que são praticamente todos os aplicativos do núcleo do ASP.NET que usam sessões e você no ambiente ASP.NET anterior, a Microsoft deu três opções de armazenamento InProc, servidor de estado e SQL e a quarta era o personalizado. As três primeiras praticamente não funcionaram, mas a quarta permitiu que você conectasse um cache, mas no núcleo do ASP.NET eles realmente fizeram a coisa certa, que é que eles têm do código git, eles realmente o arquitetaram para que seja baseado em uma interface IDistributedCache. Então, ele permite que você conecte um armazenamento de terceiros e você pode conectar algo como NCache e ele automaticamente começa a armazenar suas sessões e eu vou te mostrar como isso é feito.
A segunda novidade do ASP.NET Core é o cache de resposta, que permite armazenar em cache a saída da página. Assim, na próxima vez que a página for acessada, ela não precisa ser executada novamente, bastando retornar a saída, caso não tenha sido alterada. Se a saída for a mesma, por que executar a página novamente? Por que não simplesmente servir a saída? O cache de saída era chamado assim no ASP.NET, mas agora é chamado de cache de resposta. Ele é baseado em padrões HTTP mais rigorosos. Portanto, é possível integrar caches de conteúdo de terceiros na borda da rede, algo que não era possível antes, mas falarei sobre isso mais adiante. A diferença importante entre o cache de dados da aplicação e o cache do ASP.NET Core é que, ao contrário do cache de dados da aplicação, onde os dados existiam em dois locais diferentes, agora os dados existem apenas no cache. Como o cache está na memória, esses dados serão perdidos se qualquer servidor de cache falhar, a menos que haja replicação. Portanto, é muito importante ter em mente que qualquer cache que não ofereça uma boa replicação não é adequado para armazenar em cache sessões ou outras tendências nos dados.
Há uma terceira coisa específica do ASP.NET Core que é chamada SignalR, que não vou abordar, se você tem aplicativos web ativos, que podem dar feedback ativo, digamos que os preços das ações precisam ser atualizados o tempo todo. Então, isso também pode usar um cache distribuído como seu backplane, mas eu não mencionei isso.
Segurança
Qualquer dúvida nos dois primeiros e entrarei em mais detalhes, se necessário, sobre eles. Então, antes de tudo, o cache fica por trás do seu aplicativo. Ele vive entre o aplicativo e o banco de dados. Geralmente, em um ambiente bastante seguro. Temos clientes que mantêm o cache mais próximo, se seu aplicativo estiver na DMZ, eles podem manter o cache não na DMZ, mas atrás do firewall. Às vezes, eles o mantêm na DMZ, mas na maioria das vezes está em uma situação segura, mas muitos de nossos clientes de serviços financeiros, como grandes bancos e outros, não estão satisfeitos com isso, então eles querem mais títulos. Então, é aí que a Enterprise Edition do NCache tem recursos, onde pode fazer criptografia. Assim, todos os dados que você colocar no cache serão automaticamente criptografados com criptografia 3DES ou AES256 e também há segurança, que todas as conexões com o cache serão autenticadas através do Active Directory e haverá coisas de autorização. Assim, os recursos de segurança completos são incorporados à edição corporativa.
Um cliente médio não usa criptografia, a menos que seus dados sejam confidenciais. Portanto, se eles estão mantendo dados financeiros, há alguns problemas de conformidade ou HIPAA, portanto, se assim que você entrar em problemas de conformidade, mesmo que seu ambiente seja seguro, você terá que dar um passo adiante e é aí que você faria a criptografia . Então, NCache A camada Enterprise, por exemplo, realiza a conexão TLS entre o cliente e a camada de cache. Essa conexão em si é totalmente segura e conta com criptografia integrada, de modo que todos os dados armazenados na memória também são mantidos criptografados. E isso atende a uma grande demanda; temos muitos clientes do setor de serviços financeiros e eles estão totalmente satisfeitos com isso.
NCache pode ser implantado e a maioria de nossos clientes ainda o usa em uma situação local. Então, eles têm seu próprio data center onde seu aplicativo é implantado, então eles implantam NCache como parte de sua aplicação. Se você estiver na nuvem, NCache está disponível no Azure e na AWS e está disponível como VMs ou estamos prestes a lançar o serviço de cache gerenciado também, de qualquer forma, garantimos que NCache vive dentro de sua rede virtual na nuvem. Portanto, em um local, isso não é um problema, porque sempre em seu próprio ambiente, você apenas obtém várias VMs ou, se for seu próprio data center, obtém seus próprios servidores e os implanta com o aplicativo. Você instala NCache como software e é para instalações internas, você também pode usar o docker e viu todas as coisas que você esperaria que os aplicativos modernos fossem capazes de fazer, NCache vai fazer. E então, na nuvem, você pode obter as VMs ou obter o cache gerenciado, mas na nuvem, sempre faremos isso dentro de sua VPC no caso de AWS e vnet no caso de azure. Está dentro da sua rede virtual. Então, está perto do seu aplicativo, porque se não for, se você tiver que crescer em vários saltos, e digamos que fosse um cache hospedado, o que provavelmente é bom para aplicativos pequenos, mas qualquer coisa séria, NCache é quase sempre usado em aplicativos de missão crítica em que você está fazendo seus negócios por meio desse aplicativo. Então, é aí que você usaria NCache.
Então, nessas situações, você não pode se dar ao luxo de ter qualquer lentidão e se você não pode se dar ao luxo de ter lentidão, é aí que você quer todo o controle e manter o cache o mais próximo possível do aplicativo. Depende de qual caso de uso você vai fazer, então, por exemplo, o maior e mais rápido benefício são as sessões e você imediatamente o conectaria sem nenhuma alteração de código. É apenas uma alteração de configuração. No caso do ASP.NET Core, não é uma alteração de configuração. É uma alteração de código de arquivo de inicialização, mas muito pequena, mas se você quiser fazer cache de dados do aplicativo, ainda é uma alteração muito direta.
Deixe-me mostrar rapidamente como é a API. Então, olhe para esta API.
Conexão de cacheCache cache = NCache.InitializeCache("myCache");
cache.Dispose();Employee employee = (Employee) cache.Get("Employee:1000");
Employee employee = (Employee) cache["Employee:1000"];
bool isPresent = cache.Contains("Employee:1000");cache.Add("Employee:1000", employee);
cache.AddAsync("Employee:1000", employee);
cache.Insert("Employee:1000", employee);
cache.InsertAsync("Employee:1000", employee);
cache["Employee:1000"] = employee;
Employee employee = (Employee) cache.Remove("Employee:1000");
cache.RemoveAsync("Employee:1000");É apenas um pequeno cache.get, cache.add, Insert, remove. Então, você tem uma chave e um valor como seu objeto. Então, muito fácil de incorporar, mas você tem que ir e fazê-lo, então sempre que você obtém dados do banco de dados, você verifica primeiro o cache, se o cache o possui, você o pega do cache ou então você vai para o banco de dados pegue e coloque no cache, esse é o modelo. Exatamente. Vou acelerar caso contrário, não vou conseguir. eu vou te mostrar NCache um pouquinho mais tarde.
Mensagens e eventos do Pub/Sub
Portanto, as mensagens pub/sub também são um recurso muito poderoso. Muitos aplicativos hoje precisam coordenar o esforço. Eu estava conversando com alguém hoje, que disse que eles precisam fazer muita programação baseada em eventos. Assim, as mensagens pub/sub oferecem um modelo de programação orientado a eventos muito poderoso porque você tem uma infraestrutura em que é uma plataforma escalável na memória agora dentro de seu aplicativo, você pode pensar nisso como um barramento de mensagens. Não é para ambientes distribuídos. É para o mesmo data center um tipo de localização de uma situação, mas é super rápido porque está tudo na memória e é escalável. Então, esse é o terceiro caso de uso que você terá para usar um cache distribuído como NCache. Sim, ele faz, ele faz e o código aberto também suporta isso. Portanto, todos esses recursos estão disponíveis tanto em código aberto quanto corporativo, de fato, todos os NCache A API é praticamente a mesma entre código aberto e corporativo.
O que vimos com pub/sub é novamente se você tem um aplicativo de alto tráfego, alta transação, então você realmente precisa que o mecanismo pub/sub seja super rápido e é aí que NCache realmente brilha.
Cache de dados de aplicativos ASP.NET Core
OK. Então, cache de dados do aplicativo. Como você faz isso? Então, isso também é para responder lá, então há três maneiras de fazer isso.
IDdistribuídoCache
Você pode usar a interface IDistributedCache que vem com o ASP.NET Core e se você programou contra ela, você pode simplesmente conectar NCache como provedor. Portanto, não há mais nenhuma alteração de código depois que você fizer a programação da API IDistributedCache. Portanto, o benefício é que você programa uma vez e não fica preso a nenhum fornecedor de cache. A desvantagem é que é o mínimo denominador comum. Eu vou te mostrar o que parece, isso é tudo. Tem Get and Put, é isso. Você sabe Get, Remove and Set, enquanto há muito mais que você precisa fazer para fazer uso total do cache, que estávamos falando sobre o fato de que você deseja que o cache seja sincronizado com o banco de dados. Portanto, há prós e contras nisso.
Cache do Entity Framework Core
A segunda é se você tem um aplicativo EF Core, você tem um aplicativo EF Core, é uma maneira mais simples de conectar NCache e eu vou te mostrar. Então, na verdade, implementamos métodos de extensão para o EF Core e, novamente, isso é open source e corporativo. Há a amostra do EF Core. OK. Portanto, se você tivesse um aplicativo EF Core, normalmente teria uma consulta do EF Core como esta, você buscaria algo usando a consulta de estilo LINQ. Então, nós implementamos um método de extensão, digamos FromCache, então eles são um monte de métodos, este é um deles, então isso dirá vá para o cache se esta consulta foi armazenada pela última vez no cache, pegue-a do cache. Se não estiver no cache, vá para o banco de dados, execute esta consulta de núcleo EF regular, obtenha-a e coloque-a no cache. Portanto, é apenas uma linha ou apenas uma chamada de método que começa automaticamente a armazenar em cache todos os dados que vêm do banco de dados. Assim, simplifica seu trabalho e você sabe exatamente onde plugar, não há muitas chamadas extras de API que você precisa fazer.
Portanto, para aplicativos principais do EF, novamente há alteração de código, mas o mínimo possível que você pode fazer e começar a armazenar dados em cache. Então, na verdade, para o EF core, eles são vários métodos, isso é FromCache, a maior parte é de, há apenas quatro ou cinco métodos que você pode usar, o FromCache, depois LoadIntoCache, FromCacheOnly. Portanto, e também com o EF Core, quando você salva as alterações, ele também atualiza o cache antes ou depois de atualizar o banco de dados, ele também atualiza o cache. Assim, o cache tem a versão atualizada dos dados. A integridade do cache é mantida em primeiro lugar, certificando-se de que qualquer dado que você mantenha no cache e eu pule, por exemplo, este é um servidor de cache. Digamos que você tenha dois servidores e digamos que você tenha três servidores. Todo o cache é dividido em partições, cada partição tem seu próprio conjunto de buckets, para que seus dados residam apenas em uma das partições. Então, e então esses dados são replicados para algum outro servidor, que é chamado de réplicas, mas as réplicas no caso de NCache não está ativo, é passivo seu aplicativo não fala com as réplicas. Seu aplicativo fala apenas com a partição. Portanto, como os dados são armazenados apenas em um local, não há problema de sincronização. Todo mundo vai para o mesmo servidor, mas como é particionado, nem todo mundo vai para o mesmo servidor, algumas chaves são armazenadas aqui, algumas são armazenadas aqui, algumas são armazenadas aqui.
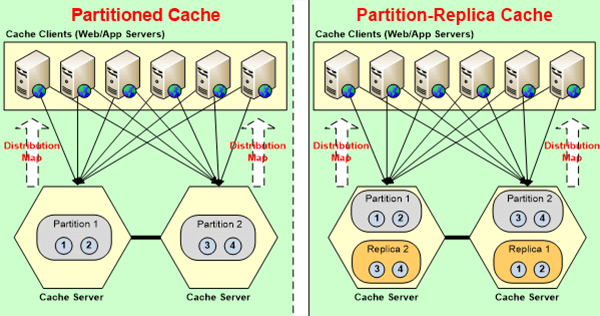
Então, é assim que um cache distribuído é NCache é capaz de fazer o que o servidor SQL não pode fazer porque a natureza do banco de dados relacional é que você não pode particionar, mas a natureza do cache distribuído é que você pode e quando você particiona aqui, estes são três servidores, eles talvez sejam compartilhados por dez servidores de aplicativos e cada servidor de aplicativos pode ter quatro ou cinco ou seis ou oito processos de trabalho. Portanto, há muitos processos clientes diferentes conversando com o cache, não há problema de sincronização porque os dados reais são armazenados apenas em um local. Agora existem outras topologias em NCache que são replicados, onde os mesmos dados existem ativo-ativo e múltiplo e, nesse caso, NCache tem que sincronizar as mudanças. É baseado em token, é um algoritmo de atualização baseado em sequência, não é muito escalável. Portanto, não recomendamos para um ambiente de alta transação.
Cache particionado com replicação é a melhor estratégia ou chamamos de topologia de cache melhor para usar. Então, é assim NCache garante que, dentro do cache, os dados estejam sempre corretos. Isto respondeu a sua pergunta? Então, a porta que você mostrou, há alguma configuração ou configuração no código que diz, de qual cache ele deve buscá-la? Sim. Então, por exemplo, quando você entrar no app.config, você verá que ele vai dizer que você usa mycacheId e eu vou te mostrar o que é o cache. Então, quando você cria um cache em NCache. Cada cache recebe um nome e esse nome por trás da cena sabe onde está o cache, então tudo que você precisa fazer é especificar o nome aqui e então ele saberá para onde ir e obter o cache. E eu vou te mostrar como o cache realmente se parece. Um nome de cache está em todos esses servidores e dentro dos mesmos servidores você pode ter vários nomes de cache, no mesmo servidor você pode ter vários caches e um cache pode viver em vários e é um cache distribuído, o único nome de cache tem que viver em vários servidores é assim que é distribuído, mas os mesmos servidores também podem ser usados para outros nomes de cache, e cada nome de cache fornece seu isolamento. Boa pergunta.
High Availability
Então, é aqui que eu estava dizendo que a alta disponibilidade é muito importante. Se você não conseguir adicionar ou remover servidores em tempo de execução sem qualquer interrupção, seu aplicativo realmente não está altamente disponível. Temos clientes que estão executando NCache durante meses e anos sem qualquer paragem. Então, por exemplo, digamos que você tenha uma configuração de dois servidores e acabou de adicionar um terceiro servidor porque sua carga aumentou. Então, você precisa adicionar um terceiro servidor, tudo o que você fará é adicionar um terceiro servidor e eu mostrarei a você apenas através da ferramenta, basta adicionar um e NCache nos bastidores vai reparticionar. Portanto, essas duas partições agora serão transformadas em três partições. Alguns dos buckets daqui e daqui serão atribuídos à terceira partição automaticamente enquanto um aplicativo estiver em execução, seu aplicativo nem percebe isso. Nos bastidores agora que existe uma terceira partição e agora a réplica também existe uma terceira réplica que é criada, então digamos que a réplica 2 precisa ser movida aqui e a réplica 3 é criada aqui.
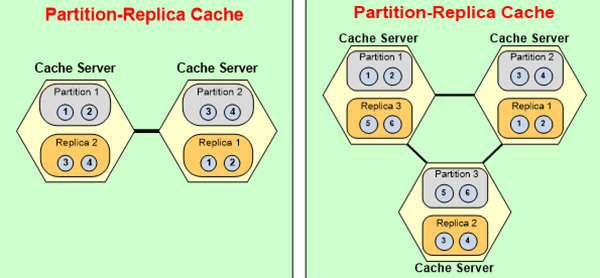
NCache mantém, por trás disso NCache usa chaves para mapeamento de hash, mas faz tudo dinamicamente, como um mapa de distribuição, que é como um mapa de bucket que é reparticionado e reatribuído. Assim, os dados realmente se movem de um servidor para outro automaticamente em tempo de execução.
Afinidade de local
Portanto, em alguns casos, você pode querer manter alguns dos dados juntos na mesma partição. NCache tem um recurso de afinidade de local, onde você pode especificar e, em seguida, especificará. Você dirá que esses dois dados estão relacionados, quero que esteja no mesmo servidor e, em seguida, NCache irá mantê-lo no mesmo servidor através de uma chave extra que ele cria em cima dele. Como eu disse, todos esses são recursos avançados, que você não obtém se apenas usar o mínimo denominador comum e, usando esses recursos, poderá ajustar NCache ao seu ambiente de acordo com suas necessidades especificamente.
Recursos de cache de dados do aplicativo
Então, a primeira coisa que eu queria abordar, esses tópicos, são muito importantes. Para o cache de dados do aplicativo, o mais importante é que o cache esteja sempre atualizado, o que significa que fresco significa que possui dados corretos, se os dados forem alterados no banco de dados, o cache terá os dados mais recentes.
Expirações baseadas no tempo
Portanto, a expiração é a maneira mais comum de os caches fazerem isso, quase todos os caches têm expiração como um recurso. NCache também tem. Há uma expiração absoluta e depois há uma expiração deslizante. A expiração absoluta é, digamos que você esteja adicionando dados ao cache, pode dizer ok após cinco minutos expirar isso porque não acho seguro mantê-lo no cache por mais de cinco minutos. Então, você está fazendo um palpite, que é seguro manter os dados no cache por cinco minutos e isso é bom o suficiente para alguns dados, para outros dados pode não ser.
A expiração deslizante é mais para quando você está armazenando sessões e está dizendo tudo bem depois que ninguém está usando, depois que todos terminarem de usar essa sessão, basta removê-la. Então, é mais uma expiração de limpeza. A expiração absoluta é a sincronização é mantê-la consistente com o banco de dados, o deslizamento é limpo, mas a expiração é um palpite informado, seja qual for o palpite errado
Dependências do banco de dados
Em alguns casos, você pode permitir que os dados sejam inconsistentes em alguns casos, você não pode. Então, se você não pode, então você tem que ter outros recursos, então é aqui que NCache realmente se destaca que é que, por exemplo, você pode ter uma sincronização do cache com o banco de dados. Então, NCache usa a dependência SQL incorporada ao SQL Server para monitorar o SQL Server. Então, você pode para cada item que você armazenar em cache, você pode dizer ok mapear isso com esta linha correspondente na tabela do banco de dados SQL, NCache monitora, se essa linha mudar, NCache em seguida, remove esse item do cache ou o recarrega novamente. Então, agora de repente você tem um cache inteligente, ele é capaz de garantir que tudo o que você está armazenando em cache sempre será consistente e isso é algo que você não obtém se o cache for uma caixa preta.
Então, você tem que ter esse tipo de inteligência com o cache, e as dependências do SQL são um recurso .NET, então é aí que NCache Ser .NET ajuda se seu banco de dados for SQL. Também temos uma dependência do Oracle, que usa as notificações do banco de dados Oracle. Há outra maneira de fazer isso, que é a notificação baseada em polling, mais eficiente, mas não em tempo real. Além disso, você pode sincronizar o cache com fontes de dados não relacionais. Seus dados podem estar em um banco de dados NoSQL, na nuvem ou em qualquer outro lugar, e você precisa monitorá-los. Para isso, você pode criar o que chamamos de dependência personalizada, que é o seu código que reside no servidor de cache. NCache chama em um determinado intervalo, ele vai e verifica sua fonte de dados, se os dados mudam, ele notifica NCache, ok os dados foram alterados por favor remova isso ou recarregue-o.
Então, essa é uma área onde NCache é realmente muito forte. Se você deseja manter seus dados atualizados, precisa fazer essas coisas para garantir que o cache esteja atualizado.
Read-Through e Write-Through
Outro recurso é a leitura e a gravação. Então, agora isso é combinado com expiração e sincronização de banco de dados. Isso permite que o cache carregue dados do seu banco de dados e é assim que, por exemplo, se você tiver uma leitura, mostrarei como é uma leitura. É apenas uma interface que você implementa e seu código realmente reside no cache, então aqui está uma interface que você implementa neste código. Então, há uma carga da chamada de origem, ela fornece uma chave e, em seguida, NCache chama seu método, o servidor de cache chama seu método, esse código está sendo executado nos servidores, todos os servidores de cache, NCache chama esse método e diz, por favor, vá em frente e carregue esta chave porque ela não está no cache. Então, se eu fizer um cache.Get, eu acho que aquela chave não está no cache, ou eu retorno um null, dizendo que a chave não existe, ou se eu tiver uma leitura, eu posso simplesmente ir no cache, e NCache pode ir ao banco de dados e lê-lo para você. Assim, você sempre terá. Agora, isso é muito útil em muitos casos, onde você deseja apenas manter esses dados no cache sempre.
Assim, a leitura permite, quando você combina leitura com expirações ou sincronização de banco de dados, o que isso faz é quando os dados expiram NCache pode atualizá-lo automaticamente, por que removê-lo? Se você for recarregá-lo, da próxima vez, porque esses dados são necessários e você os expira apenas para mantê-los atualizados. Então, por que não basta ter NCache volte e recarregue. Se você tiver implementado a leitura, NCache fará isso automaticamente e a mesma coisa acontece, se os dados forem alterados no banco de dados ou na fonte de dados e esse recurso de sincronização descobrir isso, ok esse banco de dados mudou, então se você implementou a leitura, ele irá automaticamente recarregá-lo .
Da mesma forma, o write-through oferece outro benefício que é que, se você tiver um write-behind, poderá atualizar o cache. Então, alguns dados, não são tão sensíveis para atualizações, quero dizer, é claro, se são saldos de bancos de dados financeiros que você não quer fazer write-behind, mas em alguns casos, tudo bem se você puder apenas enfileirar as atualizações. Então, se você atualizar o cache, atualizar o cache é muito mais rápido do que atualizar o banco de dados, claro, mais escalável porque ele é distribuído e você atualiza o cache e informa NCache por favor, vá em frente e atualize isso, o banco de dados de forma assíncrona nos bastidores. Então, esse é o recurso write-behind, e agora de repente acelera seu aplicativo porque qual é o gargalo? Lê do banco de dados e grava no banco de dados. As leituras que você pode armazenar em cache, para que você nem vá para o banco de dados, mas as gravações tenham que ir para o banco de dados, você não pode dizer que o banco de dados é o mestre certo, então não há como contornar isso, mas o tipo de gravação por trás é fácil.
Então, esse é outro recurso que, se você o tiver, NCache de repente lhe dá mais impulso em seu aplicativo. Pergunta: Então, caso não seja possível escrever no banco de dados e fazer assíncrono, ele lançará uma exceção? Sim. Ele lançará uma exceção, você pode ter um retorno de chamada que é chamado por NCache e, novamente, o código é, esse código write-behind está sendo executado nos servidores de cache, mas o retorno de chamada está aqui, então ele notificará o cliente e seu retorno de chamada será chamado, para que você possa executar ações corretivas. Depois de se sentir confortável com esse cache, NCache pode sincronizar o cache com o banco de dados, você armazenará mais e mais dados em cache. Quanto mais dados você armazena em cache, mais o cache começa a se parecer com um banco de dados, o que significa que uma maneira de buscar dados com valor-chave não é inteligente o suficiente. Então, você precisa encontrar dados baseados em SQL, especialmente dados de referência.
Pesquisa SQL
Quando falamos sobre a consulta do EF Core, você está buscando dados com base em atributos, não apenas na chave. Portanto, se você puder pesquisar os dados com consultas SQL ou LINQ ou com o núcleo EF, isso tornará o cache muito mais rápido. Essa é outra maneira NCache se destaca é que uma vez que você coloca todos esses dados no cache, você pode pesquisar, você pode dizer me dê todos os meus clientes que estão baseados em Boston ou Nova York e ele fornecerá uma coleção de objetos de clientes do cache. Então, está começando a se parecer mais com um banco de dados e você está tirando toda a pressão desse banco de dados, especialmente para dados de referência. Portanto, a pesquisa SQL é muito importante.
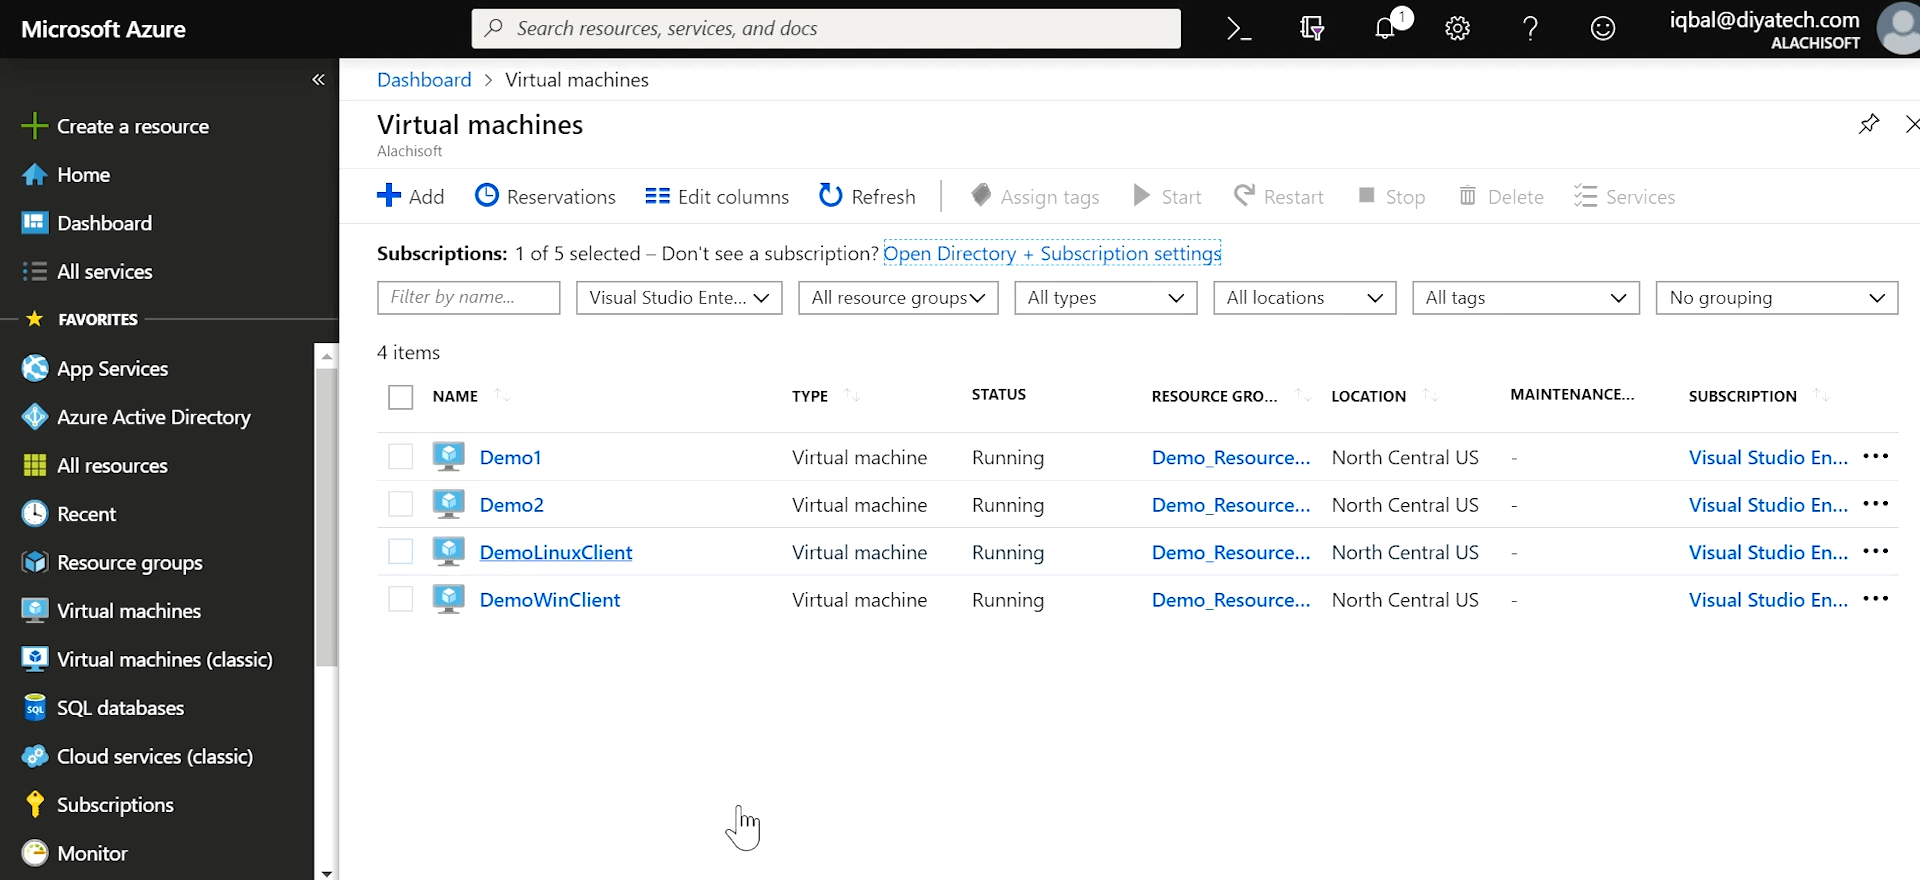
OK. Agora eu quero te mostrar o que NCache Como seria um cache, ou como qualquer outro cache se pareceria? Então, estou logado no Azure. Tenho duas VMs de servidor de cache. Tenho dois servidores de cache, um cliente Windows e uma linha Linux, porque, como é o .NET Core, você pode executar o aplicativo tanto no Windows quanto no Linux. NCache Funciona, na verdade, os servidores de cache também podem ser executados no Linux devido ao .NET Core, porque NCache é nativo do .NET Core.
Criar um cache
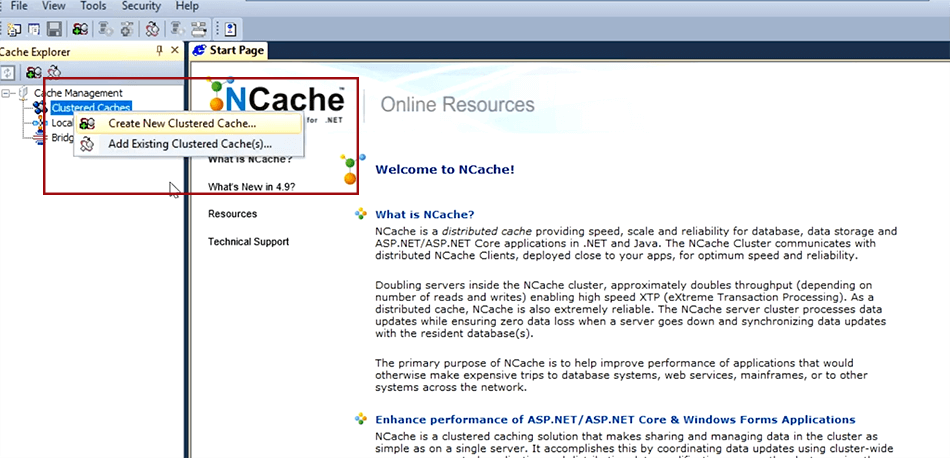
Então, eu sou, por exemplo, eu fiz uma área de trabalho remota para o cliente Windows. Na verdade, vou criar um cache, então meu cache terá dois servidores e eu terei um cliente Windows, um cliente Linux, e quando eu usar a palavra cliente, na verdade são suas caixas de servidor de aplicativos. OK. Então, eu vou usar isso NCache ferramenta do gerenciador. Agora, essa ferramenta faz parte da Enterprise Edition, mas você pode fazer as mesmas coisas por meio de ferramentas de linha de comando de código aberto ou arquivos de configuração, mas apenas para fins de conveniência, vou em frente e criar um cache.
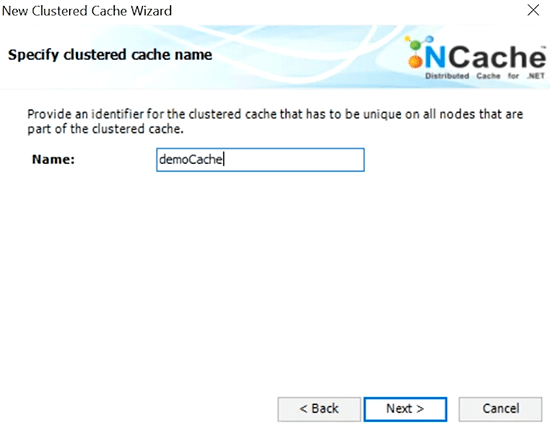
Vou chamar meu cache democache como eu disse que todos os caches são nomeados.
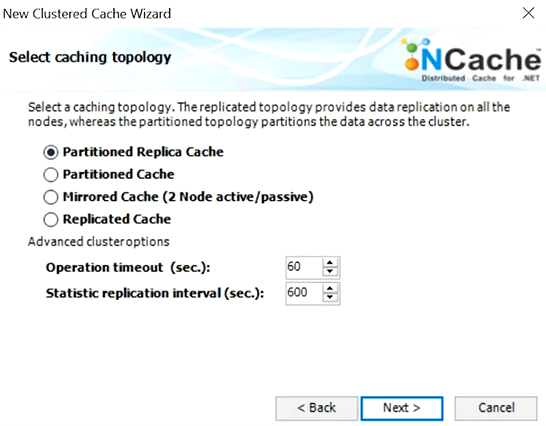
Vou escolher uma topologia. Vou escolher cache particionado com replicação.
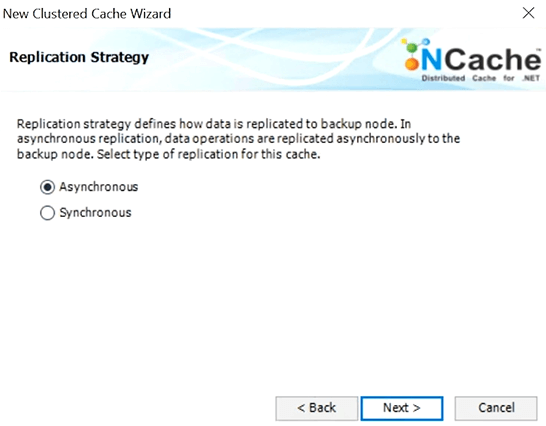
Farei a replicação assíncrona, então há uma replicação assíncrona e uma replicação assíncrona. A replicação de sincronização é quando você não pode se dar ao luxo de fazer assíncrona se forem dados mais confidenciais, dados financeiros e outras coisas em que você deseja que essas replicações aconteçam como parte da atualização, o que, obviamente, torna as coisas mais lentas, mas as torna mais.
Então, aqui está meu servidor de cache um, aqui está meu servidor de cache dois, então acabei de criar um cluster de dois servidores. ainda não está rodando. Vou adicionar dois nós de cliente. Este é o meu windows, havia um servidor. Então, 6 é meu cliente Windows e 7 é meu cliente UNIX. OK. Então, eu tenho dois servidores de cache e dois clientes normalmente, como eu disse, você terá no mínimo dois servidores de cache e quatro para um, cinco para um proporção entre os clientes e o servidor. Então, estou apenas começando o cache agora. Novamente, de um lugar, posso fazer tudo isso e o mesmo na próxima versão que estamos prestes a lançar, tudo isso é baseado na web, então na nuvem, você pode fazer isso. Vou abrir as estatísticas e são como monitoramento, são estatísticas perfmon.
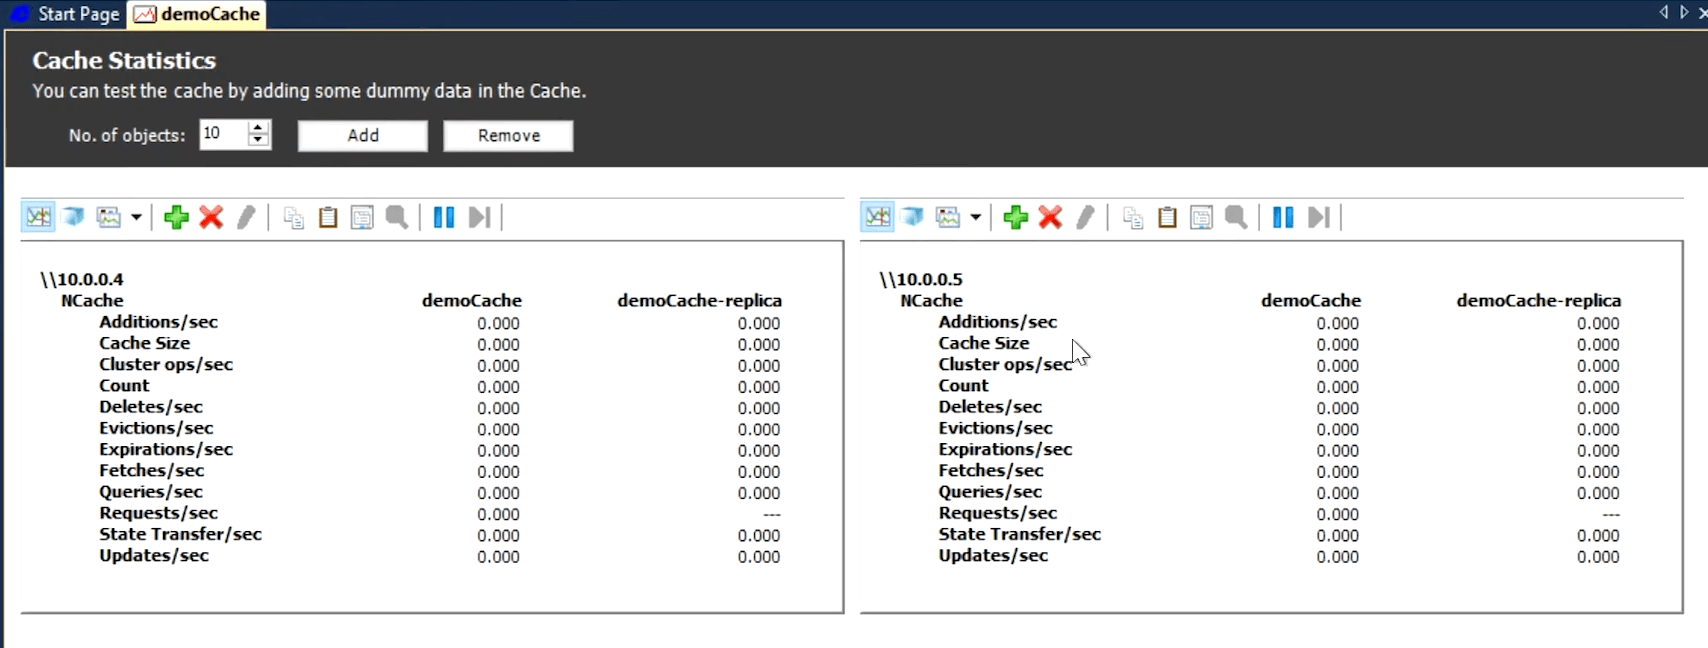
Simule o estresse e monitore as estatísticas de cache
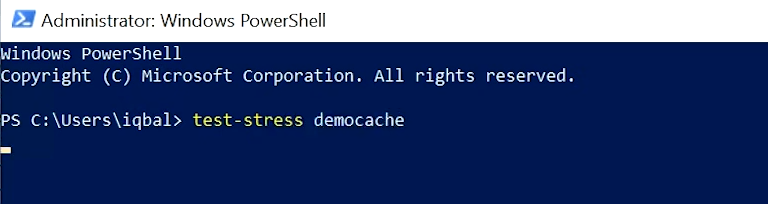
Vou testar e ver se meu cliente consegue falar com isso, agora essa caixa é um cliente. então, vou abrir o console do PowerShell. Eu vou ter dois parciais do windows e estou logado em dois Linux aqui, então eu tenho um Linux aqui, agora o Linux aqui. Direita? Aqui, preciso iniciar o PowerShell e aqui, também preciso importar meu módulo que não preciso fazer para windows, já está lá para mim e preciso fazer o mesmo aqui. Eu preciso iniciar o PowerShell no Linux e tudo bem, agora vou iniciar um cliente. Então, NCache vem com esta ferramenta de teste de estresse, o que facilita muito o teste de estresse em seu próprio ambiente. Para que você possa ver exatamente como NCache executa? Assim, você não tem que tomar uma palavra para o seu desempenho. Então, digamos aqui, estou fazendo cerca de 500 solicitações por segundo por servidor.
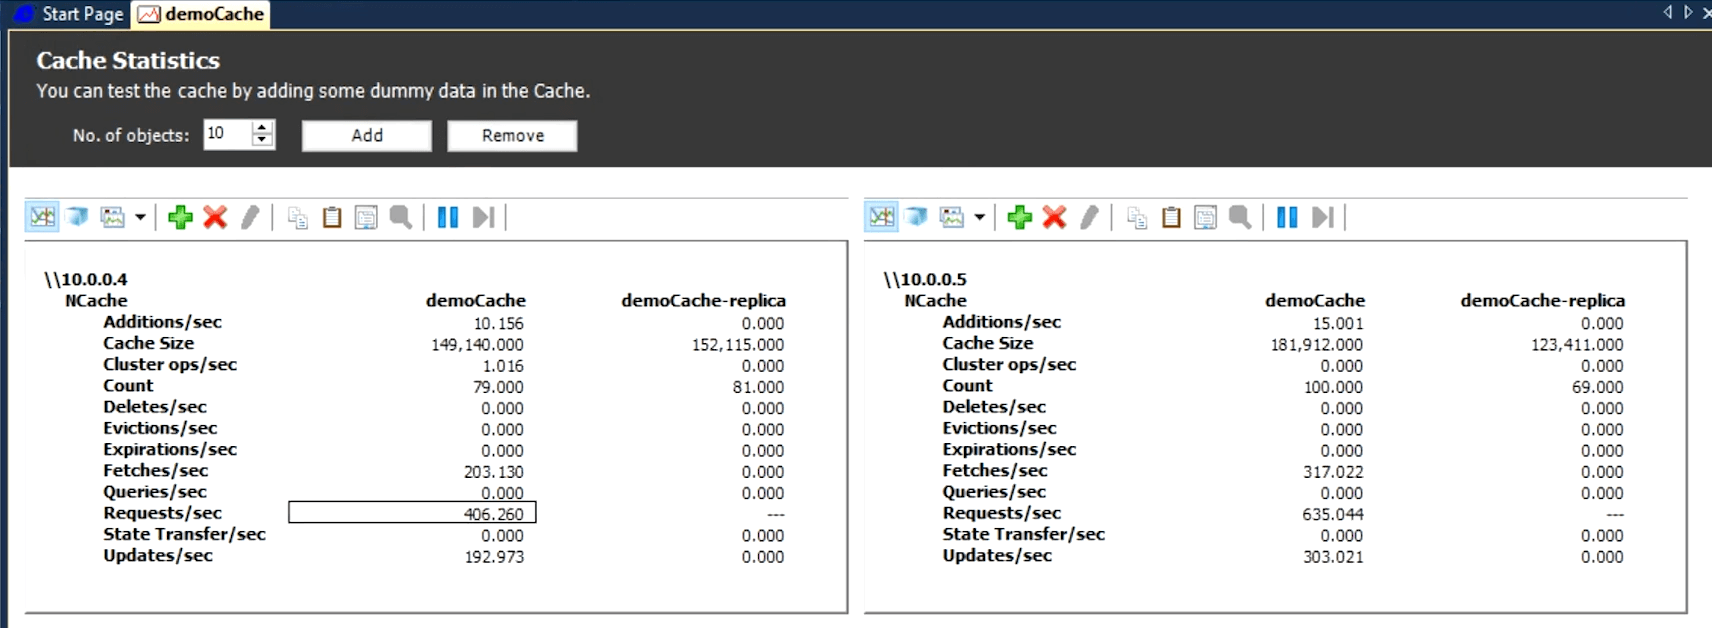
OK. Então, eu quero aumentar a carga, então vou para o segundo console e direi executar um teste de estresse novamente.
Agora, de repente, você verá que isso vai dobrar em dobro, certo, e deixe-me ir em frente e adicionar mais estresse. Eu chegarei a um dos Linux e direi a mesma coisa e de repente agora estou com mais de 1500 por solicitação. Então, agora eu sou um total de cerca de 3,000 solicitações por segundo, como deixe-me fazer outra e agora estou fazendo mais de 4,000 solicitações por segundo. Então, eu posso continuar adicionando mais e mais se eu tiver mais VMs, eu posso ou posso ter mais instâncias e você verá que em breve, uma vez, atinge o máximo de qualquer que seja e esses dois servidores devem ser capaz de lidar com pelo menos 50,000 solicitações por segundo, mas novamente isso é com o pequeno conjunto de dados, à medida que o tamanho do objeto aumenta, isso diminuirá, é claro, mas quando eu maximizar isso, vou em frente aqui e novamente isso é funcionando bem, não tenho uma terceira VM, mas tudo o que preciso fazer é apenas fazer isso e adicionar um terceiro endereço e direi concluir e adicionará uma terceira caixa aqui e fará todo esse particionamento ou reparticionando automaticamente para você.
Da mesma forma, se eu precisar derrubar qualquer uma das VMs, ele também fará isso. Sim, é isso, esse é o fim da minha conversa. Podemos responder a alguma pergunta? É a única solução nativa .NET, a única outra solução nativa foi AppFabric que foi descontinuado. Então, Redis não é uma solução .NET, embora a Microsoft a tenha escolhido para o Azure porque eles queriam ser independentes de tecnologia, então eles a escolheram, mas nós somos .NET nativos. Temos sido assim desde o primeiro dia e, até onde sabemos, somos a escolha favorita para o .NET.