Acampamento de Código de Cidades Gêmeas
Dimensionamento de aplicativos .NET com cache distribuído
Por Iqbal Khan
Presidente e Evangelista de Tecnologia
Veja esta demonstração prática de um cache distribuído e aprenda as práticas recomendadas para usar um cache .NET em vários ambientes. Esta conversa abrange:
- Visão geral rápida dos gargalos de escalabilidade em aplicativos .NET
- Descrição do cache distribuído e como ele resolve problemas de desempenho
- Onde você pode usar o cache distribuído em seus aplicativos
- Alguns recursos importantes em um cache distribuído
- Exemplos práticos usando um cache distribuído
Visão geral
Obrigado a todos por terem vindo. Meu nome é Iqbal Khan. Está um lindo dia lá fora. Estou aqui de Tampa. Então, temperatura muito mais agradável aqui. Eu estava esperando um clima muito mais frio do que o que temos aqui. Então, obrigado por ficar dentro de casa. Eu sou um evangelista de tecnologia nesta empresa chamada Alachisoft. Nós somos os fabricantes de NCache. Apenas os próximos um ou dois minutos serão uma declaração de marketing. Assim, temos dois produtos para o espaço .NET. Um é o nosso principal produto chamado NCache que é um cache distribuído para .NET. Essa é a expertise que temos. Então, estamos neste espaço há cerca de 10 anos e é assim que construímos expertise neste tópico específico.
Temos outro produto chamado NosDB, que lançamos no final do ano passado. É um banco de dados NoSQL de código aberto para .NET. Ele possui recursos semelhantes aos do MongoDB, mas é nativo do .NET e, novamente, totalmente de código aberto. NCache É também de código aberto, assim como o NosDB. Por favor, dê uma olhada em nossos produtos.
Então, eu preferiria ter uma discussão mais interativa. Vamos passar por uma combinação de algumas discussões conceituais de arquitetura e alguns códigos-fonte. Assim, podemos realmente ver como você usaria um cache para seu aplicativo. Então vamos começar.
Global
Vamos tirar algumas definições do caminho. O número um é; o que é escalabilidade. Escalabilidade não é desempenho. Portanto, se seu aplicativo tiver um desempenho rápido com 5 usuários, ele não será escalável, a menos que você possa ter o mesmo bom desempenho com 5000, 50,000 ou 500,000 usuários. Claro, se sua aplicação não funciona rápido com 5 usuários, então você precisa olhar para outros aspectos além do que vamos falar.
Escalabilidade Linear
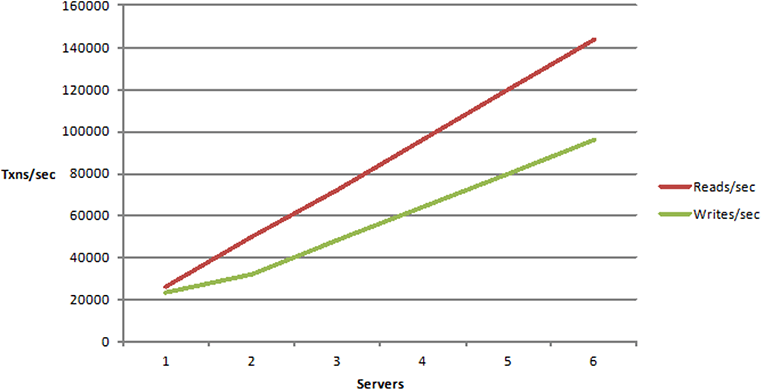
A escalabilidade linear é mais uma terminologia de arquitetura de implantação. Se sua aplicação está arquitetada de forma que você possa adicionar mais servidores para incrementar sua capacidade, sua capacidade de transação, aliás quando eu uso a palavra escalabilidade estou falando principalmente de capacidade de transação, não estou falando muito De dados. Portanto, não estamos falando de terabytes de dados em termos de escalabilidade. Estamos falando de você pode lidar com muitas transações, muita atividade. Portanto, uma escalabilidade linear significa que você pode aumentar sua capacidade de transação apenas adicionando servidores e não há gargalos e é isso que queremos alcançar.
Escalabilidade Não Linear
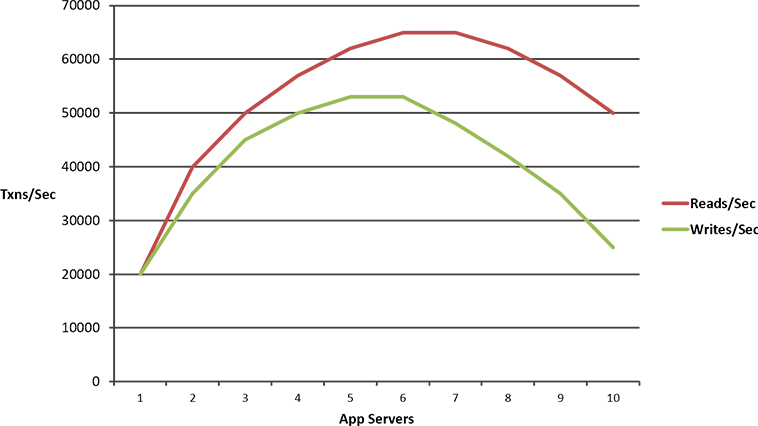
Não linear, é claro, não é algo que queremos alcançar. Isso significa que não importa quantos servidores você adicionar, seu desempenho cairá depois de um certo ponto, porque há algum gargalo fundamental na arquitetura do aplicativo em sua implantação, que está impedindo que você possa escalar.
Quais aplicativos precisam de escalabilidade?
Que tipo de aplicações precisam de escalabilidade? Geralmente são aplicações de servidor, como ASP.NET, ASP.NET Core, Web Services (normalmente WCF), back-end de IoT (geralmente Web Services, embora não seja obrigatório) e aplicações de processamento de Big Data. Essas geralmente são desenvolvidas em Java, mas se você as implementasse em .NET, enfrentaria os mesmos problemas que em Java e em qualquer outra aplicação de servidor que precise processar um grande volume de transações. Por exemplo, imagine um banco ou uma empresa de serviços financeiros com milhões de clientes. Eles ligam para solicitar a alteração de endereço, transferência de fundos, e à noite você precisa processar tudo isso para cumprir requisitos de conformidade ou outros SLAs. Portanto, mesmo que essas sejam aplicações de processamento em lote, de back-end, ainda assim serão suas outras aplicações de servidor capazes de processar essa quantidade de informações. Se não conseguirem, você terá sérios problemas.
O problema de escalabilidade
Se você possui esses aplicativos, muito provavelmente eles precisarão de escalabilidade. Então, vamos falar agora sobre onde está o problema? Onde está o problema de escalabilidade que vamos tentar resolver? O problema de escalabilidade não está na camada de aplicação. Seus aplicativos, todos aqueles que mencionei, geralmente são arquitetados de forma que você possa adicionar mais servidores sem nenhum problema. O problema está no armazenamento de dados. O que quero dizer com isso é onde os dados do seu aplicativo residem, seus bancos de dados relacionais. Isso pode ser SQL Server, Oracle, MySQL. Não se trata de um fornecedor específico. O conceito de bancos de dados relacionais, por definição, não permite escalabilidade. Na verdade, eles também não permitem escalabilidade em termos de quantidade de dados. É por isso que os bancos de dados NoSQL se tornaram tão populares, especialmente no lado das transações, e o mesmo se aplica a dados legados de mainframe. Muitos aplicativos precisam acessar dados legados. É aí que ocorre o gargalo e, se você tiver esse gargalo, não importa se essa camada é escalável, você não conseguirá escalar.
Os bancos de dados NoSQL se tornaram populares exatamente por esse motivo: eles oferecem escalabilidade. E, como você sabe, nós também temos um produto de banco de dados NoSQL, mas muitas vezes eles não resolvem o problema. Eles não podem resolver o problema porque, por uma combinação de razões técnicas e comerciais, você não pode usá-los. Para usar um banco de dados NoSQL, você precisa colocar os dados nele e não no seu banco de dados relacional. Alguns dados você pode, sem dúvida, colocar no banco de dados NoSQL, mas muitos dos seus dados comerciais tradicionais permanecerão em bancos de dados relacionais. Portanto, se você não puder migrar seus dados para bancos de dados NoSQL, eles não serão úteis. Então, você precisa resolver esse problema, tendo em mente que continuará usando bancos de dados relacionais, mesmo que inclua um banco de dados NoSQL, que representará apenas um subconjunto dos dados. Geralmente, não se trata de um substituto para bancos de dados relacionais. E, sendo uma empresa de bancos de dados NoSQL, sabe, vou ser bem honesto com você: quando conversamos com nossos clientes, não dizemos para pararem de usar bancos de dados relacionais, isso nunca vai acontecer. Dizemos para usá-los como um complemento aos bancos de dados relacionais. Então, se você precisa continuar com o banco de dados relacional, precisa resolver esse problema levando isso em consideração, e é aí que entra o cache distribuído. É por isso que estamos tendo essa conversa.
Implantação de Cache Distribuído (NCache)
Um cache distribuído, deixe-me definir isso um pouco. Um cache distribuído é distribuído. Ele vive em dois ou mais servidores, aqui. É uma camada de cache separada, logicamente falando. Fisicamente pode estar na mesma caixa que o aplicativo, mas logicamente é uma camada de cache separada. Dois ou mais servidores e um cache distribuído geralmente formam um cluster. Então, geralmente é um cluster desses, clusters baseados em TCP são os mais comuns. NCache definitivamente usa TCP para clustering. E, esse cluster significa que todos os recursos, todos esses servidores, a CPU, a memória, as placas de rede, estão todos agrupados. E é assim que isso se torna escalável. Porque você pode adicionar mais servidores, pois precisa aumentar a capacidade.
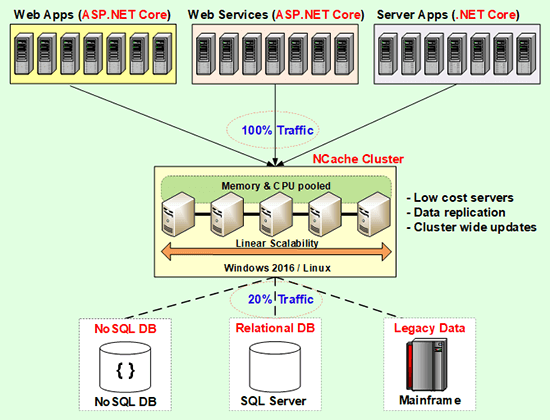
Isso é algo que você pode fazer aqui também. Mas, você não pode fazer aqui. Como eu disse, você pode adicionar outro banco de dados SQL na mistura, mas, você sabe, você precisa ter isso na imagem. Assim que você tiver isso na foto, você precisará de algo assim no seu mix.
Um cache distribuído vive em servidores baratos. Essas não são configurações típicas de servidor da Web de banco de dados high-end. A maioria dos nossos clientes tem uma caixa de 8 núcleos, é como se fosse uma CPU dupla, agora usamos apenas a palavra 8 núcleos e uma de 64 bits com muita memória. Lotes significa que 16 a 32 giga é praticamente a média por servidor que vemos. Nós nem recomendamos mais de 64 giga em cada caixa. Porque, se você tiver mais de 64 GB de memória, o .NET requer coleta de lixo. O próprio GC é uma tarefa bastante demorada e começa a se tornar um gargalo por si só. Então, é melhor ter mais servidores do que ter poucos realmente sofisticados. Porque, você sabe, mesmo que o cache seja distribuído por design, agora o gargalo começa a se tornar uma coleta de lixo. E aprendemos isso através de muitas experiências dolorosas ao longo dos anos. Você sabe, tivemos clientes que subiram para 128 GB e, de repente, houve muita pressão na CPU. Então, eles tiveram que aumentar um pouco seu poder de processamento e começou a parecer mais um banco de dados. Então, você sabe, recomendamos que derrubá-lo.
Você armazena em cache os dados que residem no banco de dados. E, basicamente, em 80% das vezes, você acessará a camada de cache e, nos outros 20%, o banco de dados. O cache é extremamente rápido na memória, muito mais rápido do que qualquer banco de dados, incluindo bancos de dados NoSQL, e até mesmo mais rápido do que o nosso próprio banco de dados NoSQL. NCache é pelo menos uma ordem de magnitude mais rápida do que qualquer banco de dados. Porque, você sabe, os bancos de dados têm que ir para o disco. Mas, é claro que todas as atualizações precisam ir para o banco de dados real. Então, é aí que vêm os 20% mais, é claro, algumas das leituras.
Agora, se você fizer isso, de repente toda a pressão sobre o banco de dados é aliviada. Agora ele tem um bom desempenho. Suas leituras são muito mais rápidas e as atualizações também. Portanto, você consegue alcançar essa escalabilidade, mas também consegue que o aplicativo não só seja escalável, como também mais rápido. Embora o principal motivo para usar um cache não seja melhorar o desempenho, o que é meio que o oposto do que as pessoas tradicionalmente pensam, sabe, que o cache existe para melhorar o desempenho. Isso, em uma situação independente, sim, é verdade. Mesmo os bancos de dados usam cache em memória. Nosso NosDB também usa cache integrado, mas é realmente para escalabilidade, onde você precisa ser capaz de usá-lo porque esse é um problema que você não pode resolver comprando hardware mais caro para obter escalabilidade. Você precisa arquitetar o aplicativo e usar a infraestrutura correta, ou os componentes certos, como parte da sua arquitetura, se quiser ter um aplicativo escalável.
Em Java, isso é chamado de grade de dados em memória. Em .NET, é chamado de cache distribuído. Outro termo para isso é armazenamento de chave-valor NoSQL em memória. Ou seja, existem três maneiras diferentes de analisá-lo. Não se trata de um banco de dados NoSQL, mas sim de um armazenamento de chave-valor NoSQL em memória. Isso porque ele não realiza persistência, não possui um armazenamento permanente.
Então, quando você tem uma imagem como essa, arquitetonicamente eu quero que você se convença de que agora você terá um aplicativo que nunca terá gargalos. Se você arquitetar seu aplicativo para usar isso como para sua infraestrutura. Qualquer dúvida, até agora antes de passar para mais profundidade.
Eu acho que depende dos detalhes como você sabe, se o cache está obsoleto ou se você atualiza algo fora do caso? Deixe-me chegar a isso. Boa pergunta.
Usos comuns do cache distribuído
Então, digamos que estamos convencidos de que precisamos ter um cache distribuído como parte de nossa arquitetura de aplicativo, a próxima pergunta que vem à mente é como você o usa? Onde você usa o cache e quais são os problemas relacionados a cada tipo de uso? Então, como desenvolvedor .NET, e novamente meu foco é .NET, mas os mesmos conceitos se aplicam a outros aplicativos também.
Cache de dados do aplicativo
O caso de uso mais comum é o cache de dados de aplicativos, é disso que eu estava falando até agora, onde você tem um banco de dados e apenas armazena dados em cache aqui. Portanto, o objetivo é não acessar o banco de dados com tanta frequência. E, você obtém todos os benefícios que eu falei. Assim que você faz isso, há um problema que ocorre, que é o que você acabou de falar. Os dados agora existem em dois lugares. Um deles é o armazenamento mestre permanente, que é seu banco de dados, onde sempre deve e o segundo é o cache. E, de fato dentro da cache ela existe em mais de um lugar e vou falar sobre isso também.
Então, quando os dados existem em mais de um lugar, o que pode dar errado? Sabe, pode ficar fora de sincronia. Portanto, se um cache distribuído não puder lidar com essa situação, você será forçado a armazenar em cache os dados somente leitura. Na verdade, a maioria das pessoas, quando pensam em cache, a reação do empurrão do joelho é apenas para dados somente leitura. Porque, se eu armazenar em cache dados que mudam, o que estou chamando de dados transacionais. Então vai sair de sincronia. E, se você sabe, aquele problema clássico de sacar um milhão de dólares duas vezes da mesma conta bancária, vem aqui. Então, você sabe, se um cache não resolver esse problema, você estará limitado a um subconjunto muito pequeno. Cerca de 10% a 15% dos dados é tudo o que você pode armazenar em cache e isso não é suficiente. Então, um bom cache distribuído deve resolver esse problema e falarei sobre isso.
Cache específico do ASP.NET
O segundo caso de uso é, se você tem um aplicativo ASP.NET, há três coisas diferentes que você pode armazenar nele. Claro que isso está mudando conforme novas estruturas estão surgindo. Então, o mais comum é o estado de sessão ASP.NET, que está lá tanto no núcleo ASP.NET quanto na estrutura ASP tradicional. Sessões são algo que por padrão você armazena In-Proc ou você as armazena no SQL Server. Ambos têm problemas de escalabilidade. SQL também tem problemas de desempenho. E, como bancos de dados relacionais não foram projetados para armazenar blobs e sessões são armazenadas como blobs. E segundo, você sabe, o mesmo motivo pelo qual você deseja armazenar em cache dados do aplicativo e não ir para o banco de dados, você também não deseja manter sessões no banco de dados. Então, este é um caso de uso muito, muito ideal para aplicativos ASP.NET. E, você sabe, essa é a primeira coisa que a maioria dos nossos clientes usa. Você sabe, se você tem um aplicativo existente e deseja incorporar cache distribuído, o menor esforço necessário para incorporá-lo são sessões. Porque o framework ASP.NET permite que um cache de terceiros seja plugado. Não há necessidade de programação. Você apenas faz uma alteração no web.config. Na verdade, deixe-me mostrar isso rapidamente. Vou apenas pular para frente e para trás.
Então, por exemplo, eu tenho esse pequeno aplicativo ASP.NET e tenho um web.config aqui e vou usar NCache como o exemplo, mas, digamos, para usar NCache como o provedor de estado da sessão, você precisa colocar esses assemblies. Então, “adicionar montagem” tag. Então, essa montagem de NCache implementou a interface do provedor de estado de sessão ASP.NET.
<?xml version="1.0" encoding="utf-8"?>
<configuration>
    <system.web>
        <machineKey validationKey="A01D6E0D1A5D2A22E0854CA612FE5C5EC4AECF24" decryptionKey="ACD8EBF87C4C8937" validation="SHA1" />
        <compilation defaultLanguage="c#" debug="true" targetFramework="4.0">
            <compilers>
                <compiler language="c#" type="Microsoft.CSharp.CSharpCodeProvider, System, Version=2.0.0.0, Culture=neutral, PublicKeyToken=B77A5C561934E089" extension=".cs" compilerOptions="/d:DEBUG;TRACE" />
            </compilers>
            <assemblies>
                <add assembly="Alachisoft.NCache.SessionStoreProvider, Version=4.6.0.0, Culture=neutral, PublicKeyToken=CFF5926ED6A53769" />
            </assemblies>
        </compilation>

        <customErrors mode="RemoteOnly" />
        <authentication mode="None" />
        <authorization>
            <allow users="*" />
        </authorization>
        <trace enabled="false" requestLimit="10" pageOutput="false" traceMode="SortByTime" localOnly="true" />
        <!-- For NCache Developer Edition replace 'myPartitionedCache' with 'myCache' or any other local-cache-->
        <sessionState cookieless="false" regenerateExpiredSessionId="true" mode="Custom" customProvider="NCacheSessionProvider" timeout="1">
            <providers>
                <add name="NCacheSessionProvider" type="Alachisoft.NCache.Web.SessionState.NSessionStoreProvider" exceptionsEnabled="true" enableSessionLocking="true" emptySessionWhenLocked="false" sessionLockingRetry="-1" sessionAppId="NCacheTest" useInProc="false" enableLogs="false" cacheName="myPartitionedCache" writeExceptionsToEventLog="false" AsyncSession="false" />
            </providers>
        </sessionState>
        <!--  GLOBALIZATION
        This section sets the globalization settings of the application.
		-->
        <globalization requestEncoding="utf-8" responseEncoding="utf-8" />
        <xhtmlConformance mode="Legacy" />
        <pages controlRenderingCompatibilityVersion="3.5" clientIDMode="AutoID" />
    </system.web>
    <system.webServer>
        <directoryBrowse enabled="true" showFlags="Date, Time, Size, Extension, LongDate" />
    </system.webServer>
</configuration>
Então, é assim que ele está em conformidade com a especificação do framework ASP.NET para ser um cache de terceiros. Então, essa é a primeira coisa que você faz e, em segundo lugar, você altera o namespace. Na verdade, você só usa essa tag. Então, você se certifica de que o modo é personalizado e o tempo limite definitivamente não é de um minuto. Deve ser 20. E, eu voltarei a isso. Esse é o nome do cache.
No caso de NCache, todos os caches são nomeados. Eu vou voltar a isso. Então, isso é tudo que você faz e seu aplicativo começa a armazenar as sessões em um cache. E você verá imediatamente um aumento de desempenho, porque é na memória, muito mais rápido que o SQL. Não mais rápido que o In-Proc, mas mais rápido que o SQL, mas mais escalável em ambos os casos.
O segundo caso de uso para o ASP.NET é o estado de exibição, ou seja, se você não estiver usando a estrutura MVC, se ainda estiver no ASP.NET herdado, você terá um estado de exibição, que pode ou não conhecer. Um estado de visualização, para quem não sabe, é uma string criptografada que é enviada pelo servidor da web para o navegador apenas para voltar quando houver um post back. Então, isso pode chegar a centenas de kilobytes de tamanho. Multiplique isso por milhões de solicitações que seu aplicativo precisa processar e há duas coisas ruins que estão acontecendo, uma é consumir muita largura de banda e a largura de banda não é gratuita. Ao hospedar seu aplicativo, você precisa pagar pela largura de banda. Segundo, o tempo de resposta é mais lento porque é uma carga muito mais pesada. Portanto, se você pudesse armazenar isso em cache em um servidor, isso eliminaria tudo isso e tornaria o aplicativo mais rápido.
O cache de saída é um framework asp.NET que permite que você armazene em cache a saída da página, de modo que, se a saída da página não mudar, ele apenas a pegará da última execução. Então, novamente, é melhor conectar um cache distribuído em um web farm do que manter cópias separadas desse cache de saída em cada servidor web. O que você quer fazer na verdade é tornar esses servidores web totalmente sem estado da perspectiva de gerenciamento de aplicativos. Se eles forem sem estado, você pode fazer todos os patches, você pode, você sabe, todas as correções de bugs, quaisquer atualizações para seu aplicativo, são muito mais frequentes do que quaisquer atualizações para o cache em termos de atualizações de software. Então, se não houver estado sendo mantido aqui, você pode remover qualquer uma dessas caixas do web farm, o usuário nem notará. Porque todo o estado está sendo mantido aqui ou no banco de dados e estes não são algo que você toca com tanta frequência, então, novamente, armazene em cache isso.
Agora, no caso de cache específico do ASP.NET, há uma coisa boa que tudo isso não requer programação. Então, basta conectá-los imediatamente sem nenhum esforço. A única coisa que você faz, é claro, é algum teste de sanidade. Por exemplo, estado de sessão ASP.NET, se você conectá-lo e estiver usando sessões In-Proc, poderá descobrir que nem todos os seus objetos são serializáveis. E você não sabia e, de repente, seu aplicativo começará a lançar exceções. Então, quero dizer, você sabe, esse nível de teste que você precisa fazer. Mas, agora há outro problema peculiar, diferente deste onde você tem duas cópias dos dados, agora os dados existem apenas no cache.
Então, quando uma loja na memória é sua loja principal, o que pode dar errado? Máquina cai. Sim, você sabe, se algum servidor cair, você perde dados e não quer perder nenhum desses dados, especialmente as sessões. Então, um bom cache distribuído deve resolver isso e isso geralmente é feito através da replicação de que os mesmos dados existem pelo menos em dois lugares e se isso não acontecer, por favor, não coloque nenhuma sessão nesse cache, a menos que você não, não é realmente... não importa se seus usuários usam esta sessão, o que não é o caso na maioria das situações.
Compartilhamento de dados em tempo de execução
O terceiro caso de uso é compartilhamento de dados em tempo de execução através de eventos. Isso é algo que normalmente as pessoas faziam com filas de mensagens, que você sabe, elas têm seu próprio lugar e um cache distribuído não está aqui para substituí-las, mas um cache distribuído é muito mais rápido, mais escalável e se as mensagens ou se houver o compartilhamento de dados sendo feito no mesmo local, no mesmo datacenter, então você pode usar um cache distribuído em um Pub / Sub maneira, você pode fazer isso. Existem também outros tipos de eventos que você pode, sabe, mostrar interesse em determinados itens. Diga, se este item mudar, por favor me avise. Ou em caso de NCache há um recurso chamado consulta contínua onde você também pode fazer uma instrução SQL e dizer, 'SELECIONE CLIENTES ONDE CUSTOMER.CITY = NOVA YORK'. Se esse conjunto de dados for atualizado, excluído ou se um novo objeto for adicionado, atualizado ou excluído, por favor, avise-me. Então, se esse tipo de monitoramento que o aplicativo pode fazer e é assim que os consumidores podem ser muito mais espertos sobre o que eles querem ser notificados. E os produtores podem continuar atualizando o cache.
Então, esse é o terceiro caso de uso que muitas pessoas não conhecem, mas agora está se tornando cada vez mais óbvio que o cache é um bom lugar para fazer isso. Porque você já está usando o cache por esses dois motivos. Então, por que não colocar isso e isso é muito simples de incorporar em seu aplicativo. Alguma dúvida, antes de entrar nos detalhes destes?
Demo
Então, vou mostrar primeiro como é um cache. Então, podemos colocar isso no contexto de tudo o que estamos falando. usarei NCache como o exemplo. Então, eu tenho um monte de VMs no Azure. Então, eu tenho um demo1, demo2 e um cliente de demonstração. Demo1 e Demo2 são minhas VMs de servidor de cache. O cliente de demonstração é a caixa do servidor de aplicativos. Então, esse é o cliente de cache. Então, eu tenho tudo isso.
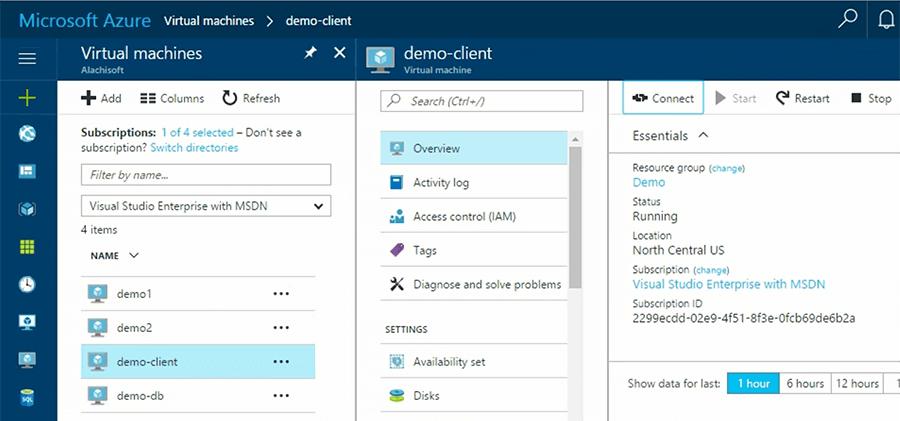
Eu vou e estou logado, digamos, estou logado no cliente de demonstração. Vou seguir em frente e criar um cache. Então, eu vou usar NCache Gerente, a ferramenta gráfica. Vou em frente e direi 'Criar um novo cache de cluster'.
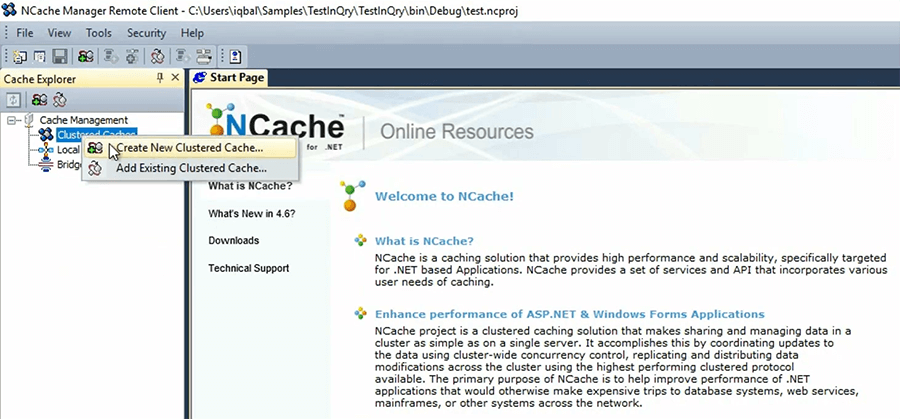
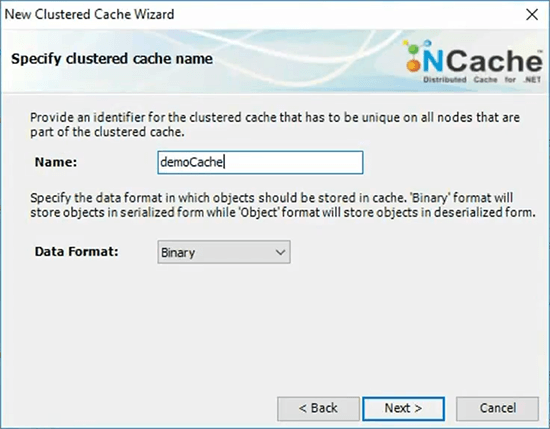
No caso de NCache, todos os caches são nomeados. Não vou explicar todos os detalhes. Vou apenas dar um nome a cada cache.
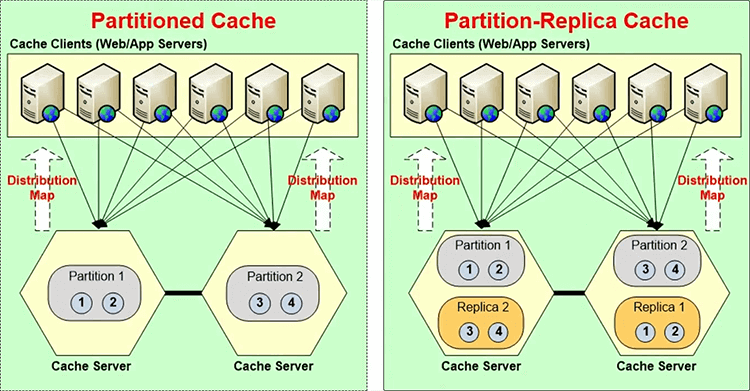
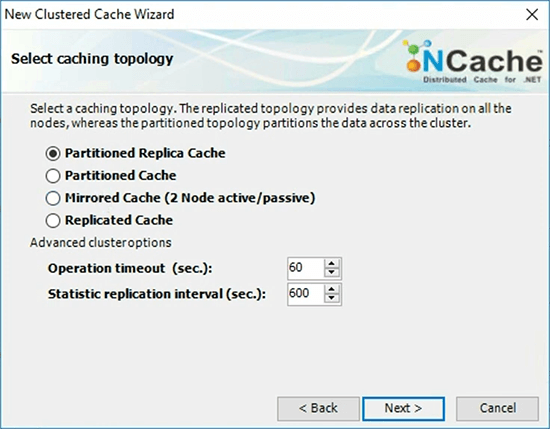
Vou escolher uma topologia do cache. topologia é na verdade uma estratégia de armazenamento e replicação. Assim, uma topologia, no caso de NCache, digamos, há uma topologia chamada réplica de partição. Então, esses dois são servidores de cache aqui e cada servidor tem uma partição. Então, digamos em caso de NCache, NCache cria uma partição para cada servidor e cada servidor contém uma réplica da partição de outro servidor. Cada partição contém um enésimo do número total de buckets. No caso de NCache há 1000 buckets por cache.
Então, digamos, se for um cluster de dois nós, são os 500 buckets cada, se for um cluster de três nós, é um terço, um terço, um terço.
Réplica de partição, as partições estão ativas, as réplicas não estão ativas, são passivas. Então, o cliente só fala com as partições e digamos que se um cliente for atualizar um item aqui, a partição vá em frente e o replica para a réplica e essa replicação por padrão é assíncrona. Porque, para obter escalabilidade real, você precisa ir para esse modelo de consistência eventual. Mas, em alguns casos, seus dados são muito sensíveis. Você sabe, você tem muitas empresas de serviços financeiros como bancos que usam NCache e seus dados são, na verdade, dinheiro. Então, eles não podem fazer consistência eventual nesse caso. Então, aí você tem que fazer a replicação síncrona, o que significa que a aplicação espera até que os dados sejam atualizados nos dois lugares. Se um servidor ficar inativo, digamos, se você tiver um cluster de três nós e o servidor 3 estiver inativo, a partição 3 estiver inativa, a réplica 3 ficará imediatamente ativa.
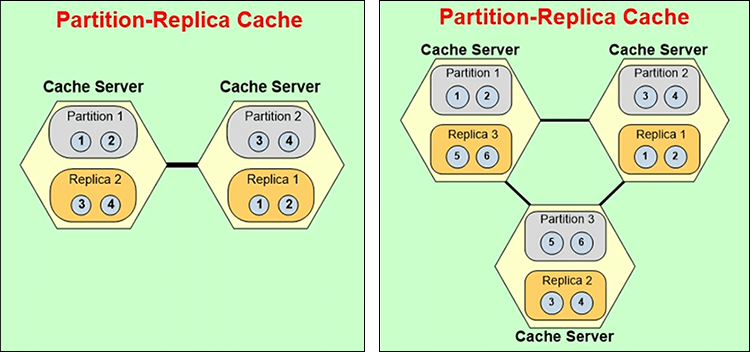
Então, é assim que você obtém a alta disponibilidade e agora, uma vez ativo, ele perceberá que existem apenas dois servidores e três partições, o que não é como deveria ser. Então, ele se fundirá com a partição 1 e 2 e, uma vez feito isso, uma réplica para a partição 2 será criada aqui.
Tudo isso em caso de NCache é feito em tempo de execução sem que seu aplicativo perceba que isso está acontecendo. Da mesma forma, você pode ter um cluster de 2 nós e adicionar um terceiro servidor e novamente todo o mapa mudará daqui para aqui automaticamente. Então, isso é o que essa escolha significava.
Então, eu só vou escolher réplica de partição como a topologia.
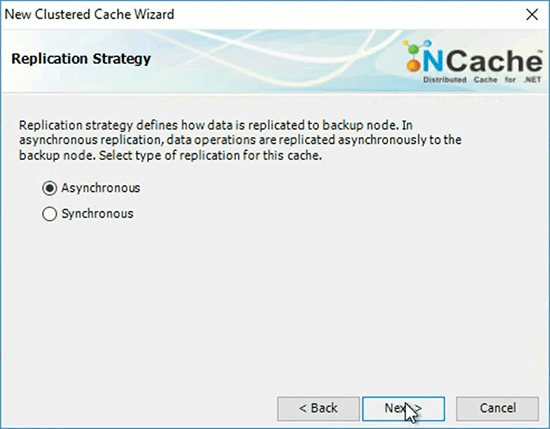
Vou manter a replicação assíncrona.
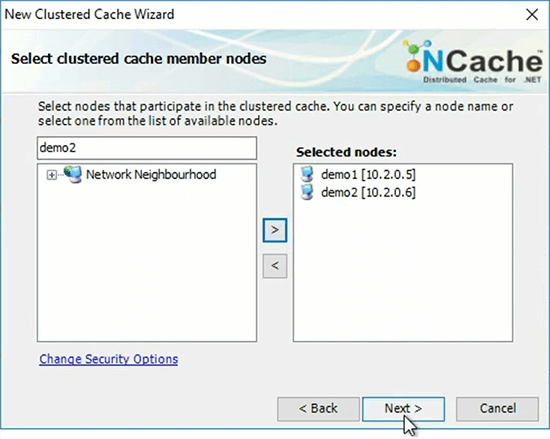
Eu vou escolher meu primeiro servidor que é o demo 1, o segundo servidor que é o demo 2.
Vou pegar todos os padrões. Vou especificar, vou dizer, é apenas 1 Gig, vou especificar o tamanho da partição.
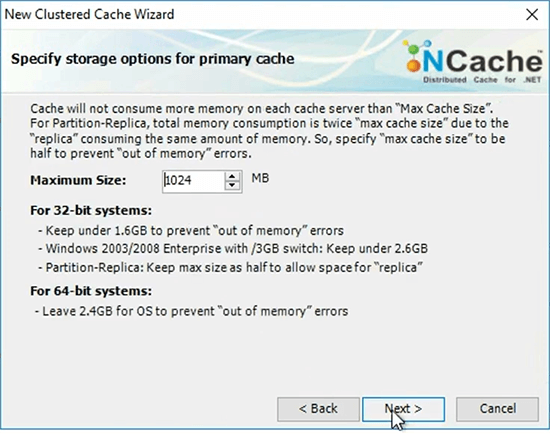
No seu caso se você tem uma máquina de 16 Gig, você deve deixar cerca de 2 a 2.5 Gig para o SO e outros processos e consumir todo o resto para o cache e qualquer que seja a memória que restar, metade dela deve ser partição ativa, metade dele é para a réplica.
Quando você está fazendo seu planejamento de capacidade, é muito importante que você aloque memória suficiente para que, no caso de sessões, as sessões tenham memória suficiente para ficar, caso contrário, quando o cache tiver usado toda essa memória, o cache será considerado cheio e, então apenas uma de duas coisas acontecerá, ou o cache rejeitará quaisquer novas entradas ou despejará algumas das entradas existentes. NCache fornece-lhe três algoritmo. Você sabe, o mais comum é usado menos recentemente.
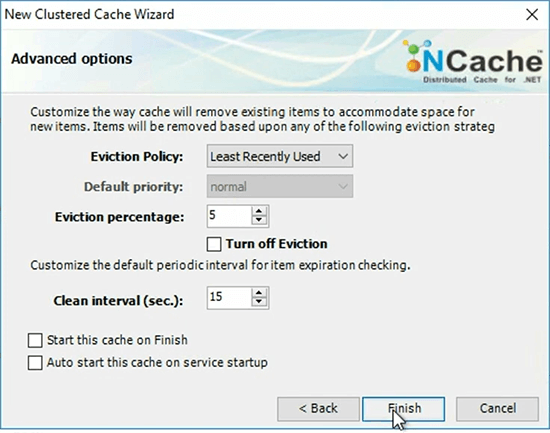
então, NCache irá despejar imediatamente 5% do cache, quando o cache for considerado cheio. Então, agora que eu criei isso, vou em frente e adicionar um nó cliente que, neste caso, é o cliente de demonstração e vou em frente e direi iniciar o cache.
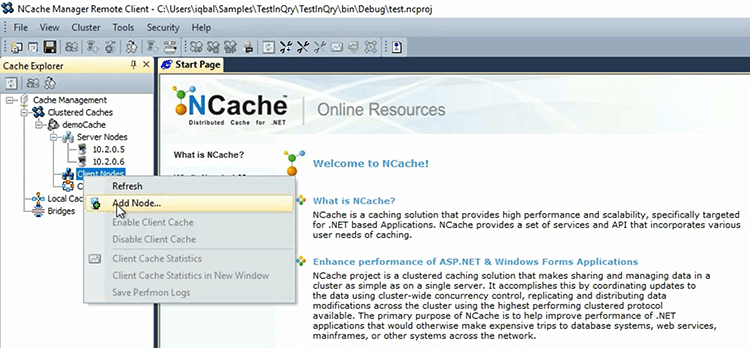
Então, quando estou iniciando o cache, muita coisa está acontecendo nos bastidores. Um novo cluster está sendo formado. A associação de cluster está sendo formada e está sendo propagada para o cliente. Então, que o cliente sabe o que é a associação do cluster? O que é o mapa de distribuição? Então, uma vez que tudo isso é feito, então tudo está pronto. Então, agora eu vou dizer estatísticas. Eu quero ver alguns PerfMon. E quero executar rapidamente essa ferramenta chamada ferramenta de teste de estresse, que é executada rapidamente. Ele testa rapidamente o cache em seu ambiente.
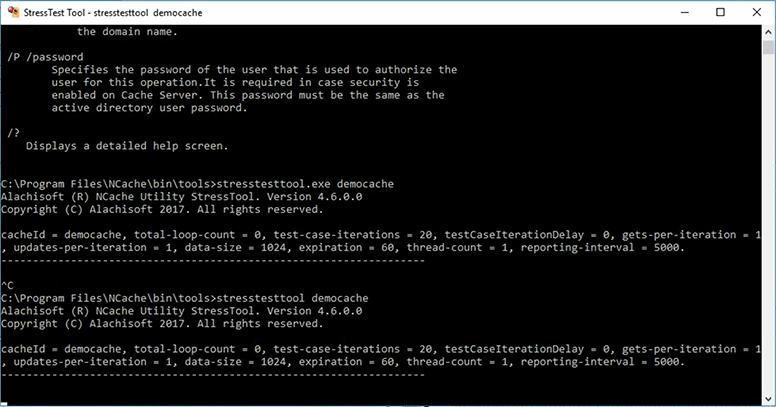
Então, dessa forma você não precisa fazer nenhuma programação para fazer isso. Então, é assim que o cache se parece. Você vai instalar algo assim. Digamos que você instale NCache. Leva apenas esse tempo para obter um cluster de 2 nós com um servidor de aplicativos configurado. No seu caso, você terá mais de um cliente, é claro. A configuração mais comum é de cerca de 5 a 8 clientes e cluster de cache de 2 a 3 nós. E então, você sabe, à medida que você adiciona mais clientes, você adiciona mais servidores.
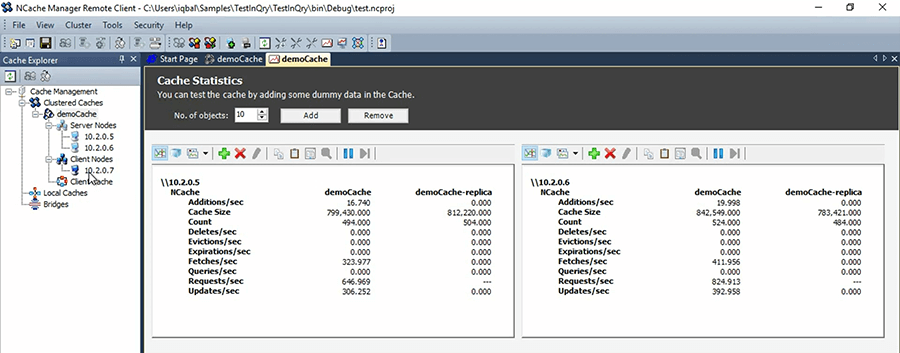
Então, agora que você tem esse cache em execução, agora vamos voltar aos nossos tópicos atuais. Então, agora tudo o que fazemos você precisa ter em mente como criamos esse cache nomeado. E eu já mostrei a você o estado de sessão específico do ASP.NET.
Visão geral do cache de dados do aplicativo (API)
Então, agora vamos para o cache de dados do aplicativo, que é a riqueza da minha palestra de hoje. Então, no caso de um cache de dados do aplicativo, há uma API que você tem que programar. Porque, o ASP.NET core agora tem uma interface chamada IDistributed Cache que você pode chamar essa API e então, nos bastidores, você pode conectar um cache de terceiros. No lado Java, eles têm uma API muito poderosa como um padrão chamado JCache, mas no lado .NET não há nada. Então, na maioria dos casos, você realmente precisará programar a API de cache real em si. Mas, a API é muito direta.
- Conexão de cache
ICache cache = CacheManager.GetCache("myCache"); cache.Dispose(); - Buscando dados
Employee employee = cache.Get<Employee>("Employee:1000"); bool isPresent = cache.Contains("Employee:1000"); - Gravando dados
cache.Add("Employee:1000", employee);
cache.AddAsync("Employee:1000", employee);

cache.Insert("Employee:1000", employee);
cache.InsertAsync("Employee:1000", employee);

Employee employee = (Employee) cache.Remove("Employee:1000");
cache.RemoveAsync("Employee:1000");
No caso de NCache isso se parece muito com o objeto de cache ASP.NET, se você notar. Então, o que você está fazendo basicamente é, você faz um cache.Get, você obtém o objeto, você sabe, cache dot Adicionar, Inserir, Remover ou e também existem versões assíncronas dele. Assíncrono significa não esperar que o cache seja atualizado apenas, você sabe, retornar o controle e você pode especificar a chamada de volta nesse caso.
Deixe-me mostrar rapidamente como é um aplicativo. Então, eu tenho esse aplicativo de console muito simples que usa NCache.
using System;
using Alachisoft.NCache.Runtime;
using Alachisoft.NCache.Web.Caching;
using Alachisoft.NCache.sample.data;

namespace BasicOperations
{
    public class BasicOperations
    {
        public static void Main(string[] args)
        {
            try
            {
            //Initialize cache via 'initializeCache' using 'Cache Name'
            //to be initialized.
            Cache cache = NCache.InitializeCache("demoCache");
            cache.Clear();

            //Another method to add item(s) to cache is via CacheItem  object
            Customer customer = new Customer();
            customer.Name = "David Johnes";
            customer.Age = 23;
            customer.Gender = "Male";
            customer.ContactNo = "12345-6789";
            customer.Address = "Silicon Valley, Santa Clara, California";

            DateTime calendar = new DateTime();
            calendar.AddMinutes(1);

            //Adding item with an absolute expiration of 1 minute
            cache.Add("Customer:DavidJohnes", customer, calendar, Cache.NoSlidingExpiration, CacheItemPriority.Normal);
            Customer cachedCustomer = (Customer) cache.Get("Customer:DavidJohnes");
            ...
Então, a primeira coisa que você precisa fazer é certificar-se de fazer referência aos conjuntos de cache que, em caso de NCache são dois. Há NCache.Tempo de execução, NCache.Rede e então você precisa usar os espaços de nome que novamente são dois no caso de NCache. NCache.Tempo de execução, NCache.Web.Caching. E, depois, no início da sua aplicação, que no caso de console está logo ali. No caso do aplicativo ASP.NET, este é provavelmente o seu global.asax. Você precisa se conectar ao cache e é aí que entra o nome do seu cache, seja qual for o nome que você deu ao seu cache. É isso que entra aqui. E, agora que você tem um identificador de cache, você pode prosseguir com o aplicativo, criar seus objetos e fazer cache.Adicionar. Você especifica uma chave baseada em string e a chave deve ser exclusiva. A propósito, esta não é uma boa chave. Sua chave precisa ser muito mais específica e aqui está seu objeto. E, quero dizer, é assim que e mais tarde você pode fazer cache.Obter e você pode obter seu objeto do cache.
Agora, esta chamada que você fez realmente resultou em caso de NCache, então, quando você fez cache.Adicionar, basicamente foi, a partir daqui foi para a partição em que os dados deveriam entrar. Então, ele fez cache.Add lá e esta partição então replicou esses dados para sua réplica. Se fosse um aplicativo assíncrono, apenas essa partição seria atualizada e o controle voltaria. Se você fez uma chamada assíncrona, até mesmo essa partição e nem esperou que a partição fosse atualizada. Mas, apenas aquele cache.Adicionar chamada resultou em todo esse trabalho sendo feito.
E, da mesma forma, quando você faz um cache.Obter o cliente vai diretamente para onde os dados estão. Então, ele usa o mapa de distribuição abaixo para saber onde estão os dados e vai diretamente para onde e obtém isso. Digamos que, se você quisesse o item número 3, você o pegaria imediatamente de lá.
Então, esse código está nos bastidores, é isso que realmente está acontecendo. Para o banco de dados. Qual é seu. É apenas o cachê. Na verdade, falarei sobre isso daqui a pouco também. Então, você serializou / deserializou automaticamente os dados? Sim, na verdade ainda mais do que isso. Portanto, antes que os dados sejam enviados daqui para aqui, o objeto deve ser serializado. No caso de NCache, NCache mantém em um formato serializado, no cache. E, quando você faz um cache.Get, ele volta e depois é desserializado no próprio cliente. E, no momento em que você o obtém, está tudo desserializado. Portanto, a API parece muito direta para você, mas há muito trabalho sendo feito.
Recursos de cache de dados do aplicativo
Agora, sobre o cache de dados de aplicativos, a maior preocupação era que os dados existissem em dois lugares, certo? E, se um cache não resolver essa preocupação, isso realmente limitará seu benefício. Então, como um cache aborda essa preocupação?
Expirações absolutas
O número um é chamado Vencimentos e existe o Expiração Absoluta o que significa expirar este objeto, digamos, daqui a 10 minutos. Então, você faz um palpite para cada objeto em termos de quanto tempo é seguro manter esse objeto no cache. E, ao final desse tempo, o cache remove automaticamente esse objeto.
Deixe-me mostrar como isso se parece no código. Então, em caso de NCache se você olhar para a mesma chamada cache.Add, o terceiro argumento é um argumento de data e hora que tem o valor de um minuto a partir de agora.
public static void Main(string[] args)
{
    try
    {
        //Initialize cache via 'initializeCache' using 'Cache Name'
        //to be initialized.
        Cache cache = NCache.InitializeCache("demoCache");
        cache.Clear();

        //Another method to add item(s) to cache is via CacheItem  object
        Customer customer = new Customer();
        customer.Name = "David Johnes";
        customer.Age = 23;
        customer.Gender = "Male";
        customer.ContactNo = "12345-6789";
        customer.Address = "Silicon Valley, Santa Clara, California";

        DateTime calendar = new DateTime();
        calendar.AddMinutes(1);

        //Adding item with an absolute expiration of 1 minute
        cache.Add("Customer:DavidJohnes", customer, calendar, Cache.NoSlidingExpiration, CacheItemPriority.Normal);
        Customer cachedCustomer = (Customer) cache.Get("Customer:DavidJohnes");
        ...
Então, está basicamente dizendo que o cache expire este objeto daqui a um minuto. Não importa se você precisa ou não, após um minuto esse objeto será removido do cache. Por quê? Porque você não se sente confortável em mantê-lo no cache por mais de um minuto. E, por que você não se sente confortável? Porque, você acha que vai mudar no banco de dados. Não é seguro mantê-lo no cache.
Expirações deslizantes
Há outro tipo de expiração chamado Expiração deslizante, que serve a um propósito totalmente diferente. Não é para manter o cache atualizado, é mais para limpeza. Assim, no caso de sessões, por exemplo, NCache usa uma expiração deslizante, que diz basicamente, você especifica um intervalo e diz 10 minutos, 20 minutos, 5 minutos, você diz. Então, por tanto tempo, se ninguém tocar nesse objeto NCache remove esse item do cache.
Portanto, expiração deslizante, embora o nome ainda seja expiração, serve a um propósito totalmente diferente. É a expiração absoluta que você precisa para o cache de dados do aplicativo para manter o cache atualizado. Quase todo cache tem a expiração absoluta. Incluindo Redis, todo mundo tem.
Sincronizar Cache com Banco de Dados
Mas, o problema com a expiração absoluta é que você está apenas fazendo um palpite. E se esse palpite estiver errado e os dados realmente mudarem no banco de dados. Então o que acontece? Temos que criar um mecanismo. Então, você sabe, se você tem a capacidade de sincronizar o cache com o banco de dados onde você pode dizer ao cache para monitorar o banco de dados em busca de alterações para esse conjunto de dados muito específico, seja ele qual for.
NCache, por exemplo, usa esse recurso de dependência de cache ADO.NET SQL. Onde, se você especificar, se você usar esse recurso, deixe-me mostrar como ele é usado. Se você usar esse recurso, então NCache monitora o banco de dados e solicita que o banco de dados notifique NCache quando esses dados mudam. Então, digamos, eu tenho o exemplo de dependência SQL. Então, novamente estou fazendo o mesmo cache.Add, aqui. Então, estou fazendo o mesmo cache.Add. Eu tenho uma chave. Agora, em vez de ter o objeto, eu tenho um item de cache que é uma estrutura que contém o objeto real mais algumas outras coisas. Assim, por exemplo, ele contém uma instrução SQL de uma única linha na tabela de produtos. Como estou armazenando em cache um produto em um banco de dados Northwind, esta instrução SQL, NCache então use.
private static void AddProductToCacheWithDependency(Product product)
    {
        // Any change to the resultset of the query will cause cache to invalidate the dependent data
        string queryText = String.Format("SELECT ProductID, ProductName, QuantityPerUnit, UnitPrice FROM dbo.PRODUCTS WHERE PRODUCTID = {0}", product.Id);

        // Let's create SQL depdenency
        CacheDependency sqlServerDependency = new SqlCacheDependency(_connectionString, queryText);

        CacheItem cacheItem = new CacheItem(product);
        cacheItem.Dependency = sqlServerDependency;

        // Inserting Loaded product into cache with key: [item:1]
        string cacheKey = GenerateCacheKey(product);
        _cache.Add(cacheKey, cacheItem);
    }
Então, há um Dependência de cache SQL aula em NCache que é nossa própria classe, mas nos bastidores ela mapeia para a dependência de cache ADO.NET SQL. Agora, você está fazendo esta ligação no real e então, você está fazendo a ligação, você precisa ligar aqui. E essa chamada está chegando aos servidores de cache e o servidor de cache agora faz a chamada ADO.NET no banco de dados do servidor SQL. E, agora, o servidor de cache se torna um cliente do seu banco de dados. E, ele diz ao banco de dados, ele diz, por favor, notifique-me se este conjunto de dados mudar.
E, o servidor SQL tem o mecanismo de notificação de banco de dados tipo de oráculo. Pelo menos nesses dois bancos de dados, você pode usar esse recurso. E a dependência de cache do SQL permite que você essencialmente tenha certeza de que, se não conseguir adivinhar, ainda pode ter certeza de que seus dados permanecerão consistentes com o banco de dados.
Alguma pergunta sobre isso? Então, você tem quaisquer componentes de estrutura. Então, NCache também tem um plugin para EF, EF6 e agora EF Core também, até EF Core. Antes do EF Core, o EF não tinha uma arquitetura conectável. Portanto, tivemos que implementar um provedor ADO.NET personalizado e armazenar em cache as consultas SQL.
SQL Core é uma arquitetura muito mais flexível. Então, agora podemos fornecer um cache L2. NHibernate, que é algo que existe há muito tempo. O NHibernate tem essa arquitetura há muito tempo. NCache forneceu o cache L2 para NHibernate e também para Hibernate para o cliente Java. Mas agora o EF Core tem essa arquitetura. Portanto, o benefício do EF Core é que você não precisa fazer essas chamadas. A desvantagem é, claro, que é um subconjunto muito pequeno do cache que você usa, em termos de recursos. Porque todas essas outras coisas, por exemplo, a parte de dependência do SQL é algo que NCache fornece e você pode configurar isso através dos arquivos de configuração, mas também muitos outros recursos sobre os quais falarei que você precisa usar, que se você apenas passar por uma arquitetura conectável, eles precisam passar pela abordagem do mínimo denominador comum. Portanto, sua API, qualquer que seja o uso, não pode usar muitos recursos sofisticados, mas agora todos os caches os fornecem. Então, e eles precisam ser flexíveis para todos. Considerando que, se você quiser se beneficiar, por exemplo, no lado Java, quase todos os caches têm todos esses recursos de que estou falando. No lado .NET quase nenhum deles tem além de NCache. Então, não é realmente um NCacheO problema é que o .NET não é tão avançado ou maduro quanto a comunidade Java na utilização dessas boas práticas. E isso está se tornando cada vez mais evidente. O fato de o .NET Core ter passado por uma mudança tão significativa é um ótimo indicativo de como as coisas vão melhorar.
Mas, a partir de hoje, não basta manter o cache sincronizado com as expirações do banco de dados. Você tem que ir além dos vencimentos. Você precisa sincronizar o cache com o banco de dados. E, se o banco de dados não suportar notificações, você pode passar pela abordagem de pesquisa, que é algo que NCache implementou.
Há uma terceira abordagem que é que você pode usar um procedimento armazenado CLR para adicionar diretamente os dados do banco de dados ao cache. Então, assim como você está invertendo todo o paradigma. Agora, o banco de dados está alimentando o cache. Então, você sabe, por exemplo, você tem um gatilho que pode fazer o... eu vou acelerar, senão eu não vou conseguir completar todos os tópicos. Portanto, esse é um recurso muito importante sem o qual você realmente não pode se beneficiar e também pode sincronizar o cache com fontes de dados não relacionais. Por exemplo, em caso de NCache há um recurso de dependência personalizado que é o seu código que pode fazer chamadas. Digamos que suas fontes de dados sejam uma nuvem e seja um método da Web chamado toda vez, para realmente saber quais são os dados. Então nada disso funciona e essa dependência personalizada é algo que funciona. Portanto, a dependência personalizada é seu código que reside no cache e é chamado pelo cache para verificar a fonte de dados.
Assim, depois de atingir esse objetivo, você pode começar a armazenar em cache mais e mais dados e realmente se beneficiar. Dependência de banco de dados, pois estou trabalhando com o mainframe agora, dependência de SQL ou dependência de Oracle não funciona. Então, com que frequência uma sondagem deve ser, porque estou trabalhando com dados de produção com vários milhões de transações de registros acontecendo em um minuto. Então, com que frequência. Então, como você sabe, com que frequência você pesquisa? A sondagem é um intervalo configurável e é o seu código que será chamado. Então, você determina em cada pesquisa, quantos dados você vai olhar. Porque, no caso de dependência personalizada, você vai realmente verificar uma chave específica e ver se essa chave foi atualizada em seu mainframe legado ou não. Então, é basicamente para cada chave quando vai como ok verifique esta chave, verifique esta chave. Em caso de dependência personalizada. No caso de dependência de banco de dados não é uma chave, é todo o conjunto de dados e temos outro recurso em NCache chamado atualizador de dados. Há um carregador de cache, é um atualizador de cache que é outro serviço onde seu código reside. Então, há um recurso chamado cache loader em NCache, que na verdade não mencionei todos esses recursos aqui, mas há um recurso chamado cache loader que é o seu código que pode, quando você iniciar o cache, carregar o cache, pré-carregar o cache da sua fonte de dados. Então, isso poderia ser o seu mainframe. Mas também há um recurso chamado atualizador de cache que chama automaticamente seu código a cada intervalo configurável e esse código pode verificar toda a fonte de dados e procurar atualizações com base em sua lógica personalizada e quaisquer dados alterados ou novos dados. ocorreu ou quaisquer dados foram excluídos, isso é algo que você também pode atualizar o cache. Assim, o cache permanece sincronizado com sua fonte de dados. Por padrão, eles são chamados em intervalos de cerca de 15 segundos. Mas, pode ser mais rápido. Pode ser mais frequente ou menos frequente, isso depende das suas necessidades. Eu respondi sua pergunta? Eu tenho mais, mas vou pular isso. Podemos falar sobre isso mais tarde.
Leitura e escrita
Assim, quando você atingir esse objetivo, começará a armazenar em cache mais e mais dados. Então a próxima coisa é, ok, agora você tem, que outros benefícios você pode alcançar? A próxima coisa mais importante é a leitura, escrita. O que é leitura? É novamente o seu código que fica no servidor de cache. Então, quando você faz um cache.Get, Então, digamos, um read-through é o seu código, no caso de NCache você implementa essa interface chamada IReadThruProvider. Tem três métodos.
...
// Perform tasks like allocating resources or acquiring connections
public void Init(IDictionary parameters, string cacheId)
{
    object connString = parameters["connstring"];
    sqlDatasource = new SqlDatasource();
    sqlDatasource.Connect(connString == null ? "" : connString.ToString());
}

// Perform tasks associated with freeing, releasing, or resetting resources.
public void Dispose()
{
    sqlDatasource.DisConnect();
}

// Responsible for loading an object from the external data source.
public ProviderCacheItem LoadFromSource (string key)
{
    ProviderCacheItem cacheItem = new ProviderCacheItem(sqlDatasource.LoadCustomer(key));
    cacheItem.ResyncOptions.ResyncOnExpiration = true;
    // Resync provider name will be picked from default provider.
    return cacheItem;
}
...
Existe um Init que é chamado quando o cache é iniciado, descartado quando o cache para, mas o mais importante é essa carga. Então, a carga é chamada de passa. Então, o cache chama esse método. NCache chama esse método e passa sua chave. E, com base nessa chave, você acessa seu banco de dados e busca esse item. Então, quando você faz isso agora o efeito líquido para o cliente, o aplicativo é, toda vez que você faz um cache.Obter, o cache sempre terá os dados. Claro que se você não quiser que o read-thru seja chamado, você também pode fazer isso, você pode ter detalhes. Mas, o cache sempre tem os dados. Então, esse é um benefício. Então, você está consolidando sua camada de persistência em uma camada de cache. Então, se você tem vários aplicativos usando a mesma camada de cache, você sabe, o aplicativo está se tornando mais simples porque eles não precisam manter o mesmo código de persistência. Eles apenas fazem um cache.Obter e eles obtêm o objeto de domínio ou o objeto de entidade do cache. Então, o cache está muito mais parecido com um EF agora. A leitura em si pode ser baseada em EF.
A outra coisa que você pode fazer com a leitura é combinar isso com expirações e sincronização de banco de dados. Então, quando essas duas coisas acontecem, em vez de remover esses dados do cache, por que não recarregá-los? Porque, quando você removê-lo, o aplicativo terá que recarregá-lo de qualquer maneira, na próxima vez que quiser. E, em muitos casos, esses dados podem ser usados com muita frequência. Então, você realmente deseja recarregá-lo de volta no cache. Assim, uma leitura não apenas consolida o código, mas também melhora seu desempenho porque seu banco de dados não está sendo atingido. Em muitas das situações de comércio eletrônico, os mesmos dados podem ser acessados com tanta frequência que, assim que você os remover do cache, milhares de solicitações chegarão ao banco de dados para os mesmos dados e já vimos clientes reclamarem disso. Isso continua acontecendo com tanta frequência porque existem milhões de itens de dados à medida que cada item de dados expira e o banco de dados é atingido. Então, no geral, mesmo depois de ter o cache, eles estavam vendo muitos acessos no banco de dados. Então, a resposta para isso foi recarregar em vez de expirar. Portanto, o recarregamento significa que os dados nunca saem do cache, apenas são atualizados. Portanto, o banco de dados nunca é tocado, exceto por uma chamada de banco de dados que o cache faz. Então, a leitura é super importante nesse sentido.
O outro é o write-through que funciona exatamente como o read-through, exceto que ele faz a escrita. E, a gravação significa que pode ser adicionar, atualizar ou excluir. Agora, a escrita tem outro recurso. Um benefício do write-thru é o mesmo do read-thru, que é a consolidação do código.
write-behind
O segundo benefício é chamado write-behind. Você sabe, as atualizações do banco de dados, assim como as leituras do banco de dados, não são rápidas. As atualizações do banco de dados também não são rápidas. Então, se seus dados não forem tão sensíveis, se não for algo que você tenha que esperar que o banco de dados seja atualizado, você pode apenas atualizar o cache. Assim, todas as instâncias do aplicativo têm os mesmos dados agora e permitem que o cache atualize os dados para o banco de dados de maneira assíncrona. E, de repente, o desempenho do seu aplicativo melhora porque você não está esperando que o cache seja atualizado. Portanto, o write-behind tem esse benefício adicional. Então, ele constrói a fila. No caso de NCache essa fila é replicada para vários servidores, mas novamente leitura-através de gravação é um recurso muito importante. E, isso também é algo que é o seu código que vive no servidor de cache.
Quero que você tenha isso em mente, todo esse carregador de cache, o atualizador, a dependência personalizada, a leitura, a gravação, tudo o que é código do servidor que vive nele. O que é algo que... novamente, esses recursos também existem no lado Java. Então, não é apenas algo que NCache inventado, mas você não obterá esses recursos em nenhum dos outros caches básicos do .NET.
Então, uma vez que você começa, uma vez que você tem tudo isso, uma vez que você faz isso, agora você coloca muitos dados no cache. Realmente começando a se beneficiar. E, se um cache é apenas acesso a valor-chave, você sabe, não é muito amigável. Portanto, um cache deve acomodar maneiras amigáveis de buscar dados.
Agrupamento de dados
Então, no caso de NCache há muitos dados que você pode fazer, você pode fazer grupo e subgrupo, tags, tags de nome. Você também pode pesquisar com base em SQL ou LINQ. Então, você pode fazer algo como, 'SELECIONE CLIENTES ONDE CUSTOMER.CITY = NOVA YORK'. E agora, de repente, muitos dos seus conjuntos de dados, especialmente os dados de referência que você precisa ler repetidamente de uma maneira mais filtrada, podem buscá-los diretamente do cache. E agora você tem o benefício dos dados que deseja fazer.
Uma coisa, lembre-se, sempre que você faz uma pesquisa SQL, todo o conjunto de dados deve existir no cache. Porque isso não irá para o banco de dados. Assim, ele irá apenas pesquisar o cache. Digamos, se você dissesse me dê todos os clientes baseados em Nova York. Se todos os clientes não estiverem no cache, se todos os clientes de Nova York não estiverem no cache, o NCache ou qualquer cache não fornecerá o conjunto de dados correto de volta. Então, é importante ter em mente que as pessoas muitas vezes confundem isso bem se eu pesquisar, se eu esperar, se não estiver no cache, vamos buscá-lo no banco de dados. Mas, as consultas SQL não são as consultas SQL do banco de dados. Essas são as próprias consultas do cache.
Agora muitos dados, você pode manter todo o conjunto de dados no cache, especialmente os dados de referência e é aí que você os usaria. Mas, pelo menos também dentro dos dados transacionais, existem subconjuntos que podem ser totalmente mantidos no cache. Então, é assim que você espera. Então, mantendo tudo isso em mente, agora você está começando a se beneficiar do cache.
Cache de cliente
Eu vou entrar em mais uma coisa que é esse recurso chamado Cache de cliente. Uma das coisas que as pessoas ficam realmente chocadas quando começam a usar um cache distribuído é que, se estivessem especialmente se estivessem usando um cache In-Proc antes, isso é autônomo, é que seu desempenho realmente cai. Então, muitos clientes nos ligam e dizem, você sabe, você estava dizendo isso, o desempenho vai aumentar, a escalabilidade vai melhorar, nosso desempenho realmente caiu. E, a razão é porque inicialmente eles tinham apenas um cache autônomo. Era limitado em tamanho, mas o cache estava em forma de objeto, os objetos eram mantidos em seu heap e agora eles têm que ir para um cluster de cache, há uma serialização, desserialização, houve uma viagem de rede, é muito mais lento.
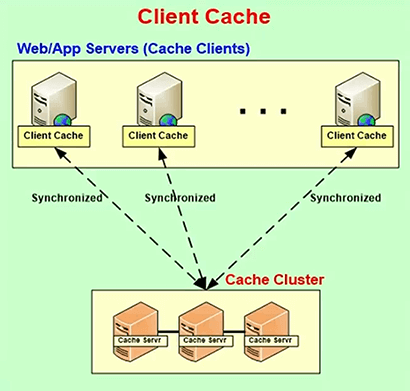
Então, para trabalhar para corrigir esse problema, muitos dos caches, novamente eu uso a palavra muitos porque todos os caches do lado Java têm, o lado .NET NCache tem. Eles têm esse recurso chamado cache do cliente. No lado Java, é chamado de cache próximo. Este é o mesmo cache autônomo que você tinha anteriormente, mesmo significa semelhante, mas agora está ciente do fato de que faz parte desse cache clusterizado. Portanto, quaisquer que sejam os dados que estão sendo mantidos, estão sendo sincronizados com eles com o cluster de cache. Então, ele apenas se conecta sem que você faça nenhuma programação.
Portanto, com a ajuda de um cache de cliente, você pode obter esse desempenho de cache autônomo In-Proc e é muito bom para muitos dados em que você está fazendo muito mais leituras do que gravações. Você não quer usar isso para algo como sessões. Porque, nas sessões você faz uma leitura e uma escrita. Portanto, você precisa fazer muito mais leituras do que gravações para se beneficiar.
Cluster de cache dinâmico
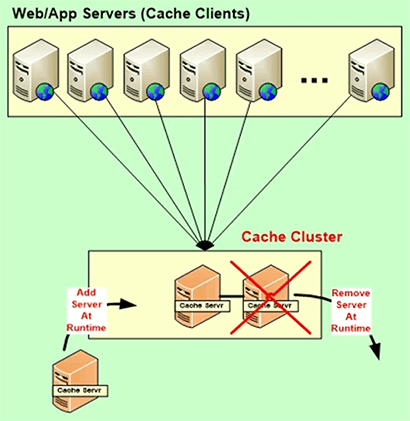
Então, arquitetonicamente, você precisa ver que o cache é como o banco de dados agora. Ele mora em seu datacenter, seu ambiente de produção e se sua aplicação tem uma necessidade de alta disponibilidade então o cache também deve estar altamente disponível, caso contrário você sabe, você tem um problema. E a única maneira de fazer isso é se o cache garantir 100% de tempo de atividade. Então, um bom cache, no caso de NCache ele tem uma cluster de cache dinâmico. É uma arquitetura ponto a ponto. Você pode adicionar ou descartar qualquer servidor e está tudo bem, nada para. O cache não para, o aplicativo não para.
Escalabilidade linear com replicação
Então, nós conversamos sobre a partição e então o topologias já. A replicação tem que ser feita de forma inteligente. Portanto, no caso de réplica de partição, ele faz apenas uma cópia. Assim, os dados existem apenas em dois lugares e não mais do que dois, porque cada vez que você faz cópias custa mais tempo ou esforço. Isso atrasa as coisas.
Replicação WAN de Cache Distribuído
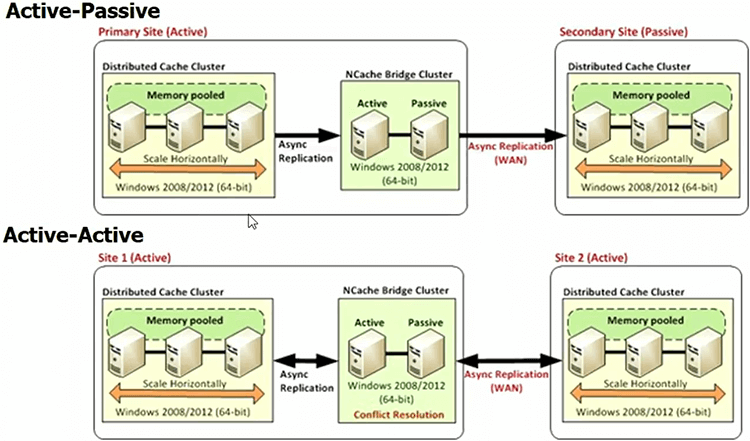
Há também um recurso chamado Replicação de WAN. Muitas pessoas têm vários datacenters agora. Se você espera que seu banco de dados seja capaz de lidar com vários datacenters, por que não o cache? Este é um recurso que a maioria dos caches Java possui, NCache tem também, mas apenas no lado .NET.
NCache vs Redis
Apenas rapidamente uma última coisa que é, já que, no lado .NET, você sabe, existem realmente apenas duas opções. Um é NCache, um é Redis. Redis na verdade, é mais de um cache baseado em Linux, mas, desde que a Microsoft fez parceria com eles no Azure, eles certamente se tornaram muito mais populares. Então, eu queria dar como uma comparação justa.
A propósito, se você for ao nosso site e for para o página de comparações e vai para recurso detalhado por comparação de recursos com base em sua documentação e nossa documentação e veja todas as coisas. E, isso não é um, você sabe, nós não estamos cuspindo isso e você pode ser um bom juiz disso. É apenas para tornar seu trabalho mais fácil de preparar.
Mas, ambos são de código aberto, mas NCache é .NET nativo para pessoas .NET, você sabe, toda a sua pilha é .NET. NCache permite que você tenha código .NET no lado do servidor que você não pode fazer com Redis. E, você sabe, se você estiver no Azure, Redis está disponível apenas como um cache como serviço, enquanto que intencionalmente não escolhemos esse modelo. Porque, no cache como serviço, o cache é uma caixa preta. Portanto, você não tem nenhum dos recursos do lado do servidor sobre os quais acabamos de falar. E com o modelo VM você tem controle total.
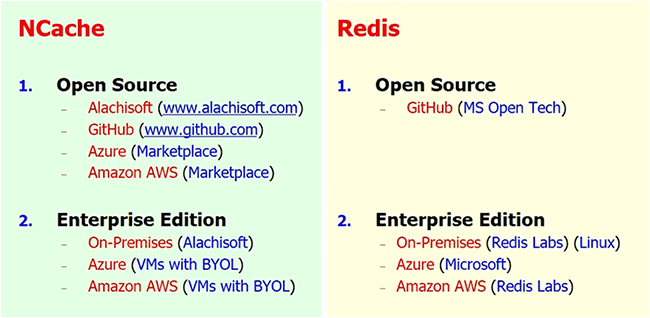
A maioria de nossos clientes são empresas de alto nível que realmente não querem abrir mão de seu controle. É como banco de dados SQL versus servidor SQL. Então com NCache, você sabe, você vai controlar todo o seu ambiente e é como você viu, é bem simples de fazer. Mas você obtém todos esses recursos do lado do servidor com NCache, o que você não faz porque com Redis porque você não tem acesso.
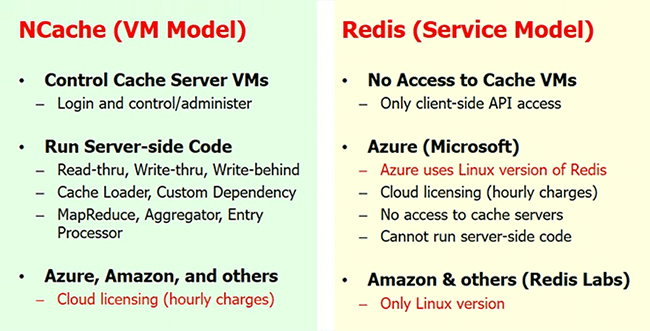
Portanto, decida-se novamente, mas no mínimo use um cache distribuído em sua arquitetura. Certifique-se de que está pronto para escalar. Esse é todo o objetivo. Muito obrigado.