裂脑集群恢复,实现 100% 正常运行时间
NCache 是一款适用于 .NET、Java、Python 和 Node.js 的极速且可扩展的内存分布式缓存。它广泛应用于关键任务应用程序的生产环境。为了保证高可用性和 100% 的正常运行时间, NCache 提供了丰富的高可用性功能。其中一项功能是能够检测并解决集群中的“脑裂”,以防止任何停机。
什么是裂脑集群?
NCache 创造一个 自愈动态缓存集群 由多个通过 TCP 相互通信的服务器组成。所有缓存服务器在集群中互连。其成员关系在运行时维护,并与服务器和客户端共享。
然而,与任何分布式系统一样, NCache 集群可能会遇到这样的情况:一台或多台缓存服务器在运行时与集群中其他服务器断开连接。这通常是由于网络故障造成的。
当这种情况发生时,每组缓存服务器都会认为自己是原始缓存集群中幸存的服务器,并假设其他缓存服务器已宕机。因此,医学术语“脑裂”指的是左脑无法感知右脑的情况。缓存客户端也可能以类似的方式分裂,或者它们可能继续根据原始集群成员身份与所有缓存服务器通信。
如果没有自动恢复机制,脑裂情况会导致数据不一致和完整性冲突,因为两组独立的客户端同时更新同一数据的不同版本。
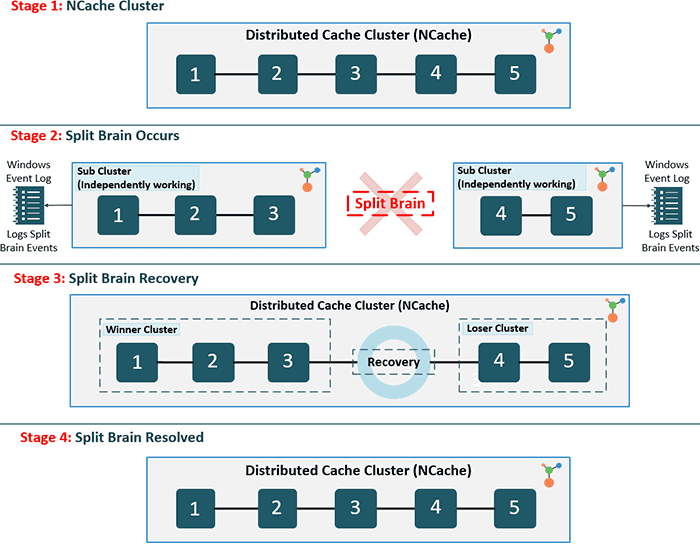
缓存集群中的裂脑

这会导致错误 缓存操作 最重要的是数据完整性问题。每个“拆分集群”现在都有自己的数据副本,并由客户端独立更新。最终,同一数据的两个或多个副本会在没有任何同步的情况下进行更新,从而导致不一致。
创新中心 NCache 检测分布式集群中的裂脑现象?
NCache 能够自动检测集群何时发生裂脑。通常,缓存管理员使用 NCache 管理中心 或必要的 PowerShell 命令 从集群中删除缓存服务器时,这些事件会被记录下来。因此,在发生脑裂的情况下,每个子集群 记录事件 向 Windows 事件日志中记录一些原始成员已经离开的情况。因此,如果发生裂脑, NCache 管理员看到几乎所有缓存服务器的“节点离开”事件,并尝试重新连接“丢失的服务器”。
只有当分裂子集群之间的网络连接恢复时,它才会发现发生了裂脑。此时,每个子集群都会在 Windows 事件日志中记录事件,并通过 电子邮件通知 发生了脑裂。
如何 NCache 裂脑自动恢复功能?
通过以下方式启用裂脑恢复 配置文件 通过添加 标签下 标签。设置为 True 时,可以检测可能的集群裂脑问题。不过,此功能仅适用于分区-副本拓扑。
<cache-settings...>
  <split-brain-recovery enable="True" detection-interval="60"/>
</cache-settings>
在检测阶段, NCache 它使用基于 TCP 的心跳机制来监控节点健康状况。如果发生网络分区,集群会根据配置的机制识别分区。 检测间隔一旦检测到, NCache 应用多数节点规则或复杂集群规则来确定“获胜者”。
NCache 根据以下标准确定获胜集群:
- 多数原则: 节点数最多的子簇被指定为获胜者。
- 复杂性规则: 如果节点数量相等,则内部配置和连接性最复杂的子集群获胜。
如果用户在裂脑情况下配置了自动恢复,则所有子集群将相互协商,确定“胜者”。协商完成后,其他子集群将丢弃其数据,并充当新节点加入现有集群,从而加入该集群。
确定哪个子集群获胜的规则很简单。获胜的子集群是成员节点数量最多的子集群。如果多个子集群的成员节点数量相同,则协调器 IP 地址最小的子集群获胜。