NCache 高可用性デモ
このビデオは、 NCache 100%の稼働時間とデータの信頼性を提供することにより、データの高可用性を維持します。 この特定のデモでは、実行中のキャッシュクラスターからキャッシュサーバーノードを開始および停止し、その方法を示します。 NCache クライアントアプリケーションのダウンタイムやデータ損失なしに、これを正常に処理します。
今日は、高可用性を実現する方法についてお話します。 NCache そしてどうやって NCache 高可用性を提供します。 あなたが知っているように、 NCache ダウンタイムを許容できないミッションクリティカルなアプリケーションで使用されます。
これは、複数のサーバーからなるキャッシュクラスターを使用しているアプリケーションサーバーファームと、複数のデータソースが存在する状況を示しています。通常、これらのキャッシュサーバーは少なくとも2台以上あります。
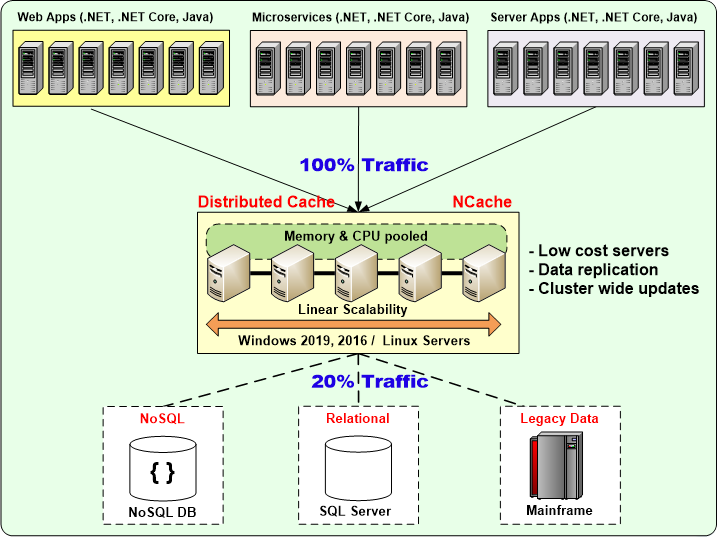
と、 NCache あなたに提供します 動的キャッシュクラスタリングアプリケーションを停止せずに実行時にキャッシュサーバーを追加または削除できる。 NCache ピアツーピアアーキテクチャを採用しています。本日のビデオでは、その仕組みを実演します。
パーティション・レプリカ・トポロジを使用します。このトポロジでは、サーバーを1台ずつ追加していくことになりますが、このトポロジでは各サーバーに1つのパーティションが存在します。サーバーを1台追加した場合、パーティションは1つだけで、レプリカも同じパーティション上に存在します。あるいは、レプリカが存在しない場合もあります。2台目のサーバーを追加すると、パーティションが2つになります。つまり、キャッシュのデータ全体が半分ずつに分割され、各パーティションは異なるサーバーに複製されます。
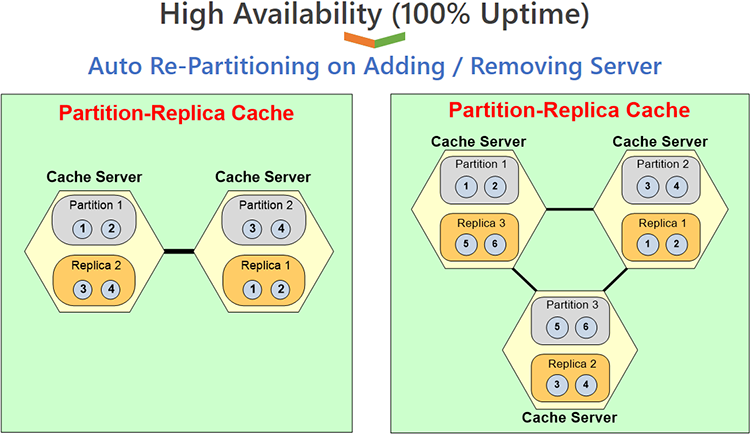
そして、3台目のサーバーを追加すると、パーティションが3つになり、同じデータが3つのパーティションに分割されます。各パーティションには、データの半分ではなく3分の1のデータが格納され、各パーティションは異なるサーバーにバックアップされます。それでは、これを実際にデモンストレーションしてみましょう。
実行時にクライアントとサーバーを追加する
早速製品の説明に入りましょう。3台のキャッシュサーバーを使用します。最初は1台から始めて、徐々に追加していきます。そして、クライアントが1台あります。実は今、クライアントマシンで作業しています。これをクリックして、 NCache Webマネージャウェブベースの管理ツールです。現在、 NCache インストールすると NCache. インストールしたので NCache これら3つのサーバーすべてに「デモキャッシュ」がインストールされていました。それでは実際にデモキャッシュを起動してみましょう。デモキャッシュが起動しているのが確認できます。
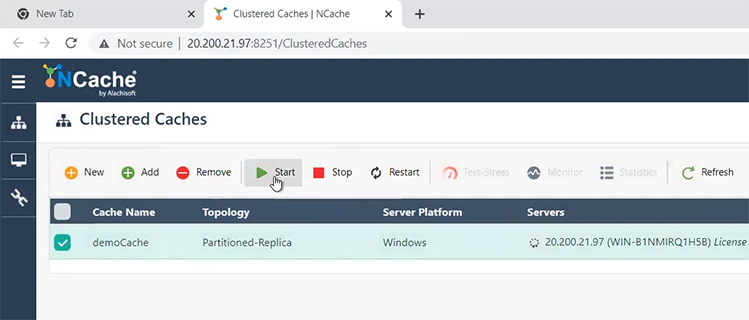
起動したら、統計情報とキャッシュの監視も行います。監視機能は非常に便利なダッシュボードを提供します。サーバーダッシュボードとレポートダッシュボードがあります。レポートダッシュボードは統計ウィンドウとよく似ています。ここではサーバーダッシュボードのみを表示し、そのままにしておきます。これでクライアントを実行できるようになりました。次はクライアントを実行します。
NCache PowerShellベースのストレステストツールが付属しています。それでは、単語を入力するだけです NCachePowerShell管理ツールがあるので、「Test-stress」を実行し、キャッシュの名前「democache」を入力します。テストストレスデモキャッシュ'。キャッシュ名は大文字と小文字が区別されないため、好きなように入力できます。
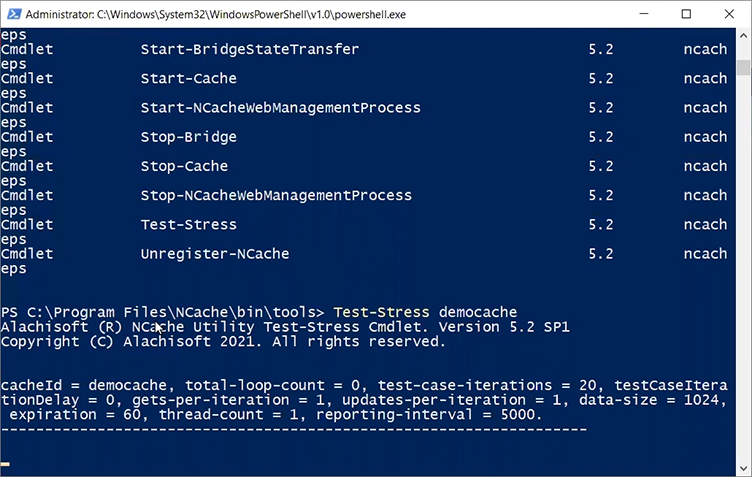
アプリケーションを起動すると、これがストレステストツールになります。これが表示されているのは、テストを開始するためにプログラミングを行う必要がないためです。 NCacheこのストレステストツールを使えば、ストレスをシミュレートすることもできます。それがストレステストツールと呼ばれる理由です。さて、これがあなたのアプリケーションだと想像してみてください。
さて、統計ウィンドウを見ると、約400個のアイテムがあり、それが増え続けていることがわかります。この981つのクライアントからのリクエストは1000秒あたり約XNUMX件、つまり約XNUMX件です。
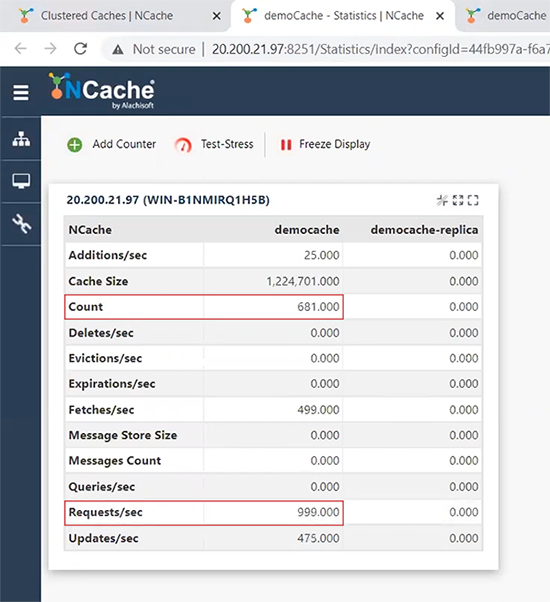
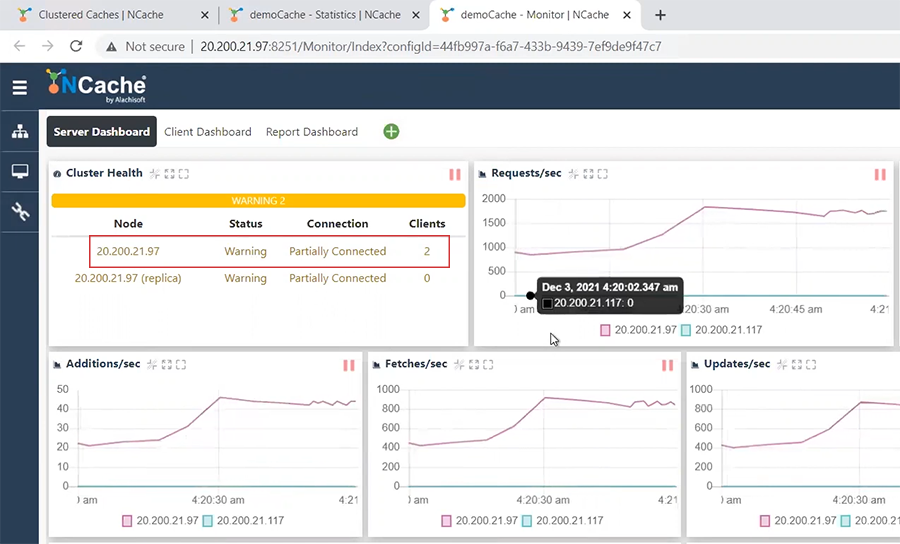
2つ目のクライアントアプリケーションを実行します。複数のストレステストツールインスタンス、またはPowerShellインスタンスを起動することで、複数のクライアントを追加できます。ここでもう一度、 テストストレスデモキャッシュこれを実行すると、リクエスト数がほぼ倍増していることがわかります。これは、この図でご覧いただいたように、各クライアントが独自のトランザクション負荷をサーバーに投入しているため、サーバーのトランザクション容量がほぼ倍増したためです。また、サーバーダッシュボードを見ると、1ノードのキャッシュクラスターに2つのクライアントが接続されていることが分かります。
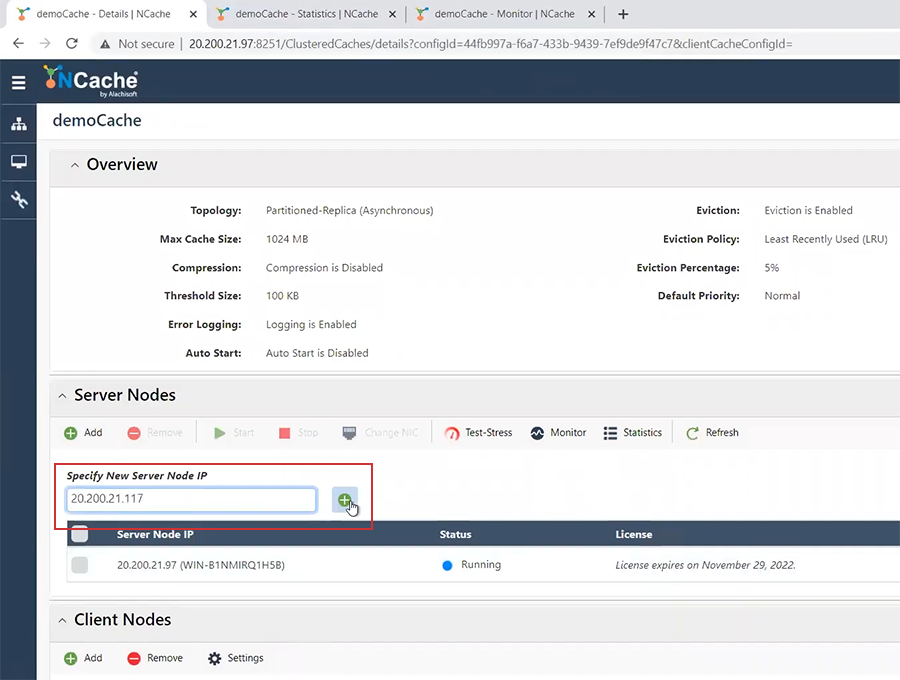
現在使用しているクラスター内のサーバーは1台だけです。さて、実際の運用では、キャパシティが増加していくと仮定してみましょう。ちなみに、キャッシュサーバーは最低2台必要となります。つまり、このクラスターではキャッシュサーバーを1台だけ稼働させるべきではありません。今回は1台からスタートして、実行時に2台追加して様子を見てみたいと思います。
次に、117つ目のキャッシュサーバーを追加します。追加する117つ目のキャッシュサーバーはXNUMXです。XNUMXをクリックして「add」を選択します。追加は完了しましたが、停止しています。ここでクリックして「start」を選択します。これでサーバーノードが起動します。
ここから始めると、2つ目のノードがあちこちに追加されるのが分かります。そして、キャッシュ数が減っているのが分かります。キャッシュ数が実際には2倍だったことはお見せしませんでしたが、サーバーが2台になったことでキャッシュ数が減り、1秒あたりのトランザクションリクエスト数が半分になりました。リクエストの半分がこのキャッシュサーバーで処理されているからです。つまり、リクエスト数がこのように減っているのです。
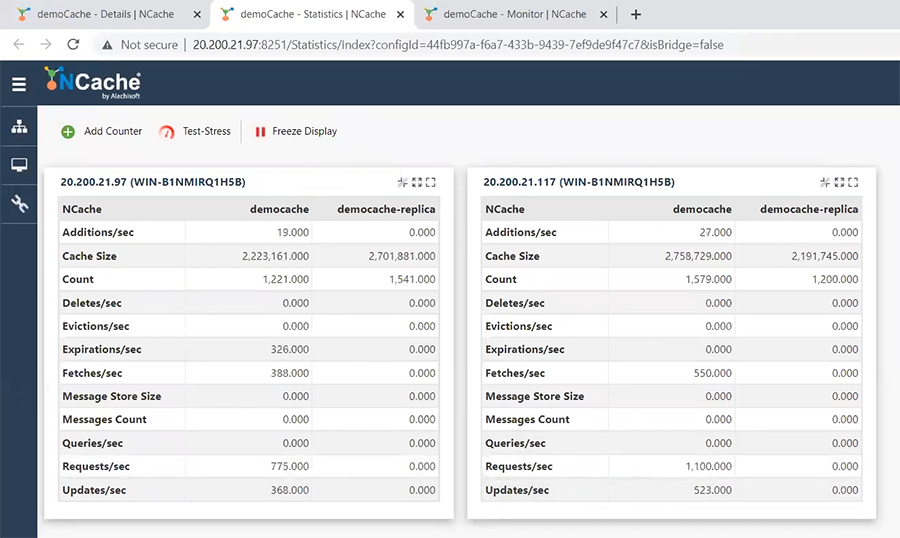
これで、アプリケーションを停止せずにキャッシュサーバーを追加できました。ストレステストツールがここで実行されているのがわかります。こちらでも実行されています。全く問題ありません。そして、パーティションが1500台のサーバーからXNUMX台のサーバークラスターに変わりました。パーティションXNUMXとパーティションXNUMXがあり、それぞれのパーティションが別のサーバーにバックアップされています。これが何なのかお見せしましょう。こちらがパーティションXNUMXです。この数のアイテムがあり、そのレプリカがここにあります。これは、こちらとほぼ同じ量です。そしてこちらがパーティションXNUMXです。約XNUMX件で、こちらにバックアップされています。
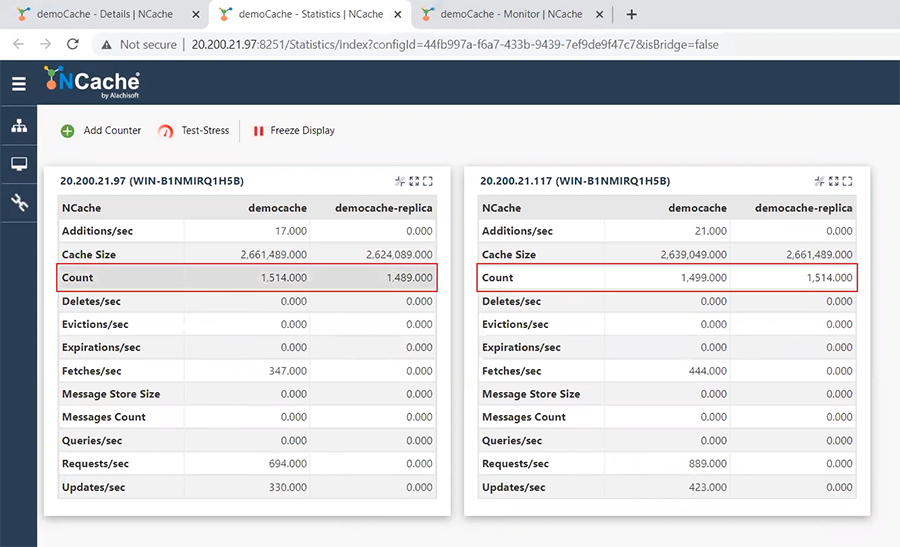
このレプリケーションは非同期です。そのため、このカウントは常に正確であるとは限りません。ただし、トランザクションを停止した場合でも、最終的には正確になります。
わかりました。さて、トランザクション負荷が増加し続けているとしましょう。ビジネスは順調に進んでおり、トランザクション容量を増やすためにサーバーを追加する必要があります。また、今後クライアントも追加していく予定です。
まず、クライアントを増やす予定です。まずクライアント、つまりアプリケーションサーバーを増やすからです。その結果、トランザクション負荷が高くなります。ご覧の通り、トランザクション負荷が増加しています。サーバーあたり1182件程度だったのが800件になり、実際はさらに減少して1200件程度になっています。
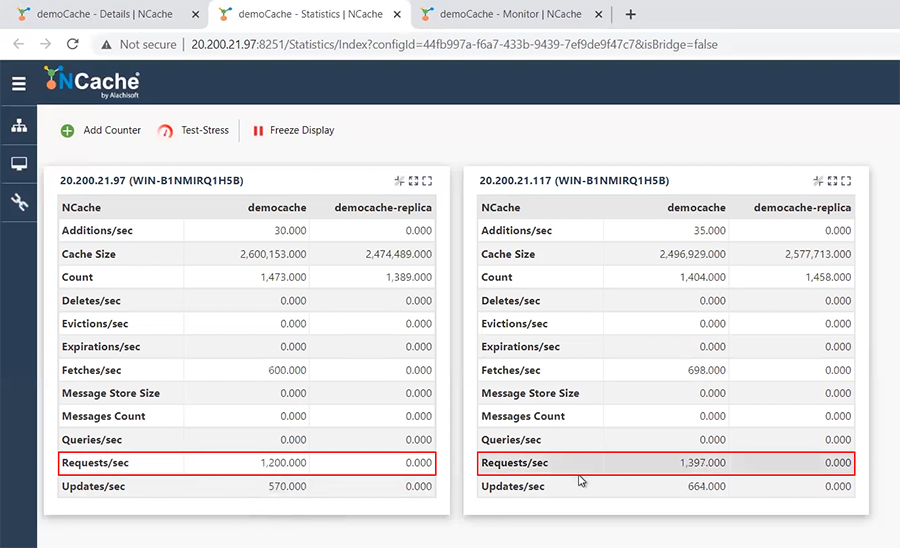
トランザクション負荷は上昇し続けています。ここでも確認できます。各サーバーの1秒あたりのリクエスト数は分散されており、サーバーを追加したことにより増加しています。
さて、クライアントを追加したので、ある時点で、トランザクション容量が限界に達しているか、あるいは各サーバーのメモリ容量が限界に達しているため、キャッシュサーバーの速度が低下し始めていることに気づくでしょう。そのため、さらにサーバーを追加する必要があります。
いずれにせよ、先ほど申し上げたように、最低2台のサーバーを推奨します。したがって、少なくとも本番環境では1台のサーバーだけでクラスターを構成しないでください。高可用性が得られないからです。最低2台のサーバーでキャパシティの上限に達した場合は、3台目のサーバーを追加するタイミングです。
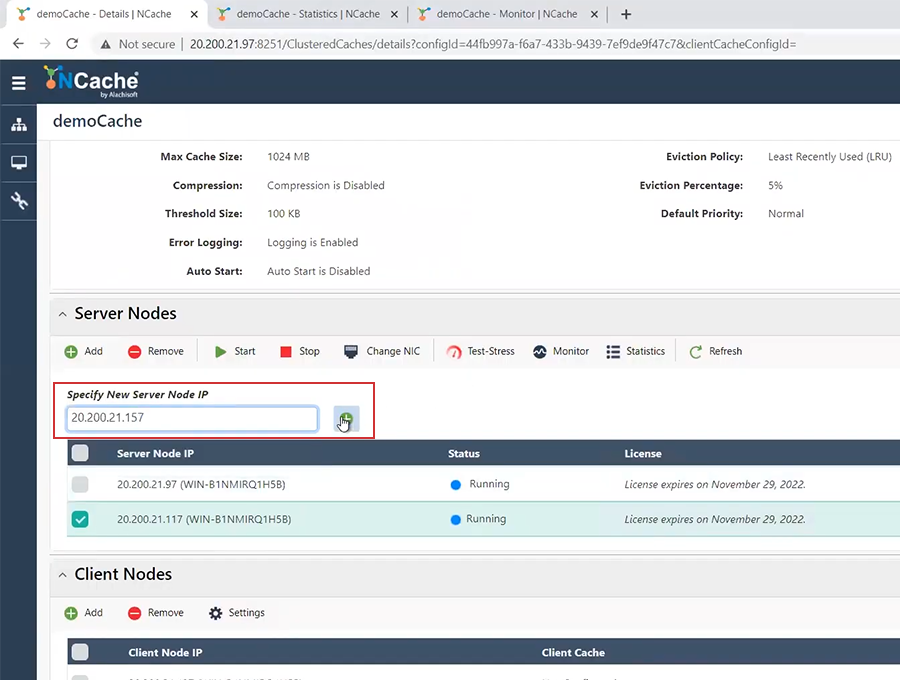
157台目のサーバーを追加するにはどうすればいいでしょうか? 157台目のサーバーはここに157番があります。すぐにここに来て、「サーバーを追加」と選択すると、XNUMX番です。ここに来てXNUMX番を追加します。追加は完了しましたが、停止してしまいました。ここに来て、これを選択して「開始」をクリックします。
気づいたら、この1800はダウンしそうです。1100台目のサーバーが起動したらすぐに負荷分散が始まります。ほら、それぞれXNUMXくらいまで減りました。
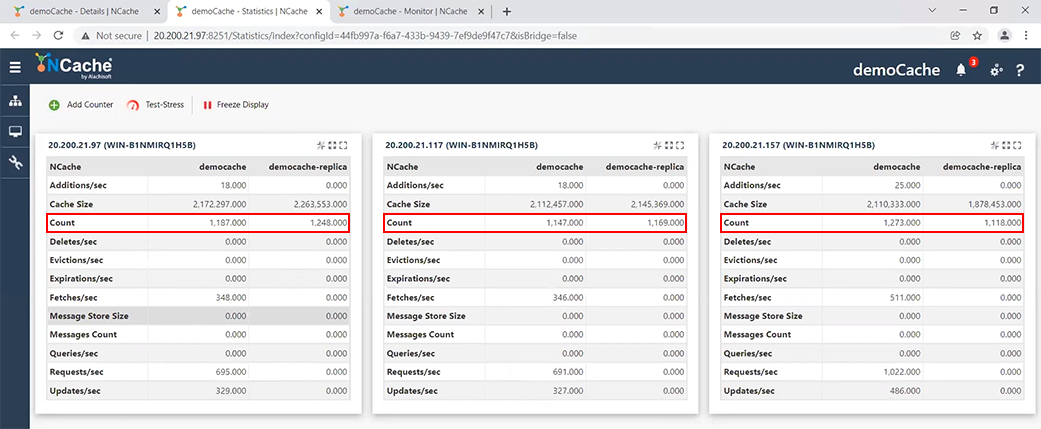
なぜなら、サーバーが2台ではなく3台になったからです。ここで示したように、サーバーが3台あるとパーティションも3つになります。つまり、これらのパーティションのデータは、さらに3つのパーティションに分割されます。
これで、各パーティションは異なるサーバーにレプリカを持ち、実際にデータが分散されます。つまり、アプリケーションもキャッシュも停止させることなくサーバーを追加できることをお見せしました。つまり、サーバーを追加しても、アプリケーションはまったく影響を受けません。これがこの変更の素晴らしい点です。 NCache それが可能になるということです。
さて、そろそろサーバーを停止する必要があるかもしれません。サーバーを停止する方法は2つあります。1つは、キャパシティを削減するためにサーバーを恒久的に停止する方法です。季節的なビジネスなので、サーバーを3台から2台に減らすとします。ホリデーシーズンにはピーク時の利用があり、今はデフォルトの、つまり小規模な構成に戻すことになります。つまり、一部のサーバーは実際に削除することになります。では、実際に削除してみましょう。
この中のサーバー157を削除します。サーバー157を選択して「stop」を実行します。まずはstopを実行します。ご覧の通り、停止するとこのカウントが減り、さらに増加します。それぞれ約2000まで戻っていますね。つまり、データがここからこちらに移動したということです。
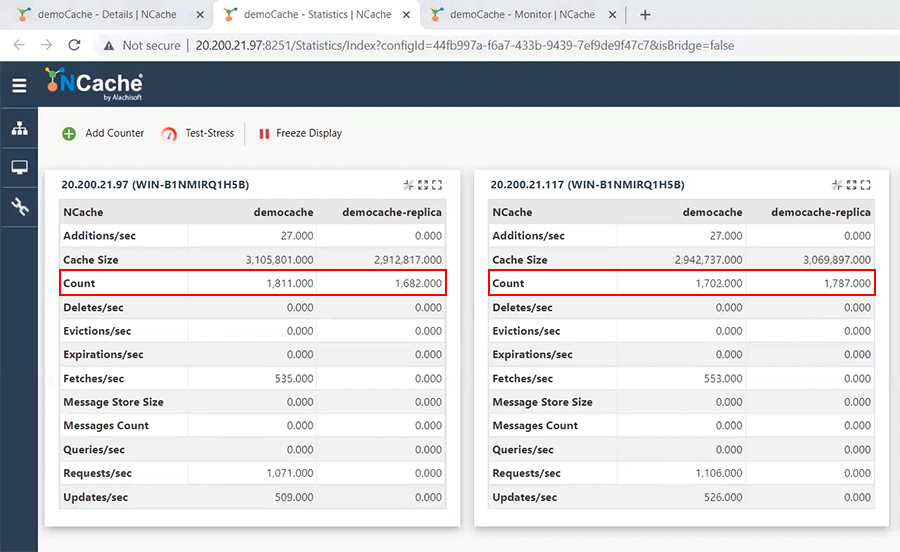
基本的に、3つのパーティション構成から2つのパーティション構成に変更しました。各パーティションは複製されています。ご覧のとおり、このパーティションはここに複製され、このパーティションもここに複製されています。アプリケーションへの影響はご覧のとおりありません。
つまり、容量を増やすためにサーバーを追加する必要がある、あるいは容量ニーズの変化のためにサーバーを停止する必要がある、といった状況にほぼ対応できるということです。実際、季節的な使用状況の変化によって容量ニーズが変化したのです。
メンテナンスモード
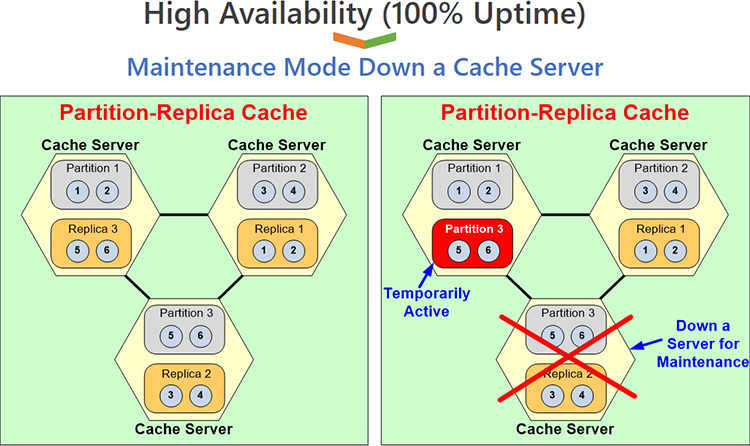
メンテナンスモードと呼ばれる別の状況があります。これは、サーバーを停止する必要があるものの、キャパシティが低下したからではなく、メンテナンスを行う必要がある場合です。例えば、オペレーティングシステムのパッチなどを適用する必要がある場合、サーバーを5分、10分、あるいは30分程度停止する必要があります。しかし、キャッシュには膨大な量のデータがあります。私たちのお客様は、各サーバーに数十ギガバイトのデータを持っています。つまり、3台、4台、5台、あるいは6台のサーバーからなるクラスターで、各サーバーに合計数十ギガバイトのデータがある場合、サーバーを停止するとパフォーマンスに影響が出ます。なぜなら、パーティションを3つから2つに再分割する必要があるとしたら、大量の状態転送が発生し、その後、何のためにそれを元に戻す必要があるのでしょうか?そこで、メンテナンスモードという機能を開発しました。 NCache わかりました。このサーバーを停止しますが、キャッシュのパーティション分割は不要です。3つのパーティションノード、つまりパーティション1、パーティション2、そしてここにあるレプリカ3がパーティション3になります。これはアクティブなままです。これは一時的な設定です。作業が完了したら、このノードを再起動すると、この状態に戻ります。
では、その方法をお見せしましょう。まず、3台のサーバー構成を再び実現します。これを追加します。これは削除したと仮定して、今追加しています。削除するべきでした。停止しただけです。しかし、追加します。これで再び3ノードのクラスターになりました。データは均等に分散されています。
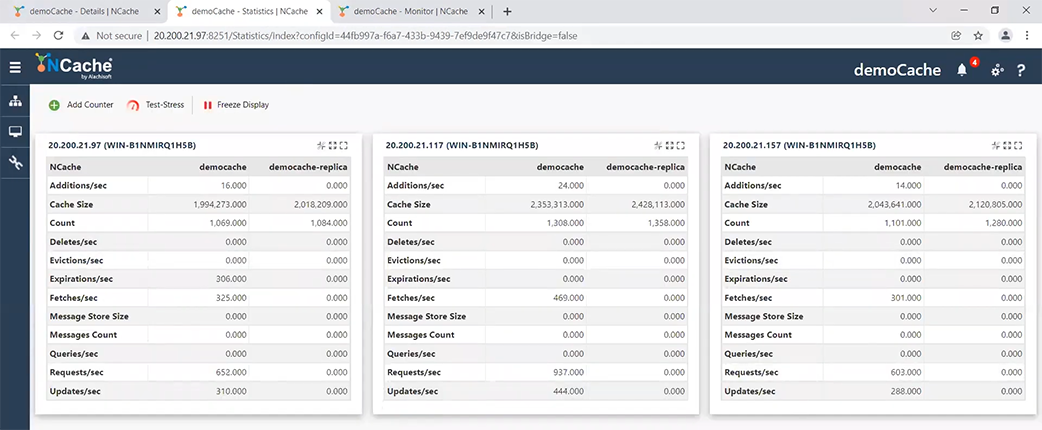
トランザクション負荷が均等に分散されており、ここでも確認できます。実は、まだ表示されていませんが、いずれ表示されます。とにかく、これができたら、メンテナンスを行う必要があります。ここでもう一度確認しますが、各ノードには約1200個のアイテムがあります。
したがって、これを 2000 ノード クラスターに縮小すると、各ノードのアイテムが XNUMX 個以上になるはずですが、ここに来て、メンテナンスのためにこれを停止するように指示するため、実際にはそうはなりません。
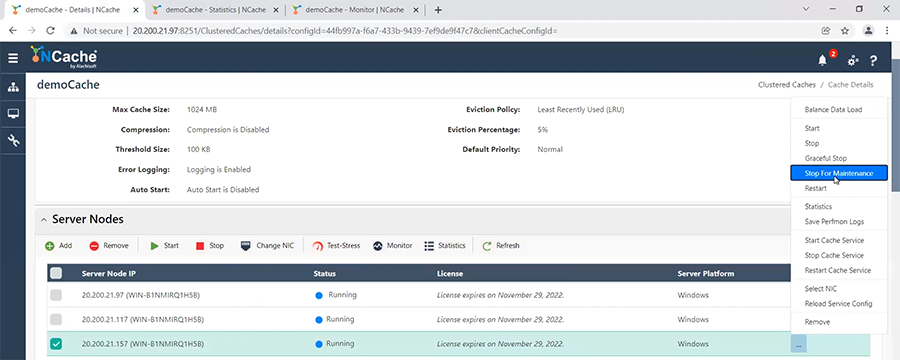
これをクリックすると、メンテナンスモードをどのくらいの期間維持しますか?という質問が表示されます。このタイムアウトは非常に重要です。タイムアウトの終了時に NCache もうメンテナンスは終了したとみなされます。なぜなら、この時間までにノードを戻さなければ、 NCache 先ほど示した他の削除と同様に、実際に完全に削除され、キャッシュが削除されて再パーティション化されたものと想定します。
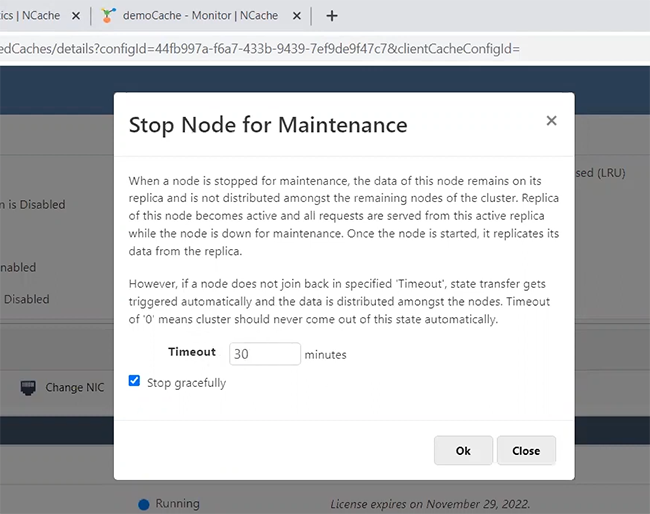
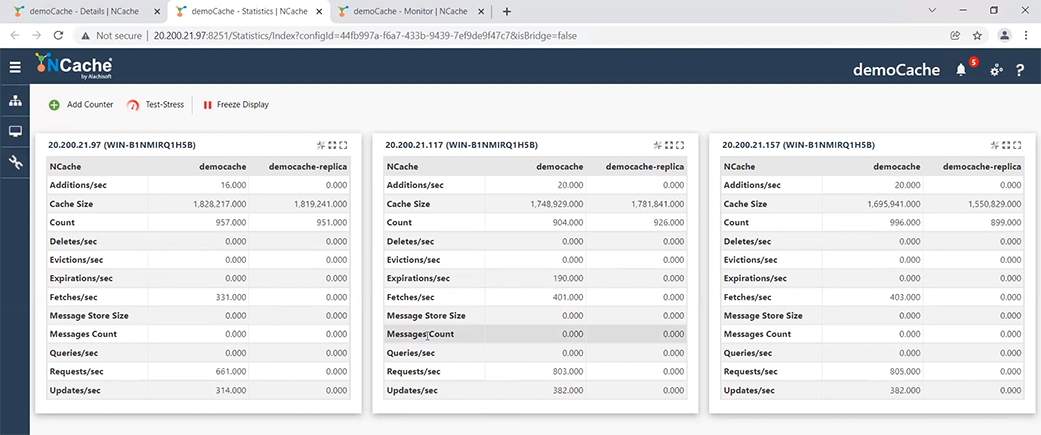
しかし、この期間内に追加し、設定可能な期間であれば、この期間内に追加すれば NCache 今お見せしたように、パーティションの再分割は行われず、そのパーティション、レプリカが一時的なパーティション モードのままになります。つまり、ここで停止するということです。では、1300、1300、1470 に進みましょう。これで完全に消えています。ただし、このカウントが増加していないことに注目してください。なぜでしょう? レプリカの XNUMX つがアクティブ パーティションになったためです。この図ではどれかはわかりませんが、カウントが増加していないということは、レプリカがまだ存在しているということです。このレプリカはアクティブ パーティションになりました。つまり、サーバー XNUMX にはパーティション XNUMX とパーティション XNUMX があり、サーバー XNUMX にはパーティション XNUMX とパッシブ レプリカ XNUMX があります。サーバー XNUMX はダウンしているので、メンテナンスのためにダウンさせる必要があります。
では、メンテナンスを行いましょう。パッチを適用すれば完了です。再起動したい場合は、ここに戻って、再度追加する必要はありません。停止しているので、「再起動」を選択するだけです。ちなみに、その間もアプリケーションは中断することなく動作していました。つまり、これらの変更はアプリケーションの中断を必要としません。「再起動」を選択します。「再起動」を選択したら、今度は元の状態に戻り、データに追いつきます。そして、以前と同じレベルに戻っていることがわかります。
結論
ご覧のとおり、実行時にノードを恒久的に追加・削除する方法と、定期メンテナンスのために一時的にノードを削除する方法の両方をデモしました。これでデモは終了です。デモでは、 NCache 高可用性を実現します。100%の稼働率を実現し、アプリケーションを停止する必要がありません。アプリケーションの中断もありません。