NCache スプリット ブレイン回復アーキテクチャ
NCache スプリットブレインの検出と回復と呼ばれる重要な高可用性アーキテクチャ機能を提供します。 このビデオを見てこの機能について学び、次に NCache スプリットブレインリカバリー。
今日は、 NCache スプリットブレイン回復アーキテクチャとそのデモを紹介します。
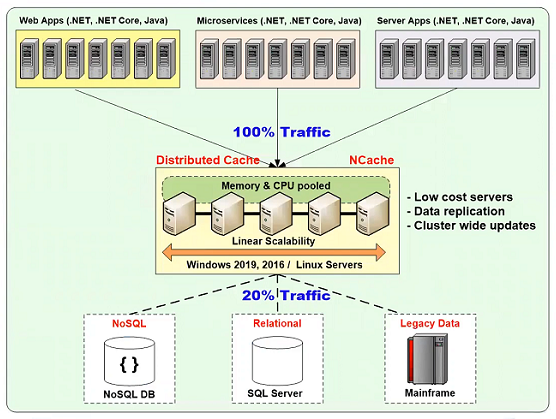
NCache .NETおよび.NET Coreアプリケーション向けのインメモリ分散キャッシュです。JavaおよびNode.jsアプリケーションもサポートしています。 NCache 複数のアプリケーションサーバー上で実行される、トランザクション数の多いアプリケーションで使用されます。これらのサーバーには、Webアプリケーション、マイクロサービスアプリケーション、その他のサーバーアプリケーションが含まれます。そして、 NCache アプリケーション層とデータベース(SQL ServerやOracleのようなリレーショナルデータベース、CosmosDBやMongoDBのようなNoSQLデータベース、あるいは従来のメインフレームデータベースやデータなど)の間に位置します。そして、 NCache 通常、クラスタには2つ以上のキャッシュサーバがあり、このミッションクリティカルなアプリケーション環境では NCache 高可用性を提供します。その高可用性の一部として、スプリット ブレイン検出とスプリット ブレイン回復と呼ばれる非常に重要な機能があります。これについてこれから説明します。
動的キャッシュクラスターアーキテクチャ
ピアツーピアアーキテクチャ(自己修復)
- 単一障害点なし(マスター/スレーブなし)
- クラスターコーディネーター 最も古いノード、次に古いノードは自動後継ノード
スプリットブレインについて話す前に、簡単に概要を説明しましょう。 NCache 動的キャッシュ クラスタリング アーキテクチャ。
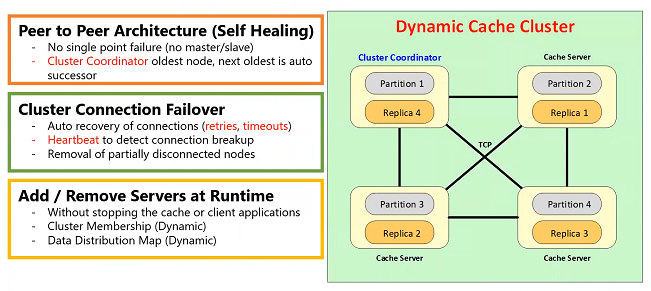
これはTCPベースのアーキテクチャで、すべてのサーバーがTCPソケットを介して他のすべてのサーバーに接続されます。これは自己修復機能を持つピアツーピアアーキテクチャです。自己修復とは、あらゆる変更に自動的に適応することを意味します。また、ピアツーピアアーキテクチャであるため、単一障害点はありません。つまり、マスターもスレーブもありません。通常、クラスター内で最も古いノードであるクラスターコーディネーターノードがあります。しかし、そのノードがダウンした場合は、次に古いノードが自動的に後継ノードになります。クラスターコーディネーターはクラスターの管理を担い、クラスターのメンバーシップを管理します。パーティションまたはパーティションレプリカトポロジの場合は、データ分散マップを管理します。さらに、クラスターの健全性も管理します。
クラスタ接続フェイルオーバー
- 接続の自動回復(再試行, タイムアウト)
- 心拍 接続の切断を検出する
- 部分的に切断されたノードの削除
先ほど申し上げたように、このクラスター内のすべてのノードは他のすべてのノードに接続されており、その接続状況を追跡しています。万が一接続が切断された場合、クラスター内には接続フェイルオーバー機能が備わっています。この機能により、ノードは自動的に再試行を行います。再試行回数は複数回に設定可能で、各再試行にはタイムアウトがあります。また、ハートビート機能も備わっており、設定可能な間隔でハートビートを送信することで、ソケット接続が確立されていることを確認します。こうした機能が備わっているのは、ほとんどの場合、接続切断を自動的に復旧するにはこれだけで十分だからです。その理由は、キャッシュサーバーは通常、同じデータセンター、つまり同じサブネット内に配置されているためです。そのため、これらのキャッシュサーバー間の接続は通常非常に信頼性が高いです。スプリットブレインはあまり頻繁に発生しませんが、時々発生することがあります。その場合の対処方法についてお話しします。
実行時にサーバーを追加/削除する
- キャッシュやクライアントアプリケーションを停止することなく
- クラスターメンバーシップ(動的)
- データ分布マップ(動的)
いずれにせよ、このアーキテクチャでは、キャッシュやアプリケーションを停止することなく、実行時にキャッシュサーバーを追加または削除できます。また、キャッシュサーバーをクラスタに追加すると、クラスタコーディネーターがクラスタメンバーシップマップを更新し、それをすべてのキャッシュサーバーに動的に伝播します。そして、キャッシュサーバーはすべてのクライアントに動的に伝播します。同様に、パーティションまたはパーティションレプリカトポロジの場合は、データ分散マップも更新され、 NCache 詳細については、アーキテクチャビデオをご覧ください。パーティションまたはパーティションレプリカトポロジには1000個のバケットがあり、これが分散マップとなります。このマップは基本的に、各サーバーがどのバケットを持っているかをサーバーに伝え、クライアントに送信することで、クライアントはデータの場所を把握できます。つまり、これが動的キャッシュクラスターです。
動的クライアント接続
実行時にクライアントを追加/削除する
- 止まることなく キャッシュまたはクライアントアプリケーション
2 番目の側面は、動的クライアント接続です。つまり、クラスター内の接続が動的であるのと同様に、クライアントとクラスター間の接続も動的です。
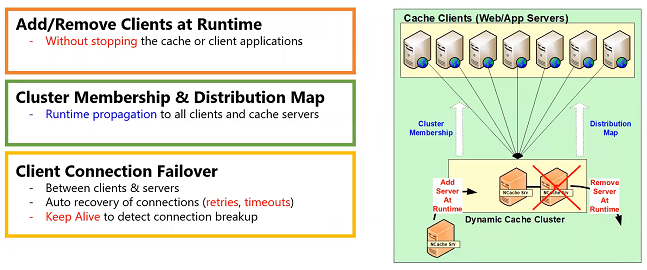
クライアント接続フェイルオーバー
- クライアントとサーバー間
- 接続の自動回復(再試行, タイムアウト)
- 生き続ける 接続の切断を検出する
これは非常に軽量なTCPベースの接続です。万が一接続が切断された場合でも、再試行とタイムアウトを備えた接続フェイルオーバー機能が働きます。また、クライアントがクラスターにハートビートのようなメッセージを送信し続けることで接続を維持するキープアライブ機能も備えています。実際には、クライアントとクラスター間の接続切断の可能性は、クラスター内よりも高くなります。これは、クライアントが別のサブネット、あるいはファイアウォール越しに配置されている可能性があるためです。つまり、こうした状況は一般的にソケット切断の可能性を高めます。そのような状況が発生した場合でも、クライアントは再接続できます。つまり、接続フェイルオーバー機能が働くのです。このアーキテクチャ全体を通して、キャッシュやアプリケーションを停止することなく、実行時にクライアントを追加または削除できます。
クラスターメンバーシップと分布マップ
- 実行時の伝播 すべてのクライアントとキャッシュサーバーへ
クライアントが追加されるたびに、クライアントはクラスタからクラスタメンバーシップ情報を取得し、さらにパーティションまたはパーティションレプリカトポロジの場合は、ここで示したデータ分散マップもクラスタから取得します。これにより、クライアントはクラスタ内のサーバーの正確な数と、それらがどのサーバーであるかを自動的に把握できます。つまり、パーティションまたはパーティションレプリカトポロジでサーバーに接続し、データ分散マップの内容を把握できるのです。
スプリットブレイン検出
各ノードが接続の切断を検出
- 可能な限りあらゆるノードとの接続を維持する
- 他の人がダウンしていると想定する
こうしたアーキテクチャ全体を考慮すると、TCP接続には再試行やタイムアウトによる復元力が組み込まれているにもかかわらず、何らかの理由でキャッシュサーバー間の接続が実際に切断される状況が依然として存在します。ハードウェアの問題、ネットワークドライバーの問題、その他様々な理由が考えられます。このような状況が発生した場合、私たちはこれを「接続の切断」と呼びます。
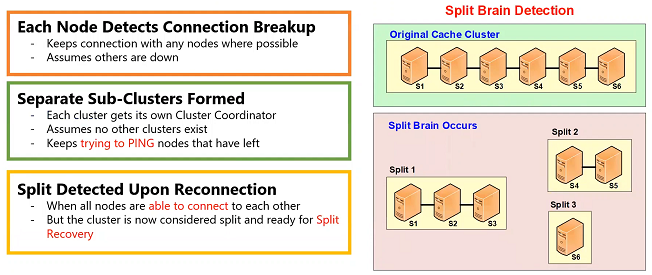
独立したサブクラスターの形成
- 各クラスターには独自のクラスターコーディネーターが割り当てられます
- 他のクラスターは存在しないと仮定
- キープ PINGを試みている 離脱したノード
キャッシュクラスタリングアーキテクチャでは、クラスター内のすべてのノードが接続の切断、つまり再試行にもかかわらず接続が切断されたかどうかを常に検出します。接続が切断されると、各ノードは他のノードがダウンしたと想定し、他のすべてのノードと通信を続けます。例えば、ここにサーバーがあり、このノードはこれら3つのサーバーすべてと通信しているとします。このノードがダウンすると、このノードはこれら3つのサーバーと通信できる可能性があります。その場合、このノードはこれら3つのサーバーが3つのクラスターを形成し、このノードはクラスターから離脱したと想定します。例えば、6つのノードで構成されるクラスターでこのような状況が発生すると、接続が切断され、3つのサーバーは互いに通信でき、2つのサーバーは互いに通信できますが、このノードは誰とも通信できなくなります。
つまり、それが起こると、これらのノードはそれをすべて検出し、これら 1 つのノードと通信できるので、自分は 4 つのクラスターであると想定します。そして、3 つのノードからなるクラスターになると、ノードの 6 つがクラスター コーディネーターになります。そのノードは、おそらく最も古い sXNUMX であり、ここで引き続きクラスター コーディネーターであるため、既にクラスター コーディネーターになっている可能性があります。ただし、スプリット XNUMX の場合は、sXNUMX がこのクラスターの新しいクラスター コーディネーターになります。また、スプリット XNUMX では、唯一のノードである sXNUMX がコーディネーターになります。この状況では、これらのノードは、これら XNUMX つのノードがこれら XNUMX つのノードと通信できることを認識しています。つまり、自分は大丈夫、他のノードは死んでいる、と認識します。こちらも同じことを考えます。自分は大丈夫、他のノードは死んでいる、と認識します。こちらも自分は大丈夫、他のノードは死んでいる、と認識します。
しかし、彼らは私が6ノードのクラスターであるはずだということも知っています。そのため、他のすべてのノードにpingを送信し続け、復旧するかどうかを確認します。pingは設定可能な間隔で行われ、その後、彼らは諦めて、これらのノードは完全にダウンし、残っているのは私だけであると想定します。しかし、その間隔内に、例えばネットワーク接続が回復し、これらのノードが互いに見えるようになるとします。つまり、この例では、すべてのノードが互いを認識できるということです。これで、彼らは3つの別々のスプリットを作成しながらも、互いに通信できることに気付くのです。
再接続時に分割が検出されました
- すべてのノードが 接続できる お互いに
- しかし、クラスターは分割され、 分割回復
そう、 NCache 正式に分裂を検出します。たとえ接続が切れた瞬間に分裂が起こったとしても、 NCache ノードは、すべてのノードがダウンしたと思っていたため、これが分割であることに気づきませんでした。しかし、指定された間隔内にノードが復帰した場合、キャッシュノードは「分割が発生したので、分割リカバリを実行するタイミングです」と認識します。分割リカバリを実行する理由は、アプリケーションが動作を継続するためには健全なキャッシュクラスタが必要だからです。分割は健全な状況ではありませんが、自動的にリカバリできれば、管理スタッフが昼夜や週末の不規則な時間に介入する必要がなくなります。そうすれば、作業が楽になります。 NCache 自動的に健全な状態、つまり6つの健全なクラスターに戻ります。しかし、それはどのように起こるのでしょうか?
まず、先ほども言ったように、接続が回復し、お互いを認識できるようになった時にのみ、分岐が検出されます。それまでは、他のノードがダウンしていると想定されます。わかりましたか?分岐が検出されると、分岐回復機能が作動します。
スプリットブレインリカバリー
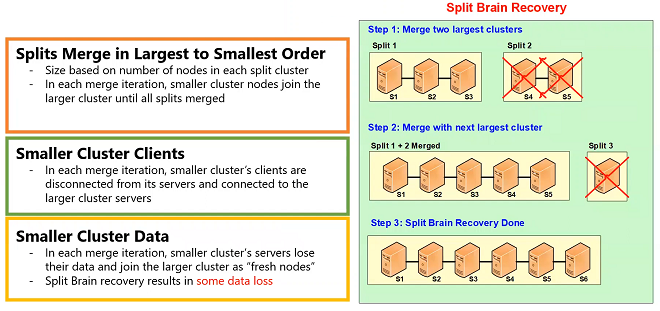
分割して最大から最小の順序で結合する
- 各分割クラスタ内のノード数に基づくサイズ
- 各マージ反復では、すべての分割がマージされるまで、小さなクラスターノードが大きなクラスターに参加します。
スプリットリカバリでは、まず2つの最大のサブクラスタ、つまり2つの最大の分割がマージされます。そして、この分割のクラスタとこの分割のクラスタは、2つのうち小さい方のクラスタなので、互いに調整し合います。ここでのサイズは、各クラスタのノード数に基づいています。データ量、アクティビティ量、クライアント数に基づいて決定することもできましたが、最も可能性の高い状況であったため、ノード数を選択しました。多くの場合、ハッシュマップの分散、均等に分散された1000個のバケット、そしてデータバランシング機能によって、各ノードはほぼ同じ量のデータを持つからです。 NCache バランスが崩れた場合に、ノード間でデータのバランスを再調整します。
より小さなクラスターデータ
- 各マージ反復で、小さなクラスターのサーバーはデータを失い、大きなクラスターに「新しいノード」として参加します。
- スプリットブレイン回復の結果 一部のデータ損失
つまり、最も可能性の高い状況は、すべてのノードがほぼ同じ量のデータを持っているということです。つまり、ノード数が最も多いということは、データ量も最大であるということです。これがマスターになります。そして、このもう一方のスプリットノードは、データを解放し、このクラスターに新しいノードとして再参加する必要があります。まず最初に、クライアントを解放するように指示します。つまり、この2つのサーバー、つまりコーディネーターは、もう一方のノードに、クライアントを解放してこのクラスターに接続するようにクライアントに指示します。すると、まずクライアントが新しいクラスターに移動します。これは正常なマスタークラスターだからです。クライアントがここに移動すると、このクラスターはデータを解放し、基本的に再起動します。ただし、実際には再起動はせず、単にデータを解放して、正常なノードとしてこのクラスターに再参加します。
その結果、分割1と分割2を統合した5ノードのクラスターが作成されます。この処理が完了すると、次に大きい分割ノードに移動し、このクラスターと統合します。今回のケースでは分割は3つしかありませんでしたが、3つ以上でも構いません。アルゴリズムは、最大の分割ノードから始めて、次に大きい分割ノード、さらにその次に大きい分割ノードと統合していくというものです。必要な回数だけ繰り返し処理を実行しますが、どの時点でも統合されるのは2つの分割ノードだけです。つまり、これら2つの分割ノードが統合されている間、3つ目の分割ノードは独立して処理を実行し続けるため、分割ノードが統合されるまで処理が続行され、この統合が実行されます。
そして、この後に4つ目の分割もマージされるとします。このプロセスでは、データを失ったり放棄したりしたノードの数に応じて、データが失われることに注意してください。例えば、このケースでは3つのノードがマスターになり、他の3つのノードはデータを失います。パーティションレプリカトポロジーであっても、パーティションごとにレプリカは1つしかありません。つまり、データが失われますが、これは状況の一部に過ぎません。しかし、もう一つの現実は、データキャッシュの場合、このデータは既にデータベースに存在しているということです。つまり、データが失われるわけではなく、データベースからリロードするだけで済みます。アプリケーションの操作のヒットとミスに基づいてリロードすることもできますし、リードスルーに基づいてリロードすることもできますし、キャッシュリフレッシャー機能に基づいてリロードすることもできます。 NCache ただし、どちらの場合もデータは失われません。
しかし、データがセッション状態やその他の一時的なデータで、永続的なストレージに存在しない場合、そのデータは失われます。そのため、その場合はセッションを再作成する必要があります。しかし、それでもデータ損失は依然として好ましい状況です。なぜなら、結局のところ、ネットワーク障害が発生したからです。つまり、ネットワーク障害には影響があります。
次のバージョンでは NCacheキャッシュを永続化できる機能を提供します。永続キャッシュとは、キャッシュに保存されたものはすべて、独自のキャッシュに保存されることを意味します。 NCache独自の永続ストアとスプリットブレインリカバリーで、一時データさえも失われません。 NCache 永続ストアにコピーを保存するというものです。ただし、この機能が公開された時点で詳しく説明します。今回はこの点についてのみお話しします。
実践的なデモ
このアーキテクチャについて説明できたと思います。では、実際にどのように実現できるかのデモをお見せします。 NCacheたとえば、5 つのキャッシュ サーバーがあり、これとこのリストの間に分割を作成するとします。
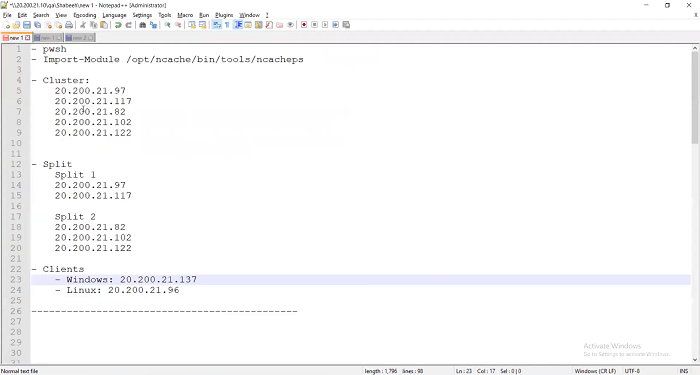
2つのスプリットを作成します。スプリット1には2つのキャッシュサーバー、スプリット2には2つのキャッシュサーバーを配置します。そして、今現在使用しているWindowsクライアントを1台用意し、管理と監視に使用します。また、このクライアントには2つのシェルフが開いているLinuxクライアントも用意しています。つまり、そこから2つのクライアントアプリケーションを起動できます。これで、このクラスターが現在稼働しています。このクラスターの追加方法については、他の動画で説明しているので、ここでは説明しません。ここでは、スプリットブレインの部分だけを説明します。
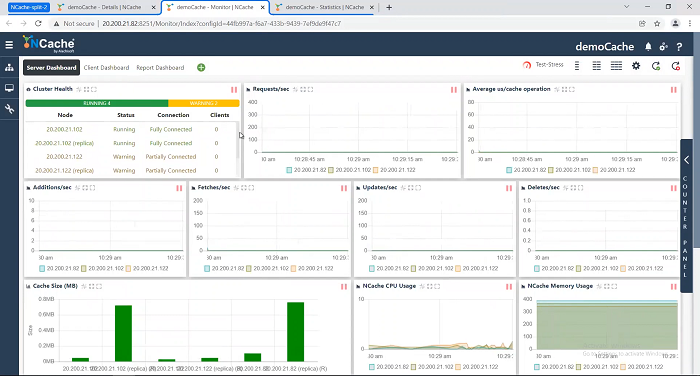
クラスターの健全性と統計を監視する
ここに5ノードのクラスタがあります。5ノードのクラスタです。ここに5ノードのクラスタがあり、稼働しています。それでは統計情報とモニターを開いてみます。2つの異なるクラスタを開きました。 NCache マネージャウィンドウです。97つはここにある.82に接続されており、もう97つはここにある.82に接続されています。こちらは.XNUMXで、これは実際のマネージャです。モニターと統計情報があります。XNUMXつ目は.XNUMXで、これも同じように表示します。同じクラスターですが、管理のために別のサーバーと通信しているだけです。ここにあるサーバーと比較するために、このサーバーと通信しています。ここでも統計情報を表示します。アクティビティを確認できます。現在、クライアントがまだ実行されていないため、アクティビティはありません。モニターも開きます。
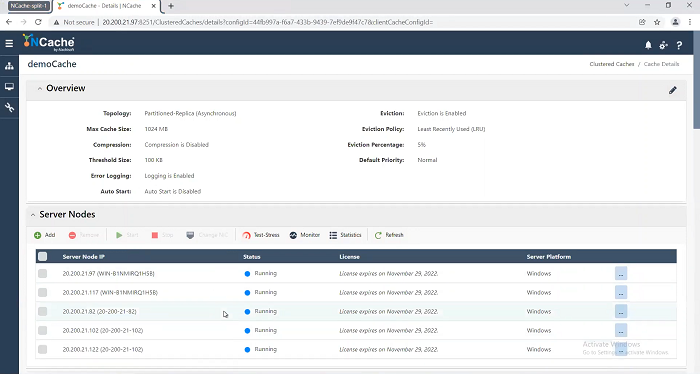
では、なぜ2つ開いたのでしょうか?それは、監視したいからです。このノードとこのノードに接続したいのです。分割した際に、このノードだけに接続していると、残りのサーバーが2台しかないと表示され、この2台は見えなくなってしまいます。そこで、両方の視点から確認したいのです。分割はファイアウォールルールを通して行うのですが、もちろん、今回の場合はファイアウォールルールは適用されません。何らかのネットワーク障害が発生するでしょう。そこで、ファイアウォールルールを通して、その状態を再現、あるいはシミュレートするのです。これで、管理と監視のためにこのノードと、管理と監視のためにこのノードに接続できました。さて、ここに来て…ああ、まだです。
このコマンド ラインを使用して Get-Caches-Server を呼び出し、ここで .82 と通信します。
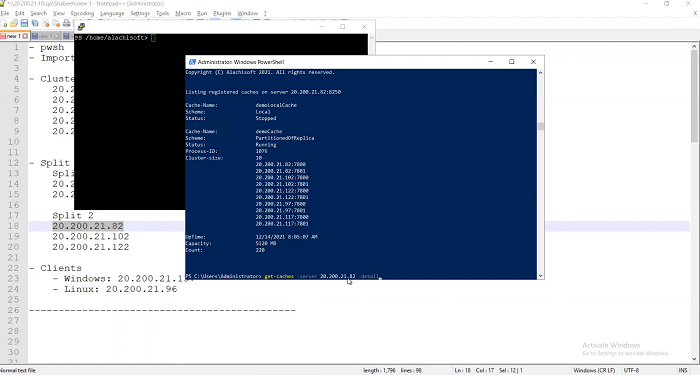
82に話しかけて、あなたが持っているすべてのキャッシュの詳細を教えてほしいと伝えます。つまり、82は「democache」というキャッシュがあり、その中に82台のサーバー(102、122、97、117、XNUMX)があると言っています。XNUMX台のサーバーからなるクラスターですが、これは現時点では分割されていないためです。
他のサーバー、97 に行きます。
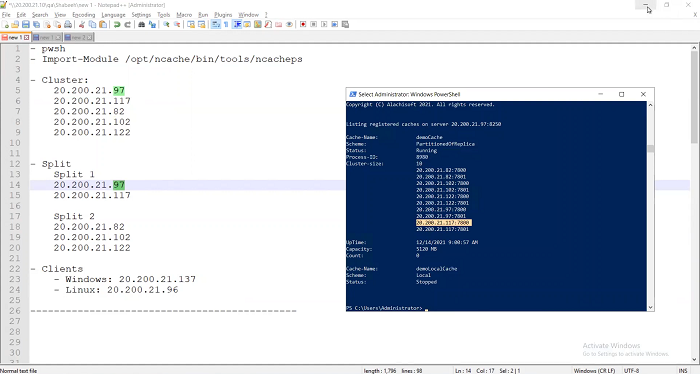
同じ質問をします。サーバーを教えてくださいと伝えました。すべてOKと返ってきました。現在、82台のサーバーキャッシュがあります。102、122、97、117、XNUMXです。つまり、XNUMX台のサーバークラスターで、Splitは使用しておらず、すべて正常です。
Test-Stress PowerShell コマンドレットを使用してストレスをシミュレートする
すべて順調です。それではアプリケーションを起動します。PowerShellウィンドウが表示されています。実は、これはLinuxマシンです。ここで何が起こったのかお見せしましょう。さあ!もう一度PowerShellを開きます。申し訳ありません。このモジュールをインポートします。 NCache 管理モジュールです。これはLinuxでのみ必要です。Windowsではインポートする必要はありません。次にTest-Stress democacheと入力します。さて、これでこのツールを実行できました。ここでも同じことをします。
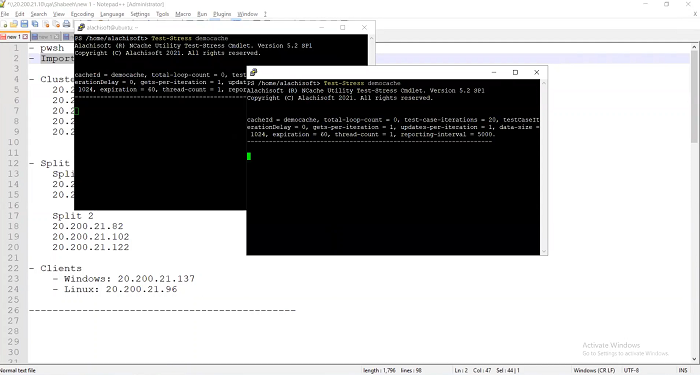
Test-Stress democache とします。両方とも取得しました。さて、ご覧ください。アクティビティが発生しています。97つのノードすべてでアクティビティが発生しています。97、XNUMX、XNUMX、XNUMX、XNUMX と表示されています。XNUMXつのノードすべてでアクティビティが発生しています。ここにもそれが表示されています。こちらにも表示されています。XNUMXつのノードがあります。先ほどのXNUMX倍ですね。今はXNUMXです。
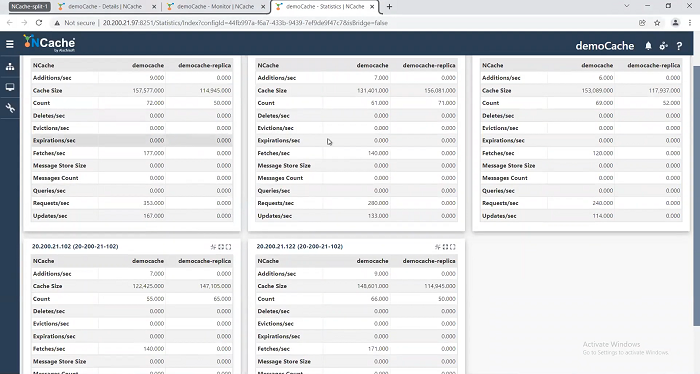
こちらでも同じ状況が見られるか確認してみましょう。.82 に移動すると、XNUMX つのノードでアクティビティが発生していることがわかります。統計ウィンドウにもアクティビティが表示されています。
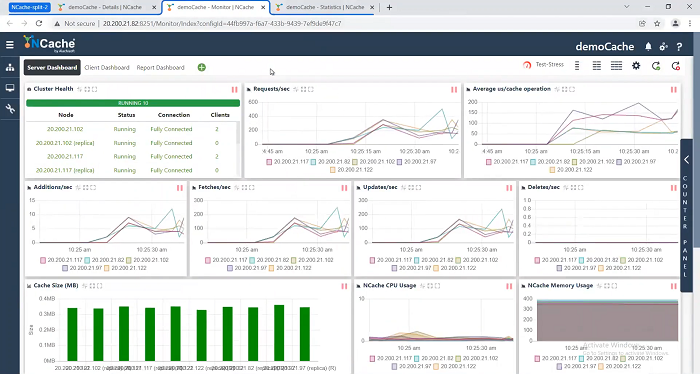
よし!これですべて正常に動作しています。通常、この画面とキャッシュマネージャーモニターを2つの異なるサーバーで開くことはありません。開いているのは、分割された状態を表示する必要があり、分割が発生した際に分割された両側で何が起こっているかを確認したいからです。
ネットワーク切断の誘発
よし!これですべてが実行されました。それでは導入を進めましょう。まず、この97つのボックスでファイアウォールルールを使用します。ここでファイアウォールを使用します。すでにXNUMXつのルールが設定されています。それではログインします。XNUMXにログインしています。ここにルールがあります。「受信ルール」に移動します。 NCache、私はただそれを呼んだ NCache スプリットブレイン。このルールは、78から7900までのポート(キャッシュ)への接続をブロックすることを意味します。
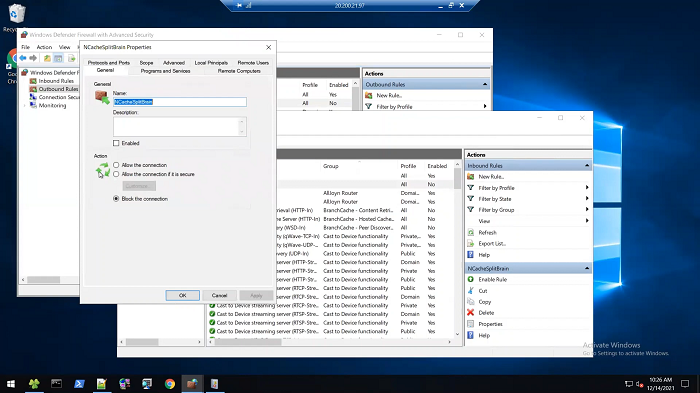
NCache キャッシュごとに個別のプロセスを起動します。そのため、キャッシュプロセスはデフォルトで7800~7900番ポートを使用します。ただし、これは設定可能です。そのため、異なるポートを使用している場合は、これをシミュレートするにはそれらのポートをブロックする必要があります。また、ポート8250は管理ポートです。
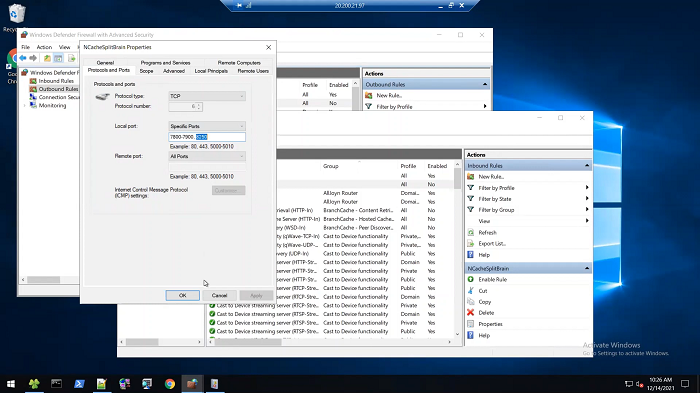
スコープは 82、102、122 をブロックするように言っています。つまり、これら XNUMX つのボックスがアクセスできないようにブロックするように言っているのです。基本的にはそういうことです。
では、このポートがあります。ルールを有効にすると、送信ルールにも同じポートがあります。これは...つまり、送信をブロックしています。次に、117 に移動して、それもブロックします。117 に移動します。ここにも、受信があります。ここでも同じです。接続、ポート、78、79、スコープ、この 3 つのボックスすべてをブロックします。わかりました。では、ルールを有効にすると、有効になります。もう 1 つに移動して、ここでルールを有効にするとします。
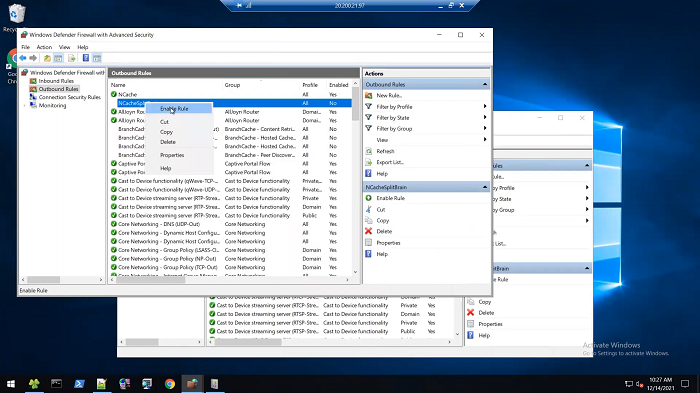
さて、私がやったことは、これらすべてに対してファイアウォールをオンにしたことです。
2つのサブクラスターの形成
さて、これで分割が始まります。すぐには起こりませんが、まず82番に「キャッシュにサーバーがいくつありますか?」と尋ねると、82、102、122、97、117という結果が出ます。つまり、まだ分割が行われていないので、XNUMX台すべてあります。再試行などの処理がまだ行われている最中です。もうXNUMXつのサーバーに「サーバーがいくつありますか?」と尋ねます。XNUMX台、XNUMX台、XNUMX台、XNUMX台、XNUMX台です。つまり、再試行とタイムアウトがまだ行われているので、まだ分割は行われていません。しかし、分割はすぐに起こります。
ここにきて、停止が始まっているかどうか確認します。ここでは97について話しています。97はXNUMXノードクラスタ側です。
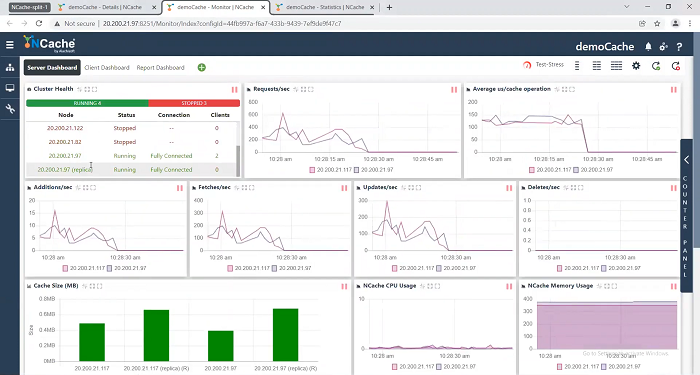
つまり、97 は、102、182、82 は見えていないと言っています。82 は停止していると言っていますが、97 と 117 は正常に動作しています。わかりました。反対側が何を表示しているか見てみましょう。分割された反対側、つまりこの反対側です。97 と話していましたが、今度は 82 と話します。ご覧のように、これが 82 です。ここに 82 があります。IP アドレス... わかりました。102、122 と言っています。つまり、122 は部分的に接続されており、82 は完全に接続されていると言っています。
まだ回復中です。122番ノードは他のノードと通信できないため、再試行フェーズが続いていますが、それでも通信は続行されます。この処理の流れを簡単にご説明します。
先ほどもお話ししたように、クラスターには部分的に接続されたノードがある場合、その部分的に接続されたノードをクラスターから削除して、健全なクラスターを作成する機能があります。つまり、今まさにそれが起こっているのです。つまり、部分的に接続されたノードである他のクラスター、つまり他のノードを削除しているのです。では、もう一度ここに戻って、コマンドラインに何が表示されているか見てみましょう。82番ノードを指しています。先ほど言ったように、これは82ノードのクラスターです。では、何台あるか見てみましょう。おっと、ここには97番ノードが表示されています。97台、XNUMX台、XNUMX台、XNUMX台です。つまり、XNUMX台です。まだXNUMX台ではありません。XNUMX台です。まだ処理中ですが…ノードを強制的に削除しています。では、ここにあるXNUMX番ノードに移動して、「サーバーは何台ありますか?」と尋ねます。XNUMX番ノードにはXNUMX台しかありません。
つまり、97は既に他のXNUMXつが見えないという事実を突き止めています。だから、自分だけがここにいるクラスターだと認識しているのです。分裂があることは認識していません。なぜなら、分裂は… NCache 接続が回復した時に初めて、ノードの切断を認識します。つまり、今のところは他のノードがダウンしたと認識しているだけです。それで、この2つのノードで処理を続行します、と表示されます。そして、ここにあるもう1つのノードを見てみましょう。何があるか見てみましょう。ああ、わかりました!これで3つも残っています。つまり、この処理も完了し、部分的に切断されたノードを削除して、正常なクラスターに到達しました。しかし、これは3つのノードだけで構成されるクラスターですよね?
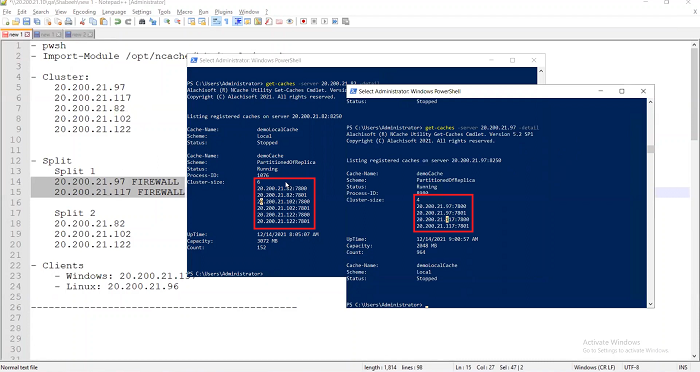
それで、ここにあるサーバー82に話しかけてみました。キャッシュ内にサーバーがいくつあるか尋ねたところ、97つしか返ってきませんでした。XNUMXにキャッシュ内にサーバーがいくつあるか尋ねたところ、XNUMXつしか返ってきませんでした。
はい!分割が発生しました。分割中に、アプリケーションが今のところ例外をスローしていないことがわかります。つまり、分割によってデータが失われていないということです。アプリケーションが例外に遭遇していない可能性もあるかもしれませんが、場合によっては例外が発生することもあります。
ネットワーク復旧時のスプリットブレインの検出と回復
よし!では、次のステップとして、スプリットブレインを有効化します。接続を復元し、スプリットブレインが検出されてリカバリが開始されるようにします。その前に、キャッシュ構成で、最初のトピックであるクラスター設定の一番下までスクロールすると、スプリットブレインの自動リカバリが既に有効になっていることをお見せします。
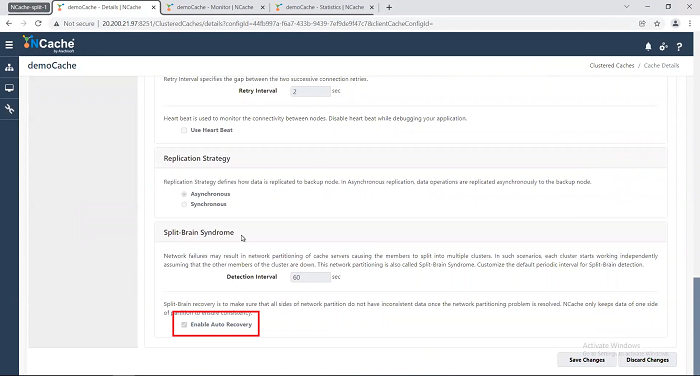
つまり、自動回復を有効にすると、 NCache スプリットブレインを検出すると、自動的に回復します。また、前述したように、接続が回復した時点でスプリットブレインを検出します。
では、97に戻って、このファイアウォールをオフにしましょう。まずは97でやってみます。ここに来て、このルールを無効にします。そして、ここに来て、このルールを無効にします。
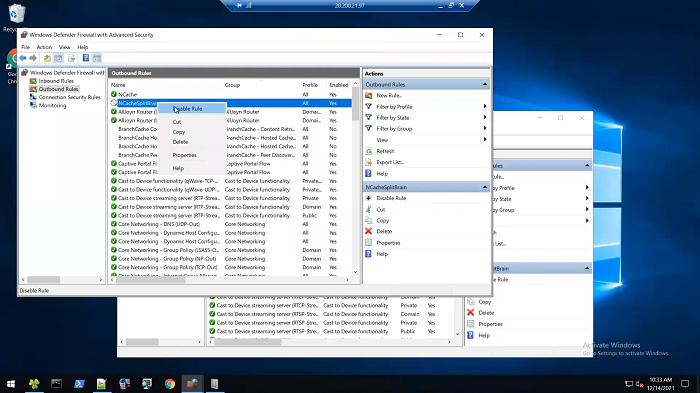
はい!それが終わったので、117番に移動して、ここでもルールを無効にしましょう。ルールを無効にします。ルールを無効にします。はい!これでルールを無効にしました。つまり、このファイアウォールはオフになったので、お互いが見えるようになります。あるいは、まもなく見えるようになります。すぐには起こりませんが、お互いが見えるようになります。そして、ご覧のとおり…
では、もう一度ここに戻って、「キャッシュを見せてください」と言います。もう一度、これを目の前に置いて、「はい、今は82番と通信中です」と言い、「キャッシュを見せてください」と言うと、82は「82、102、122があります」と言います。つまり、今のところまだ97つのキャッシュがあります。他の117つは見えていません。もうXNUMXつに行って、「キャッシュを見せてください」と言います。XNUMXとXNUMXが表示されています。今のところスプリットブレインリカバリはまだ開始されていませんが、いずれ開始されます。再試行には少し時間がかかるので、開始されます。ご覧のとおり、XNUMX、XNUMX、XNUMX、XNUMX、XNUMXのサーバーがすでに表示されています。そしてここにもXNUMX、XNUMX、XNUMX、XNUMX、XNUMXのサーバーがあります。
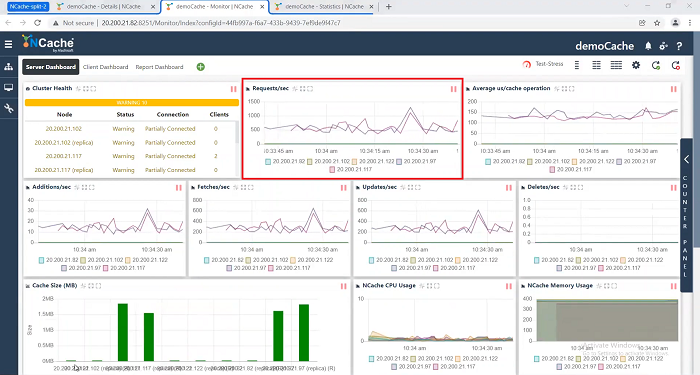
しかし、ここでも古き良きコマンドライン PowerShell ツールに頼って情報を取得します。キャッシュの取得呼び出しを実行します。82 に話しかけて、サーバーの台数を表示させます。まだ XNUMX XNUMX XNUMX です。そして、ここにサーバーの台数を表示させます。まだ XNUMX XNUMX です。つまり、XNUMX XNUMX と XNUMX XNUMX XNUMX です。つまり、接続が確立されていないということです。つまり、スプリットブレインからまだ回復していないということです。そのため、まだ部分的にしか接続されていない状態ですが、クライアントは動作を続けています。
よし!もう一度やってみよう。もう97つやってみよう。まだ終わってない。よし!ここへ。82…さあ!よし!これで、他のノードが見え始めた。102、122、97、そしてここにある97。でも、まだ一部だ。このうち82つが見えている必要がある。パーティションとレプリカの両方が見えているはずだ。だから、まだ102と通信できないんだろう。というのも…よし!さて、122、97、XNUMX、XNUMX。ここでもXNUMXつのノードが復元された。XNUMXつ全部だ。
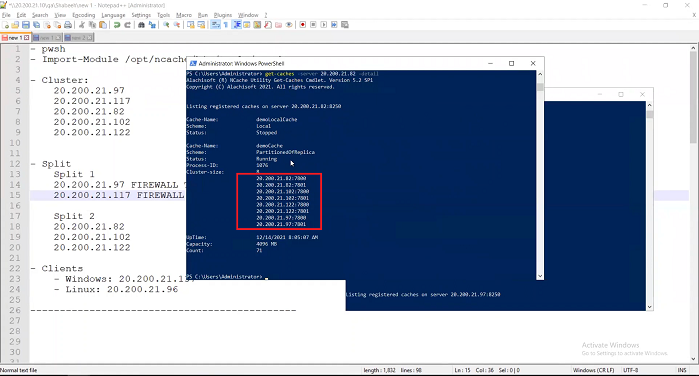
こっちに行ってみます。こっちです。どういうわけか… ちょっと待って!ここを変えましょう。82の代わりに97にしましょう。さあ、そうしてください。97にもXNUMXつのノードが表示されていますね。XNUMX、XNUMX、XNUMX、XNUMX、XNUMX。よし。これでXNUMXつのノードがすべて再接続されました。
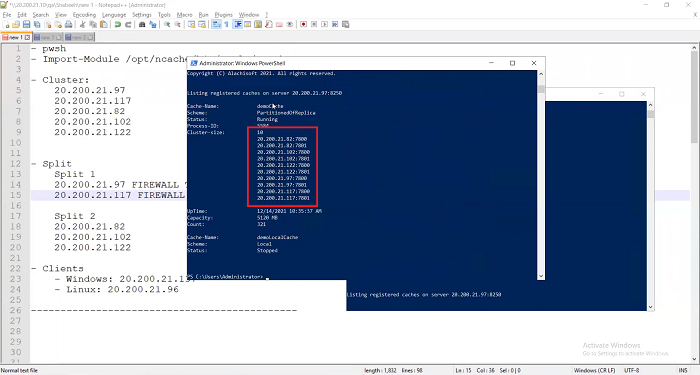
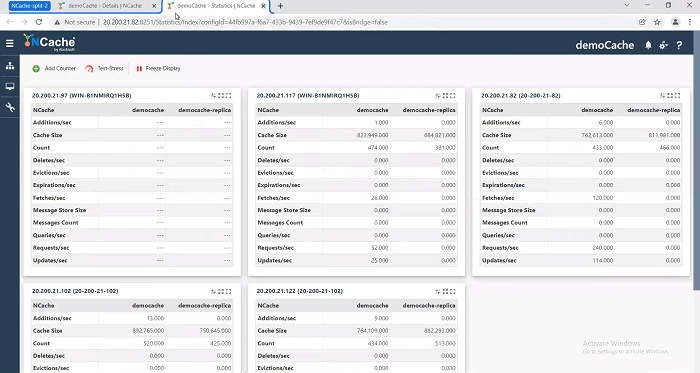
ここに来ます。このモニターを再起動します。もう一度ここに来ます。このキャッシュ、統計情報ですね。5つすべてが動作しており、クライアントがそれらと通信しています。つまり、クライアントが5つすべてと通信しているということは、クライアント接続も自動的に回復していることを意味します。モニターにも5つすべてが表示されます。ご覧の通り、5つのノードはすべて完全に接続されています。
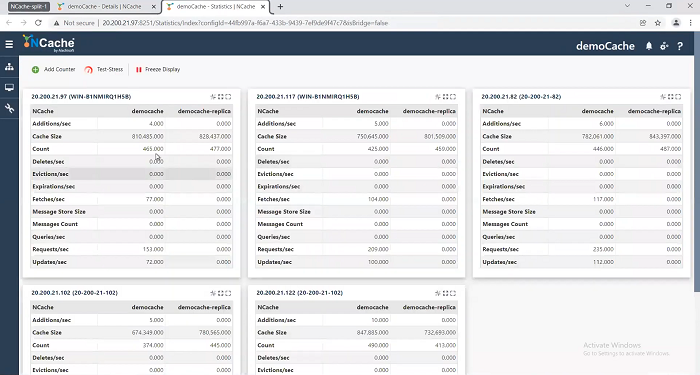
わかりました!では、もう一つの方に移りましょう。もう一つの方に行きましたか?こちらですね。わかりました!統計情報を見てみましょう。5つ全てですね。ご覧の通り、全てでアクティビティが発生しています。そして、5つ全てを監視しているところです。
結論
正常なクラスターから分割、そして再び正常なクラスターへと移行しました。ここでも、5ノードのクラスターになっていることがわかります。これでデモはほぼ終了です。ぜひ試してみてください。 NCache スプリット ブレイン リカバリにより、高可用性という機能が追加されることがわかります。