複製されたトポロジー
NCache 複数のサーバーが同時に故障した場合でも、ユーザーデータが失われないように、複製トポロジを提供します。クラスターでは、すべてのサーバーノードが同じデータのコピーを持っている場合、高可用性が実現します。つまり、クラスターは少数のノード障害が発生してもデータを失うことなく動作できます。 複製されたトポロジー ユーザーは複数のサーバーを所有でき、各サーバーは同じデータのコピーを保持します。つまり、各サーバーは互いの正確なレプリカです。そのため、複数のサーバーが同時に故障しても、データ損失は発生しません。
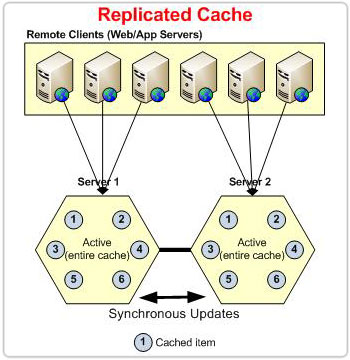
データの一貫性を保つための同期レプリケーション
クライアントが書き込み操作を実行するときはいつでも(「追加した」, アップデートまたは 除去するこの操作はクラスタ全体にブロードキャストされ、クライアントに制御が返される前に、すべてのキャッシュ サーバーでこの操作が複製されます。クライアントから操作を受け取ったサーバーが、これらの操作をブロードキャストする責任を負います。このプロセス中に、 シーケンストークン から取られます コーディネーターサーバー また、現在の操作に関連付けられ、この操作がすべてのサーバーで同じ順序で実行され、データの一貫性が確保されます。
ブロードキャストされた書き込み操作がいずれかのキャッシュサーバーで失敗した場合、その失敗はすべてのキャッシュサーバーにもブロードキャストされ、このデータが削除されます。 これは、クラスター全体でデータの一貫性を実現するために行われます。つまり、データがキャッシュに存在する場合、すべてのサーバーが同じデータを持ちます。
レプリケーションは同期的に行われるため、このトポロジは書き込み操作には適していません。これは、サーバーの数が増えると、書き込みアプリケーションに制御を返す前にデータをすべてのキャッシュ サーバーにレプリケートするのにより多くの時間がかかるためです。 書き込み操作のパフォーマンスの低下を避けたい場合は、クラスター サイズを 3 サーバーに制限することをお勧めします。
コーディネーターサーバーの役割
その コーディネーターサーバー (最上位のサーバーノード)は、次のような複数のタスクを実行します。 状態転送, ライトビハインド操作、のようなデータの無効化 有効期限など。キャッシュからアイテムを削除することを決定した後、他のすべてのノードにも、それらのアイテムをキャッシュストアから削除するように要求します。 コーディネーターサーバー クラスタを離れると、次に上位のサーバが コーディネーターサーバー そして責任を再開します。
読み取り操作の線形スケーラビリティ
すべてのサーバーが同じデータを持ち、クライアントがすべてのキャッシュサーバーに分散されているため。 したがって、すべてのサーバーが同じデータをクライアントに提供します。 クラスタ内のサーバーが多いほど、同時に処理されるデータ読み取り要求が多くなります。
接続負荷分散
複製トポロジーには特別な機能があり、 クライアント接続の自動バランス キャッシュ サーバー間でデータ負荷を共有するために、サーバー間でキャッシュを実行します。 クライアントがサーバーに接続すると、このサーバーは他のすべてのサーバー ノードにも同じ数のクライアントがあることを確認します。 他のサーバーのクライアント数が少ない場合は、クライアント接続要求を適切に拒否し、他のサーバーにリダイレクトします。 こうすることで、すべてのサーバーに同じ数のクライアントが存在し、他のキャッシュ サーバーと比較してより多くのクライアントで過剰な負荷がかかるサーバーはなくなります。
クライアントの接続性
レプリケート トポロジでは、クライアントは一度にクラスターの XNUMX つのサーバーのみに接続されます。 接続されているサーバーがダウンした場合、クライアントは人間の介入なしでクラスターの別のサーバーに自動的に接続します。
データ同期と状態転送
ノードがクラスタに参加または離脱するたびに、状態転送がトリガーされます。クラスタ内のいずれかのノードが状態転送を実行している間は、他のノードはクラスタに参加または離脱できません。
この制限は、状態転送に直接参加していないノードも含め、すべてのノードに適用されます。たとえば、3ノードのクラスタで、ノード3が状態転送を実行している場合、ノード2はノード3の状態転送が完了するまでクラスタから離脱できません。同様に、進行中の状態転送が完了するまで、新たなノードがクラスタに参加することもできません。
ノードの離脱によって状態転送がトリガーされる場合、すべてのノードが既に同一のデータを保持しているため、処理は最小限で済みます。しかし、新しいノードが参加すると、そのノードはキャッシュをクラスタの他のノードと同期させる必要があります。そのため、新しく参加したノードは、コーディネーターサーバーからキャッシュされたデータセット全体を要求します。すべての状態転送はコーディネーターによって管理されるため、コーディネーターは各ノードを適切に同期させるために必要な情報を保持しています。
