Topologies de répliques de partitions et de partitions
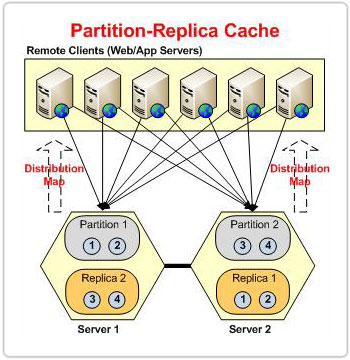
Partition-Replica est la topologie de mise en cache la plus évolutive et la plus disponible. NCacheIl fait évoluer le stockage et les transactions de manière linéaire en répartissant les données sur plusieurs partitions et en conservant une réplique pour chaque partition afin de garantir une haute disponibilité sans perte de données.
Dans un cluster, si tous les nœuds serveurs possèdent la même copie des données, la haute disponibilité est assurée. Autrement dit, le cluster peut survivre à la défaillance de quelques nœuds sans subir de perte de données. Cependant, cette approche ne garantit pas la scalabilité. Lorsque le volume de données augmente considérablement, il est nécessaire de réduire la réplication et de partitionner les données.
Le partitionnement signifie que vous devez répartir vos données entre plusieurs nœuds afin que le chargement des données en lecture et en écriture soit réparti. À mesure que vos données augmentent, vous pouvez ajouter davantage de nœuds de serveur dans le cluster pour contenir davantage de données. Chaque nœud de serveur d'un cluster est appelé une partition.
En partitionnant les données, vous pouvez atteindre l'évolutivité, mais la question est maintenant de savoir comment ces données sont-elles partitionnées ? Une solution simple pourrait consister à attribuer des données à une partition de manière circulaire, mais comment allons-nous trouver une donnée particulière une fois qu'elle a été ajoutée au magasin ?
Grâce au round-robin, nous perdrons la possibilité de suivre l’emplacement des données. Nous avons besoin d’une meilleure manière de distribuer les données, garantissant non seulement une répartition équitable des données, mais également la possibilité de les consulter rapidement.
Note
La seule différence entre les topologies Partitioned et Partition-Replica est que la première n'a pas de caches de réplique, ce qui la rend sujette à la perte de données.
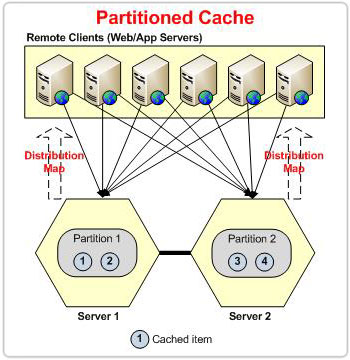
Partitionnement de données basé sur le hachage pour les caches de partition
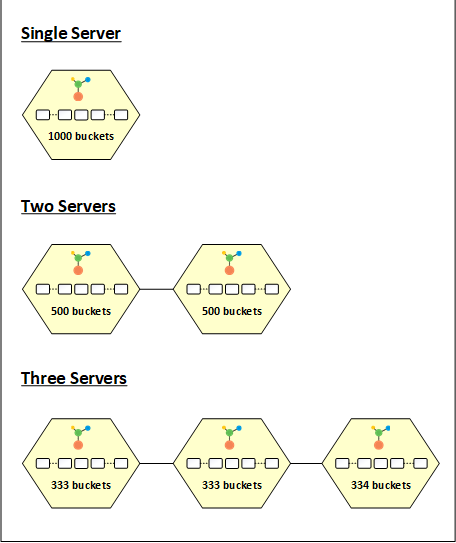
NCache divise les données en plusieurs morceaux et place ces morceaux dans différentes partitions. Ces morceaux sont appelés buckets. Il existe un total de 1000 1000 compartiments répartis à parts égales entre les nœuds du cluster. L'idée ici est d'appliquer une fonction de hachage sur la clé de l'élément et de la moder par le nombre total de buckets (XNUMX dans ce cas) pour obtenir un bucket propriétaire pour ces données.
Carte de répartition
Le serveur coordinateur du cluster a la responsabilité de générer une carte contenant la distribution du compartiment. Cette carte est appelée carte de répartition. Le serveur coordinateur partage cette carte de distribution avec le reste des partitions du cluster et avec les clients connectés. Cette méthode vous donne toujours la même adresse de compartiment pour un élément, quel que soit le nombre de serveurs dans le cluster. Même si le compartiment peut passer d'une partition à une autre à tout moment, le compartiment d'un élément ne peut jamais changer. Cela signifie que lorsqu’un bucket se déplace, il emporte toutes ses données avec lui.
Répartition des données selon la carte de répartition
Lorsque vous démarrez un cluster de cache avec une seule partition, les 1000 500 buckets sont attribués à ce nœud. Cela signifie que toutes les données sont transférées vers cette partition. Lorsque vous démarrez un autre nœud du cluster, les buckets sont répartis de manière égale entre les deux partitions contenant chacune 333 buckets. De même, lors de l'ajout d'un troisième nœud au cluster, les buckets sont à nouveau redistribués. Dans ce cas, les trois nœuds auront respectivement 333, 334 et XNUMX buckets.
De même, lorsqu'une partition quitte le cluster, la distribution des buckets change. Par exemple, lorsqu'une partition quitte un cluster à trois nœuds, les buckets 333 ou 334 appartenant à cette partition sont redistribués entre les deux nœuds restants. Chaque fois qu'un changement se produit dans la distribution, cela déclenche un transfert d'état pour rééquilibrer les données entre les nœuds, en fonction de la distribution des buckets.
Distribution aléatoire des données
Cette méthode de partitionnement offre une part d'aléatoire importante pour garantir un partage équitable des données entre les compartiments et les partitions. Cependant, avec cette méthode, vous perdez le contrôle sur l'affectation des données à chaque partition. Généralement, l'emplacement de vos données ne vous intéresse pas. Cependant, dans certains cas, vous souhaiterez peut-être que les données associées soient colocalisées. Pour cela, vous pouvez utiliser l'affinité de localisation, où une fonction de hachage est appliquée à une partie de la clé plutôt qu'à la totalité.
Distribution équilibrée des données
Chaque fois que les buckets sont redistribués entre les nœuds, NCache garantit que les buckets sont redistribués de telle manière que la taille des données reçues par chaque partition soit presque la même. Chaque partition partage les statistiques des buckets qu'elle possède, à un intervalle configurable, avec d'autres partitions du cluster. Cela permet de générer un cluster équilibré carte de répartition lorsque cela est nécessaire, ce qui est équitable en termes de données que chaque partition reçoit. L'équilibrage est basé sur la taille des données plutôt que sur le nombre d'éléments. Cet équilibrage est généralement assuré au moment de la redistribution du bucket suite à la sortie ou à l'adhésion d'un nœud.
Équilibrage automatique et manuel de la charge de données
Cependant, il existe une légère possibilité que vous observiez qu'une ou plusieurs partitions d'un cluster sont biaisées et reçoivent plus de charge que les autres. Dans ce cas, vous avez la possibilité d'équilibrer manuellement les données d'un nœud particulier, ce qui garantit que les données de ce nœud sont égales à la taille moyenne des données reçues par chaque partition. Il existe également une fonctionnalité appelée « Équilibrage automatique de la charge des données » qui effectue le travail automatiquement en arrière-plan. Cette fonctionnalité est désactivée par défaut car, si elle est utilisée sans précaution, elle peut entraîner une redistribution fréquente des compartiments et donc des transferts d'état indésirables entre les partitions.
Taille des données par partition
La taille des données que chaque partition peut contenir est égale à la taille du cache configurée. Par exemple, si la taille du cache configurée est de 2 Go et que la taille du cluster est composée de trois partitions, la taille totale du cache sur ce cluster est de 6 Go.
Ainsi, avec cette topologie, non seulement vous répartissez la charge de lecture et d'écriture entre les serveurs, mais vous augmentez également la capacité à chaque nouveau serveur ajouté au cluster.
Réplique de partition
Maintenant que nous avons couvert la façon dont la topologie Partition-Replica adapte la charge de transaction et la capacité de stockage. Parlons de la façon dont il gère la haute disponibilité. Chaque nœud du cluster possède une sauvegarde d'une autre partition qui agit comme une partition passive appelée réplique. En cas de défaillance d'un nœud, le cluster de cache sait que les données appartenant à la partition perdue sont toujours disponibles dans sa réplique. Ainsi, les applications clientes continuent de fonctionner correctement car les données appartenant à la partition perdue sont toujours servies par le cluster via cette réplique.
Les applications clientes communiquent directement avec les partitions actives uniquement. Chaque partition est alors responsable de la réplication de ses données vers sa réplique respective.
Même si le degré de réplication dans cette topologie n'est pas aussi élevé que dans le Topologie répliquée, avoir au moins une sauvegarde vous garantit qu'en cas de panne de nœud, vos données sont toujours en sécurité. Tant qu'il n'y a pas de pannes de nœuds simultanées, les données de cette topologie sont sécurisées, ce qui couvre la plupart des scénarios.
Chaque nœud de cluster a un actif et un réplica, et les instances actives et répliquées existent dans le même processus de cache sur chaque nœud de cluster.
En raison de l'existence de l'instance de réplica sur chaque nœud de cache, elle nécessite la même taille de mémoire que celle de l'instance de cache active. Cela signifie que chaque nœud de cache Partition-Replica nécessite une double mémoire par rapport à sa taille de cache configurée.
Toutes les données ajoutées par le client sont stockées dans le nœud actif, d'où elles sont ensuite répliquées vers sa réplique dédiée, qui se trouve sur un autre nœud du cluster. Cette disposition des nœuds de réplique garantit que les données ne sont pas perdues lorsqu'un nœud actif tombe en panne.
Stratégie de sélection des répliques
NCache sélectionne automatiquement le nœud de réplique en fonction de l'ordre dans lequel les nœuds rejoignent le cluster de cache. La réplique du premier nœud est présente sur le nœud serveur qui a rejoint le cluster après le premier nœud, et ainsi de suite. Et, la réplique du dernier nœud est placée sur le premier nœud serveur (serveur coordinateur) du cluster de cache.
Tout ce processus de sélection de répliques est automatique. Chaque fois qu'un nœud de serveur quitte le cluster de cache ou qu'un nouveau nœud rejoint le cluster de cache, les répliques sont également réaffectées en fonction de la carte d'appartenance mise à jour.
Consommation de mémoire à nœud unique
Chaque nœud de serveur (actif et réplica) conserve un enregistrement de la configuration taille du cache et garantit que les données stockées ne dépassent jamais la limite de mémoire spécifiée. Il existe deux scénarios spéciaux dans lesquels cette vérification de limite de mémoire fonctionne différemment. Ils sont expliqués ci-dessous :
- Un seul nœud est en cours d’exécution et des données y sont ajoutées. L'instance de cache active peut utiliser deux fois la taille de cache spécifiée pour contenir les données, car sa réplique n'est d'aucune utilité.
- Dans un cluster à plusieurs nœuds, lorsque tous les autres nœuds quittent le cluster et qu'un seul nœud reste actif, les données de son instance de cache de réplique sont transférées vers l'instance de cache active. La mémoire libre de la réplique est ensuite consommée par le cache actif pour accueillir les données reçues de la réplique.
Stratégies de réplication
La topologie Partition-Replica a deux stratégies de réplication pour répliquer les données du nœud de serveur actif vers le nœud de réplique :
Réplication asynchrone : Dans ce mode, les files d'attente en arrière-plan sont utilisées pour répliquer les données sans bloquer les opérations client. Chaque opération d'écriture est mise en file d'attente et des threads d'arrière-plan dédiés sélectionnent les données de cette file d'attente en morceaux et les répliquent sur l'instance de réplica. Cette stratégie de réplication convient aux applications qui ont tendance à effectuer des écritures fréquentes mais qui ne souhaitent pas attendre que les réplications soient terminées avant leur prochaine opération de cache. Cependant, il existe un risque de perte de données si un nœud quitte brusquement. Dans ce cas, les opérations en file d'attente qui n'ont pas été répliquées seront perdues.
Réplication de synchronisation : Avec le mode de réplication synchrone, chaque opération d'écriture du client est répliquée sur la réplique avant de rendre le contrôle à l'application cliente. Ce mode de réplication garantit que les instances de cache actives et répliquées disposent de la même copie des données utilisateur. Si la réplication échoue sur l'instance de réplique, cet élément est supprimé des instances de cache active et de réplique.
Comportement de fonctionnement
Expulsion, Expiration, Écriture directe/écriture différéeLes fonctions `write`, `write`, etc., sont contrôlées par le nœud actif. Lorsqu'un nœud actif supprime un élément de son cache en fonction de l'une des caractéristiques mentionnées, il le réplique sur sa réplique afin de supprimer les données précédemment stockées. De même, les opérations d'écriture immédiate et différée ne sont effectuées que depuis le cache actif.
Dans la topologie Partition-Replica, les clients sont directement connectés à chaque nœud de serveur, mais uniquement à ses partitions/instances actives. Cependant, il existe quelques situations dans lesquelles les clients interagissent temporairement avec les instances de réplica via des appels de cluster. Ils sont expliqués ci-dessous :
- Lors du transfert d'état, lorsqu'un nœud quitte le cluster, les opérations client destinées au nœud sortant sont servies depuis sa réplique.
- Lorsqu'un cluster est en mode maintenance, toutes les opérations destinées au nœud en maintenance sont servies à partir de sa réplique pendant la période de maintenance.
Transfert d'État
Le transfert d'état est un processus de transfert/copie automatique des données entre les nœuds de cache. Le transfert d'état est déclenché lorsqu'un nouveau nœud rejoint le cluster ou qu'un nœud actuel quitte le cluster. Quitter/Joindre un nœud entraîne également un changement d'appartenance dans le cluster.
Lorsqu'un nœud reçoit la mise à jour carte de répartition, il vérifie l'existence des buckets (qui lui ont été attribués) dans son environnement local. Les compartiments attribués qui n'existent pas dans l'environnement local du nœud sont extraits un par un des autres nœuds. Ainsi, en fonction du nombre de nœuds de serveur dans le cluster de cache, plusieurs compartiments sont transférés lors du transfert d'état.
Le transfert d'état est déclenché dans les trois scénarios majeurs suivants :
Lors de la jonction de nœud
Lorsqu'un nouveau nœud rejoint le cluster de cache, le serveur coordinateur génère une nouvelle carte de distribution pour distribuer les compartiments des nœuds actuels au nœud nouvellement rejoint. Et, après avoir reçu la carte de distribution, le nœud nouvellement rejoint extrait les compartiments des nœuds actuels. Au cours de ce transfert d'état, le nœud nouvellement joint extrait un compartiment à la fois. Après avoir reçu un compartiment, il extrait le compartiment suivant, et ainsi de suite, jusqu'à ce qu'il récupère tous ses compartiments attribués à partir d'autres nœuds, selon sa carte de distribution.
À la sortie du nœud
De même, le transfert d'état est déclenché lorsqu'un nœud de cache quitte le cluster de cache. Le serveur coordinateur redistribue ses buckets parmi les nœuds actifs du cluster. Dans ce cas, les nœuds actifs extraient les données de la réplique du nœud sortant.
Sur l'équilibrage automatique de la charge des données
La topologie Partition-Replica a une caractéristique de Équilibrage automatique de la charge des données dans lequel il surveille en permanence la distribution des données entre les nœuds du cluster. Et, si la distribution des données ne se situe pas dans la plage de distribution attendue (60 % à 40 %), il déclenche automatiquement l'équilibrage automatique de la charge des données. Dans ce cas, le serveur coordinateur régénère une nouvelle carte de distribution et redistribue les buckets de manière à ce que tous les nœuds du cluster aient des données de taille égale.
Note
L'équilibrage de la charge des données peut également être effectué manuellement du NCache Centre de gestion.
Quelle que soit la raison du transfert d’État, l’ensemble de ce processus est automatique et transparent. Et, lors du transfert d'état, en particulier lorsqu'un nœud de serveur quitte le cluster de cache, toutes les opérations client destinées au nœud sortant sont servies depuis sa réplique via des opérations de cluster.
Les répliques effectuent également un transfert d'état à partir de leurs nœuds actifs, tout comme les autres nœuds actifs. Les réplicas extraient les compartiments qui leur sont attribués de leurs nœuds actifs pour récupérer la copie des données au moment du transfert d'état. Cependant, ce transfert d'état n'a lieu qu'en cas de réaffectation de compartiment. Sinon, les données sont répliquées vers les réplicas via le mécanisme de réplication.
Différentes façons de surveiller le transfert d'état
NCache fournit plusieurs façons de surveiller le transfert d'état dans le cluster de cache. Ils sont expliqués ci-dessous :
- Journaux du cache : Chaque fois qu'un transfert d'état est déclenché et arrêté, l'opération est consignée dans les journaux de cache du cluster. Ces journaux de cache se trouvent sous le répertoire suivant : %NCHOME%\fichiers journaux dossier.
- Compteurs personnalisés : NCache publie également des compteurs personnalisés qui sont visibles sur Windows et Linux.
- Compteurs basés sur Perfmon : Sur Windows, NCache publie également les compteurs de transfert d'état via l'outil Windows Perfmon.
- Journaux des événements Windows : Les informations/événements liés au transfert d'état sont également publiés dans les journaux d'événements Windows.
- Alertes courrier électronique: Des alertes email spécifiques aux transferts d'état peuvent être configurées lors de leur lancement et de leur arrêt.
Une fois la surveillance du transfert d'état lancée, le coordinateur interroge en continu tous les nœuds du cluster pour connaître leur statut de transfert d'état tant que le cluster reste en état de transfert d'état. 30 secondes intervalle entre les requêtes successives. Chaque nœud renvoie le temps écoulé depuis sa dernière activité liée au transfert d'état. Si cette durée dépasse 3 minutes, le transfert d'état est considéré comme bloqué sur ce nœud. Lorsqu'un Transfert d'État bloqué Si une anomalie est détectée, le coordinateur désactive l'indicateur de transfert d'état pour autoriser les activités du cluster telles que l'ajout et le retrait de nœuds.
Synchronisation des modifications d'appartenance au cluster et de la carte de distribution
Comme indiqué précédemment, lorsqu'un nœud rejoint ou quitte le cluster, la composition de ce dernier est modifiée. Dans le cadre de ce processus, le cluster génère une carte de distribution mise à jour reflétant le nouvel ensemble de nœuds actifs. La synchronisation entre les nœuds n'étant pas instantanée, il peut s'écouler un court laps de temps durant lequel certains nœuds peuvent disposer de la carte de distribution mise à jour tandis que d'autres n'en possèdent pas encore.
État de transition pour la cohérence
Pour garantir la cohérence lors des changements de membres, le cluster entre dans un état de transition, durant lequel :
- La dernière carte de distribution stable (mise en cache) continue d'être fournie aux clients.
- La carte de distribution mise à jour n'est pas partagée en externe tant que tous les nœuds ne sont pas complètement synchronisés.
Par exemple, dans un cluster à deux nœuds auquel un troisième nœud est ajouté, le cluster continue de fonctionner avec la carte de distribution à deux nœuds jusqu'à ce que les trois nœuds soient entièrement synchronisés. Une fois la synchronisation terminée, le coordinateur quitte l'état de transition et partage la carte de distribution mise à jour à trois nœuds.
Une fois que le coordinateur a vérifié que tous les nœuds ont bien reçu et appliqué la HashMap mise à jour, il indique que le cluster n'est plus en phase de transition. Chaque nœud met alors à jour sa référence en cache avec la nouvelle HashMap. Le coordinateur notifie ensuite les clients de la modification de la HashMap et ordonne à tous les nœuds du cluster de démarrer le transfert d'état.
Cela garantit la cohérence entre le client et le serveur lors des mises à jour d'appartenance au cluster.
Délai d'expiration de la reconnexion du socket
Dans un environnement clusterisé, si la connexion entre deux nœuds de serveur est interrompue, NCache tente automatiquement de rétablir la connexion. Ces tentatives de reconnexion ont lieu au niveau du socket. Cependant, le comportement du délai d'expiration du socket dépend du système d'exploitation et peut varier selon les environnements. Pour contrôler ce comportement, NCache fournit un dédié Délai d'expiration de la reconnexion du socket, qui définit le temps nécessaire pour établir une connexion socket entre deux nœuds. Par défaut, le délai d'expiration de la reconnexion socket est défini sur 10 secondes, avec une valeur minimale de 5 secondes et un maximum de 30 secondes.
Ce délai d'expiration garantit que la récupération de la connexion au niveau du cluster s'effectue dans ce laps de temps défini. Lorsque deux serveurs perdent la connectivité, les clients connectés à ces serveurs peuvent également être affectés, notamment si un serveur est isolé du reste du cluster. Afin d'éviter que les tentatives de reconnexion internes au cluster n'interfèrent avec la connectivité des clients, ce délai d'expiration est configuré conformément à la Fenêtre élégante pour le clientet est soigneusement sélectionné pour laisser suffisamment de temps aux nœuds du serveur pour tenter une reconnexion sans impacter négativement le délai de grâce du client.
Si une tentative de connexion socket échoue dans le délai imparti :
- La tentative est terminée.
- Une nouvelle tentative est lancée.
Important
Par défaut, 2 tentatives de reconnexion sont réalisées avec un 2 secondes intervalle de sommeil.
Pour configurer cet indicateur, veuillez consulter Connectivité du serveur docs.
Exception de changement d'adhésion
MembershipChangeInException Cette exception peut se produire au niveau d'un nœud lors d'une opération de démarrage, d'arrêt, d'ajout ou de retrait pendant un transfert d'état. Au niveau du cache, elle se produit toutefois lors du démarrage de celui-ci. Si nécessaire, l'ajout d'un nœud peut être forcé même pendant un transfert d'état, permettant ainsi la poursuite de l'opération tout en préservant la cohérence du cluster.
Connectivité client
Comme expliqué dans le partitionnement, les données sont réparties entre tous les serveurs du cluster. Contrairement aux autres topologies, le client des topologies partitionnées doit se connecter à toutes les partitions, où chaque partition contient un sous-ensemble des données totales.
Le client reçoit une carte de distribution lors de l'appel de connexion, qui renseigne le client sur les nœuds de serveur en cours d'exécution et leur distributions basées sur le hachage. Le client se connecte à tous les nœuds du serveur pour obtenir des données complètes du cache. Le client obtient un carte mise à jour à chaque modification de l'appartenance au cluster afin de maintenir la connectivité après l'achèvement de phase de transitionLe client reçoit également une notification lors du départ ou de l'arrivée d'un membre et rétablit la connectivité en conséquence. plan.
Le client effectue intelligemment les opérations de lecture/écriture directement sur le nœud serveur contenant la clé en fonction du carte de distribution basée sur le hachage il reçoit. Pour toutes les opérations où la clé n'est pas connue, comme Recherche SQL, ObtenirByTag, etc., le client diffuse la requête à tous les nœuds du serveur et combine leurs réponses respectives.
Si, dans tous les cas, le client ne parvient pas à se connecter à un nœud de serveur du cluster, cela ne signifie pas qu'il ne parvient pas à écrire et à récupérer des informations à partir de ce nœud de serveur. Pour cela, il utilise les autres nœuds serveurs auxquels il est connecté, qui demandent en son nom au nœud serveur inaccessible d'effectuer des opérations. Par exemple, si le client ne parvient pas à se connecter au nœud 1 et souhaite obtenir une clé qui réside dans le nœud 1, il envoie la demande au nœud 2, qui redirige vers le nœud 1 et renvoie la réponse.
Fenêtre de grâce pour le client
Si, pour une raison quelconque, le client ne parvient pas à se connecter à un nœud serveur du cluster, l'opération n'échoue pas immédiatement. Au lieu de cela, le client maintient une fenêtre de reconnexion (Fenêtre de grâce pour le client) de 60 % du délai d'expiration de la requête configuré (soit 54 secondes par défaut)Pendant cette période, le client tente de rétablir la connexion et met temporairement en file d'attente toutes les requêtes entrantes. Si la connectivité est rétablie dans ce délai, les opérations en file d'attente sont transmises au nœud approprié et traitées normalement. Si la connexion ne peut être rétablie pendant ce délai, les opérations en file d'attente échouent, le client génère une exception liée à la connexion et doit attendre la mise à jour de la carte.
Mode de maintenance
Lorsqu'un correctif ou une mise à niveau du matériel/logiciel est requis sur un NCache serveur, vous ne rencontrerez peut-être pas de temps d'arrêt de l'application. Cependant, l'arrêt d'un nœud de cache déclenche transfert d'état Au sein du cluster de cache, cela entraîne une utilisation excessive des ressources telles que le réseau, le processeur et la mémoire. Ce processus de transfert d'état peut s'avérer coûteux en fonction de la taille des données du cache et du cluster. Une procédure de mise à niveau classique consiste à redémarrer chaque nœud de cache un par un, ce qui nécessite deux transferts d'état : un lors du départ du nœud et l'autre lors de son ajout.
Le mode de maintenance Cette procédure permet d'éviter les transferts d'état coûteux lors de la maintenance des serveurs de cache. Lorsqu'un serveur de cache est arrêté pour maintenance pendant une durée déterminée, la réplique du nœud concerné devient temporairement active et traite les requêtes client. Une fois la maintenance terminée et dans le délai imparti, le nœud (qui était en maintenance) reprend du service, et un transfert d'état est alors initié pour le synchroniser avec le cluster de cache.
Le cluster sort du mode maintenance dans trois états différents. Si le nœud de maintenance rejoint le cluster de cache dans le délai imparti, un transfert d'état est initié pour synchroniser l'état du cluster, et celui-ci sort du mode maintenance. Si le nœud de maintenance ne parvient pas à rejoindre le cluster de cache dans le délai imparti, le cluster considère le nœud comme hors service, sort du mode maintenance et génère un nouveau cluster. planet lance le transfert d'état. Outre la réussite et l'échec, une autre anomalie survient lors de la sortie du mode maintenance : le départ d'un nœud. Si le cluster est en mode maintenance et qu'un nœud autre que le nœud de maintenance le quitte, le cluster sort du mode maintenance, ce qui peut entraîner une perte de données.
Récupération du cerveau divisé
Le terme Cerveau divisé Ce phénomène se produit lorsqu'un cluster de cache se divise en plusieurs sous-clusters. Les serveurs de cache d'un cluster communiquent via TCP. Par conséquent, toute perturbation ou tout problème réseau peut entraîner une perte de communication entre les serveurs du cluster. Si cette perte de communication persiste au-delà d'un certain temps, la carte d'appartenance au cluster évolue en fonction de la connectivité entre les serveurs. Il en résulte la formation de plusieurs sous-clusters, appelés « splits ». On parle alors de « cerveau divisé » car les sous-clusters ne peuvent plus communiquer entre eux, à l'image des hémisphères cérébraux dans le syndrome de split-brain.
Tous les sous-clusters sont sains et traitent les données qu'ils contiennent. De plus, les clients peuvent se connecter à ces sous-clusters pour d'autres opérations de lecture/écriture. Le client reçoit une carte d'appartenance des serveurs de cluster pour mettre à jour la connectivité. Ici, le client peut se connecter à n'importe quel sous-cluster en fonction de la première carte reçue.
Le problème de split-brain est détecté uniquement lorsque la communication entre les serveurs reprend et qu'il s'avère que tous les serveurs sont opérationnels mais ne font pas partie d'un même cluster. Deux ou plusieurs splits sont possibles selon l'importance de la perte de communication. Dès la détection du split-brain, le processus de récupération se lance. Tous les splits se rétablissent un par un jusqu'à la fusion complète de tous les sous-clusters.
Le processus de récupération suite à une panne de cluster (ou split-brain) se déclenche immédiatement après sa détection. Il prend en compte deux clusters sains, identifie leurs serveurs coordinateurs, détermine le cluster gagnant et le cluster perdant en fonction de la taille du cluster, verrouille le cluster perdant pour restreindre l'activité des clients sur ce cluster, et modifie la composition du cluster. Ensuite, tous les clients sont redirigés vers le cluster gagnant, et tous les nœuds du cluster perdant sont redémarrés un par un pour rejoindre le cluster gagnant. Tous les clusters perdants fusionnent ensuite avec le cluster gagnant de la même manière, et le cluster retrouve son fonctionnement normal.
Une perte de données est attendue dans Cerveau divisé récupération lorsque le cluster se divise en plusieurs sous-clusters, une perte de données se produit car plusieurs nœuds d'un cluster partent simultanément. Les sous-clusters peuvent traiter les demandes des clients dans un état de Cerveau divisé, ces opérations peuvent être perdues si le split auquel le client est connecté est un split perdant qui est redémarré pour rejoindre le cluster principal.
