NCache Architettura di recupero del cervello diviso
NCache fornisce un'importante capacità architettonica ad alta disponibilità chiamata Split Brain Detection and Recovery. Guarda questo video per conoscere questa funzionalità e poi guarda una demo pratica di NCache Recupero del cervello diviso.
Oggi parlerò di NCache architettura di recupero split-brain e ne fornirò anche una demo.
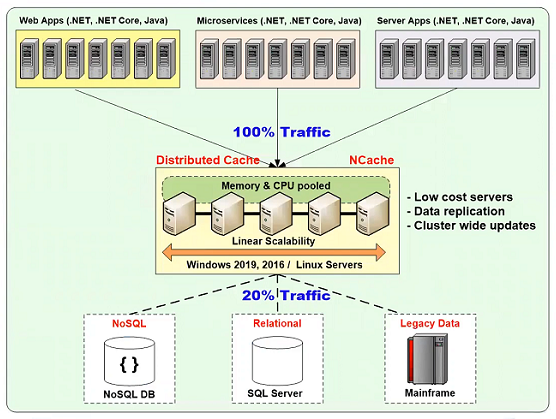
NCache È una cache distribuita in memoria per applicazioni .NET e .NET Core. Supporta anche applicazioni Java e Node.js. NCache Viene utilizzato in applicazioni con transazioni più elevate, in cui l'applicazione è in esecuzione su più server applicativi. Possono essere applicazioni web, applicazioni di microservizi o qualsiasi altra applicazione server. NCache si trova tra il livello applicativo e il database, che si tratti di un database relazionale di tipo SQL Server o Oracle, o di qualsiasi database NoSQL come CosmosDB o MongoDB, o di qualsiasi database o dato mainframe legacy. E, NCache di solito ha due o più server cache in un cluster e per questo ambiente applicativo di importanza critica NCache ti garantisce un'elevata disponibilità e, come parte di tale elevata disponibilità, c'è una funzionalità molto importante chiamata rilevamento e recupero split-brain di cui parlerò.
Architettura dinamica del cluster di cache
Architettura peer-to-peer (auto-riparazione)
- Nessun singolo punto di errore (nessun master/slave)
- Coordinatore del cluster nodo più vecchio, il successivo più vecchio è il successore automatico
Prima di addentrarmi nel tema dello split-brain, vorrei darvi una rapida panoramica NCache architettura di clustering della cache dinamica.
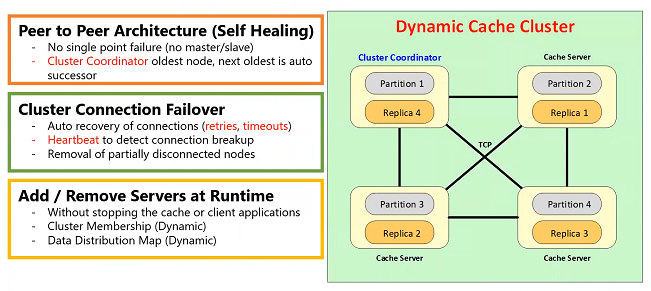
Si tratta di un'architettura basata su TCP in cui ogni server è connesso a tutti gli altri server tramite un socket TCP. Si tratta di un'architettura peer-to-peer con capacità di auto-riparazione. Auto-riparazione significa che si adatta automaticamente a qualsiasi cambiamento. E, grazie a questa architettura peer-to-peer, non esiste un singolo punto di errore. Ciò significa che non esiste un master né uno slave. Esiste un nodo coordinatore del cluster, che di solito è il nodo più vecchio del cluster. Tuttavia, se questo dovesse mai guastarsi, il nodo successivo più vecchio diventa automaticamente il suo successore. Un coordinatore del cluster è responsabile della gestione del cluster. Gestisce l'appartenenza al cluster. Gestisce, in caso di una topologia Partizione o Partizione-Replica, la mappa di distribuzione dei dati. E gestisce anche lo stato di salute del cluster.
Failover della connessione del cluster
- Ripristino automatico delle connessioni (riprova, timeout)
- Battito cardiaco per rilevare l'interruzione della connessione
- Rimozione dei nodi parzialmente disconnessi
Ora, come ho detto, ogni nodo di questo cluster è connesso a tutti gli altri nodi e tiene traccia di quella connessione. E, se quella connessione dovesse interrompersi, c'è una funzionalità di failover della connessione all'interno del cluster, che fa sì che il nodo esegua automaticamente dei nuovi tentativi, tentativi multipli, un'opzione configurabile e ogni nuovo tentativo ha un timeout. E c'è anche una funzionalità di heartbeat, che continua a inviare un heartbeat a intervalli configurabili per assicurarsi che la connessione socket sia attiva. Il motivo per cui tutto ciò viene fatto è perché nella maggior parte dei casi è sufficiente a garantire che qualsiasi interruzione della connessione venga automaticamente ripristinata o recuperata. E il motivo è che i server cache sono solitamente distribuiti nello stesso data center, di fatto nella stessa subnet. Quindi, la connessione tra questi server cache è solitamente molto affidabile. E lo split-brain non si verifica molto frequentemente, ma a volte accade. E, quando accade, parlerò di come lo gestiamo.
Aggiungi/Rimuovi server in fase di esecuzione
- Senza arrestare la cache o le applicazioni client
- Appartenenza al cluster (dinamica)
- Mappa di distribuzione dei dati (dinamica)
In ogni caso, questa architettura consente di aggiungere o rimuovere qualsiasi server cache in fase di esecuzione senza arrestare la cache o le applicazioni. Inoltre, ogni volta che si aggiunge un server cache al cluster, il coordinatore del cluster aggiorna la mappa di appartenenza del cluster e la propaga dinamicamente a tutti i server cache, che a loro volta la propagano dinamicamente a tutti i client. Allo stesso modo, se si tratta di una topologia di partizione o di replica di partizione, anche la mappa di distribuzione dei dati viene aggiornata ed è possibile accedere al NCache Per maggiori dettagli, consulta il video sull'architettura. Tuttavia, una topologia di partizione o replica di partizione ha 1000 bucket, che costituiscono la mappa di distribuzione. La mappa, in pratica, indica ai server quali bucket ha ciascun server e, quando questa viene inviata ai client, questi ultimi sanno dove si trovano i dati. Questo è il cluster di cache dinamica.
Connessioni client dinamiche
Aggiungi/Rimuovi client in fase di esecuzione
- Senza fermarsi la cache o le applicazioni client
Il secondo aspetto riguarda le connessioni client dinamiche, ovvero, proprio come la connessione all'interno del cluster è dinamica, anche la connessione tra i client e il cluster è dinamica.
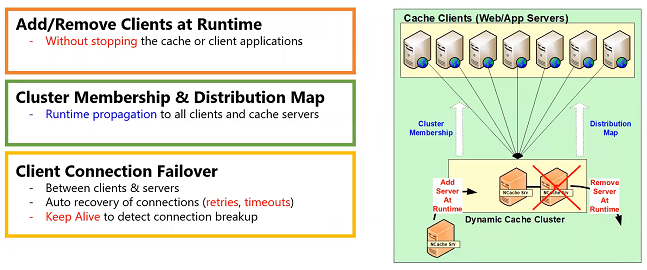
Failover della connessione client
- Tra client e server
- Ripristino automatico delle connessioni (riprova, timeout)
- Keep Alive per rilevare l'interruzione della connessione
Si tratta di una connessione TCP molto leggera. E, se la connessione dovesse interrompersi, è disponibile una funzionalità di failover della connessione che prevede nuovi tentativi e timeout. Esiste anche una funzionalità di keep alive, in cui il client continua a inviare un messaggio di tipo heartbeat al cluster per assicurarsi che la connessione rimanga attiva. In realtà, la probabilità di interruzione della connessione tra i client e il cluster è maggiore rispetto a quella all'interno del cluster stesso, e il motivo è che i client potrebbero essere distribuiti in una subnet separata, anche attraverso il firewall. Quindi, tutto ciò di solito aumenta le probabilità di interruzione dei socket. Quindi, ogni volta che ciò accade, i client possono riconnettersi. Esiste quindi una funzionalità di failover della connessione. L'intera architettura consente di aggiungere o rimuovere client in fase di esecuzione senza arrestare la cache o l'applicazione.
Mappa di appartenenza e distribuzione del cluster
- Propagazione in fase di esecuzione a tutti i client e server di cache
Ogni volta che viene aggiunto un client, il client ottiene le informazioni di appartenenza al cluster dal cluster stesso e, se si tratta di una topologia di partizione o di replica di partizione, ottiene anche la mappa di distribuzione dei dati che ho mostrato qui dal cluster. Questo consente al client di sapere automaticamente quanti server sono presenti nel cluster e chi sono. In questo modo, è possibile connettersi a essi solo in una topologia di partizione o di replica di partizione e conoscere anche la mappa di distribuzione dei dati.
Rilevamento del cervello diviso
Ogni nodo rileva l'interruzione della connessione
- Mantiene la connessione con tutti i nodi ove possibile
- Suppone che gli altri siano giù
Quindi, considerando tutta questa architettura, nonostante la resilienza integrata nella connessione TCP tramite tentativi e timeout, sussiste comunque una situazione di stallo, ma una connessione tra i server di cache potrebbe effettivamente interrompersi per qualche motivo. Potrebbe essere un problema hardware, un problema del driver di rete o qualsiasi altra causa. Ogni volta che ciò accade, la chiamiamo interruzione della connessione.
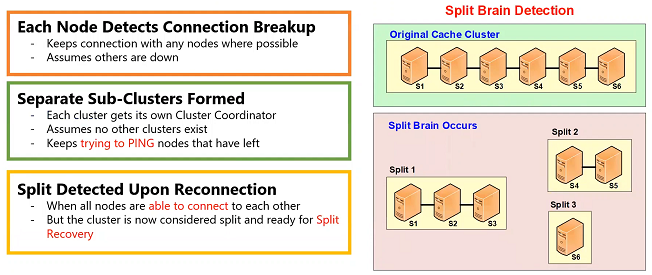
Sottogruppi separati formati
- Ogni cluster ha il suo coordinatore di cluster
- Presuppone che non esistano altri cluster
- mantiene cercando di fare PING nodi che hanno lasciato
Quindi, nell'architettura di clustering della cache, ogni nodo del cluster continua a rilevare se si è verificata un'interruzione della connessione, il che significa che, nonostante i tentativi, la connessione si è comunque interrotta. Ogni volta che una connessione si interrompe, ogni nodo presume che l'altro nodo sia morto. Quindi, continua a comunicare con tutti gli altri nodi. Ad esempio, se si dispone di un server qui, questo nodo sta comunicando con tutti e tre. Quindi, questo nodo potrebbe non funzionare. Quindi, questo nodo potrebbe essere in grado di comunicare con questi tre. Quando ciò accade, presumerà che questi tre siano ora un cluster di tre e che questo nodo se ne sia andato. Quindi, quando accade qualcosa del genere, diciamo, un cluster di sei nodi e farò solo l'esempio che le connessioni si interrompono in modo tale che tre di loro sono in grado di comunicare tra loro, questi due sono in grado di comunicare tra loro e questo non è in grado di comunicare con nessuno.
Quindi, quando ciò accade, quando questi nodi rilevano tutto ciò, tutti presumono che, ok, sono un cluster di tre perché sono in grado di comunicare con questi tre nodi e quando sono un cluster di tre, uno dei miei nodi diventerà un coordinatore del cluster, che potrebbe già essere un coordinatore del cluster perché è s1, che era probabilmente il più vecchio e continua a essere il coordinatore del cluster qui. Ma, in caso di split due, s4 diventa il nuovo coordinatore del cluster per questo cluster. E, per lo split tre, s3, essendo l'unico nodo, diventa anche lui il coordinatore. Ora, in questa situazione, questi nodi sanno che questi tre nodi sono in grado di comunicare con questi tre nodi. Quindi, dice ok, sono a posto, gli altri sono morti. Questo pensa la stessa cosa, sono a posto, gli altri sono morti. Questo pensa che sono a posto, gli altri sono morti.
Ma sanno anche che dovrei essere un cluster di sei nodi. Quindi, continuano a provare a fare ping a tutti gli altri nodi per vedere se torneranno attivi. E il ping avviene per un intervallo configurabile, dopo il quale si arrendono e danno per scontato che questi nodi siano definitivamente scomparsi e che io sia l'unico rimasto. Ma, entro quell'intervallo, se diciamo che la connessione di rete si ripristina e questi nodi sono ora visibili l'uno all'altro. Quindi, diciamo che tutti sono in grado di vedersi in questo esempio. Quindi, ora si rendono conto che abbiamo creato tre divisioni separate, ma siamo in grado di comunicare tra loro.
Split rilevato alla riconnessione
- Quando tutti i nodi sono in grado di connettersi a vicenda
- Ma il cluster è ora considerato diviso e pronto per Recupero diviso
Così, NCache rileverà formalmente una divisione. Anche se la divisione si è verificata nel momento in cui le connessioni si sono interrotte, NCache I nodi non sapevano che si trattava di una suddivisione perché pensavano di essere tutti morti. Tuttavia, se quei nodi tornavano entro l'intervallo specificato, i nodi della cache direbbero: "Ok, si è verificata una suddivisione ed è ora di eseguire un ripristino della suddivisione". Il motivo per cui ciò avviene è che l'applicazione necessita di un cluster di cache sano per continuare a funzionare e, sebbene la suddivisione non sia una situazione sana, se è possibile ripristinarla automaticamente, invece di dover richiedere al personale amministrativo di intervenire a orari strani del giorno, della notte o nei fine settimana, la vita diventa più semplice. NCache torna automaticamente a uno stato sano, un gruppo sano di sei. Ma come avviene?
La prima è che la divisione viene rilevata, come ho detto, solo quando la connessione viene ripristinata e i due dispositivi sono in grado di vedersi. Fino a quel momento, danno per scontato che gli altri siano morti. Ok? Ora che la divisione viene rilevata, entra in funzione il ripristino della divisione.
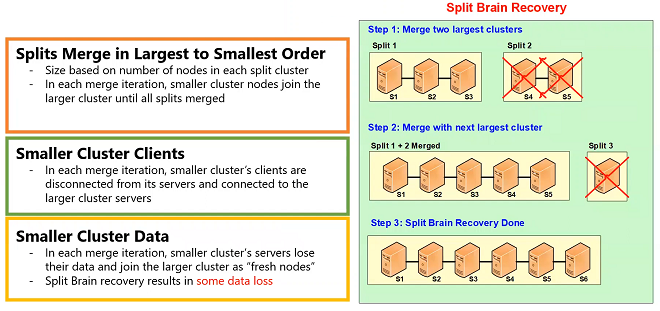
Recupero del cervello diviso
Le divisioni si uniscono nell'ordine dal più grande al più piccolo
- Dimensione basata sul numero di nodi in ogni cluster diviso
- In ogni iterazione di unione, i nodi del cluster più piccoli si uniscono al cluster più grande finché tutte le divisioni non vengono unite
Quindi, nel ripristino split, i due sottocluster più grandi o le due split più grandi vengono uniti per primi. E il cluster di questa split e il cluster di questa split si coordinano tra loro per dire "ok, dato che sono il più piccolo dei due, la dimensione qui si basa sul numero di nodi in ciascun cluster". Avrebbe potuto essere basato sulla quantità di dati. Avrebbe potuto essere basato sulla quantità di attività e sul numero di client, ma abbiamo scelto il numero di nodi perché era la situazione più probabile. Perché, nella maggior parte delle situazioni, ogni nodo ha praticamente la stessa quantità di dati a causa della distribuzione della mappa hash, perché ci sono mille bucket distribuiti uniformemente, perché c'è una funzionalità di bilanciamento dei dati in NCache che riequilibra i dati tra i nodi nel caso in cui si verifichi uno squilibrio.
Dati di cluster più piccoli
- In ogni iterazione di unione, i server del cluster più piccolo perdono i loro dati e si uniscono al cluster più grande come "nodi nuovi"
- Il recupero del cervello diviso si traduce in perdita di alcuni dati
Tutto ciò significa che la situazione più probabile è che ogni nodo abbia approssimativamente la stessa quantità di dati. Quindi, il maggior numero di nodi significa la maggiore quantità di dati. Quindi, questo diventa il master. E quest'altro nodo deve cedere i suoi dati e ricongiungersi a questo cluster come nuovi nodi. Quindi, la prima cosa che fa è cedere i suoi client, dice. Quindi, questi due server, questo coordinatore, dice all'altro nodo che ok, dobbiamo cedere i client e dice ai client di connettersi a questo cluster. Quindi, la prima cosa che succede è che i client si spostano nel nuovo cluster perché questo è sano, questo è il cluster master. Una volta che i client si sono spostati qui, questo cluster cede i suoi dati e in sostanza si riavvia. Anche se non si riavvia, cede semplicemente i suoi dati e si ricongiunge a questo cluster come nodo sano.
E ora, di conseguenza, si ottiene un cluster a cinque nodi che è una fusione dello split uno e dello split due. Quindi, una volta fatto questo, si passa allo split successivo più grande e lo si fonde con questo. Ora, nel nostro caso, avevamo solo tre split, ma se ne potrebbero avere più di tre e l'algoritmo prevede di iniziare con il più grande e di fonderlo con il successivo più grande, e poi con il successivo più grande e così via. Quindi, si eseguono tutte le iterazioni necessarie, ma in qualsiasi momento vengono unite solo due split. Quindi, mentre questi due split vengono uniti, il terzo split è considerato indipendente e continuerà a svolgere le sue operazioni finché lo split non viene unito, e ora questa unione avrà luogo.
E, se ci fosse una quarta suddivisione, questa verrebbe unita anche dopo questa. Quindi, in questo processo, tieni presente che, a seconda di quanti nodi hanno dovuto perdere o cedere i propri dati, si verificheranno delle perdite di dati. Quindi, ad esempio, in questo caso, tre nodi diventano master, gli altri tre perdono i propri dati. Anche in una topologia di replica partizionata, hai una sola replica per partizione. Quindi, perderai dati e questa è solo una parte di questa situazione. Tuttavia, l'altro aspetto di questa realtà è che, per quanto riguarda la memorizzazione nella cache dei dati, questi dati sono già in arrivo. Sono già presenti nel database. Quindi, non stai perdendo i dati, devi solo ricaricarli dal database. Puoi ricaricarli in base alle operazioni casuali della tua applicazione. Puoi anche ricaricarli in base alla lettura. Puoi anche ricaricarli in base alla funzione di aggiornamento della cache di NCache ma in entrambi i casi i dati non vengono persi.
Tuttavia, se i dati erano più simili a uno stato di sessione, ovvero a qualsiasi altro dato transitorio, che non esisteva in un archivio permanente, allora quei dati sono andati persi. Quindi, in tal caso, è necessario ricreare quelle sessioni. Tuttavia, nonostante ciò, la perdita di dati è comunque una situazione migliore perché, dopotutto, si è verificato un guasto di rete. Quindi, questo ha delle conseguenze.
Nella prossima versione di NCache, forniremo una funzionalità di persistenza che consentirà di mantenere la cache persistente. Una cache persistente significa che tutto ciò che era nella cache viene mantenuto al suo interno, NCacheil proprio archivio di persistenza e in questo modo in un ripristino split-brain, non perderai nemmeno i dati transitori, perché NCache ne conserva una copia in un archivio permanente. Ma ne parlerò quando questa funzionalità sarà resa pubblica. Quindi, per ora mi limiterò a parlarne.
Demo pratica
Spero di aver spiegato questa architettura. Ora vi darò una dimostrazione pratica di come potete farlo esattamente in NCacheQuindi, ho un esempio in cui ho cinque server cache e creerò una divisione tra questo e questo elenco.
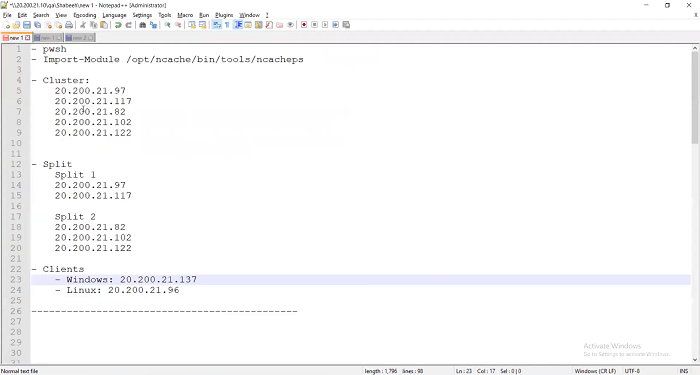
Creerò semplicemente queste due suddivisioni. La prima suddivisione conterrà questi due server cache e la seconda suddivisione conterrà questi due server cache. Ho un client Windows che userò, che è quello su cui mi trovo adesso, per la gestione e il monitoraggio. E ho un client Linux su cui ho due shelf aperti. Da lì posso avviare due applicazioni client separate. Quindi, ho questo cluster in esecuzione in questo momento. Non vi mostrerò come aggiungere questo cluster perché ci sono altri video che mostrano come farlo. Vi mostrerò solo la parte relativa alla suddivisione del cervello.
Monitorare lo stato di salute e le statistiche del cluster
Quindi, qui ho un cluster a cinque nodi. Ho un cluster a cinque nodi. Quindi, ho un cluster a cinque nodi che è proprio qui ed è in esecuzione. Bene, ora apro le statistiche e apro anche il suo monitor. Quindi, quello che ho fatto è stato aprire due diversi NCache Finestre di gestione. Una è connessa al .97 che è proprio qui, e una è connessa al .82 proprio qui. Quindi, questa è la .97 che ho il gestore vero e proprio. Ho il monitor e ho le statistiche. E la seconda è la .82 e lo farò di nuovo. È lo stesso cluster, ma sto solo comunicando con un server diverso per la gestione. Sto comunicando con questo server rispetto a questo, proprio qui. E, in questo, farò di nuovo le statistiche. Quindi, posso vedere l'attività. Al momento non c'è attività perché non ho ancora client in esecuzione. E aprirò anche il monitor.
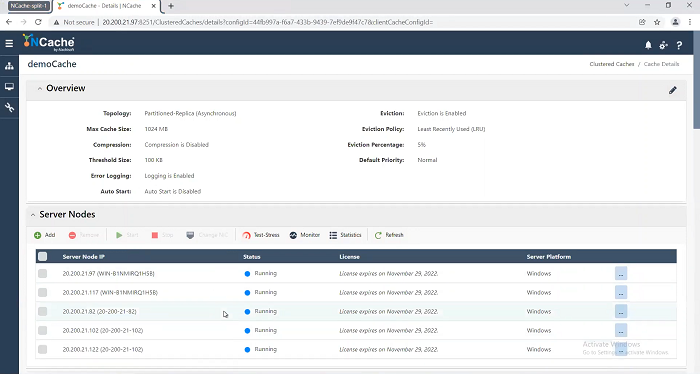
Allora, perché ne ho aperti due? Perché voglio monitorare, voglio connettermi a questo nodo e voglio connettermi a questo nodo. In modo che quando eseguo la suddivisione possa vedere. Perché, se sono connesso solo a questo quando avviene la suddivisione, mostrerà solo che ho solo due server rimasti e questi non saranno visibili. Quindi, voglio vedere la situazione da entrambe le prospettive. Perché introdurrò la suddivisione tramite una regola firewall, ovviamente, nel tuo caso non avrai la regola firewall. Ci sarà una sorta di interruzione di rete. Quindi, introdurrò o simulerò questo tramite una regola firewall. Quindi, ora sono connesso a questo nodo per la gestione e il monitoraggio e a questo nodo per la gestione e il monitoraggio. E ora vengo qui e... oh no, non ancora.
Utilizzerò anche questa riga di comando per chiamare Get-Caches-Server e qui parlerò con .82.
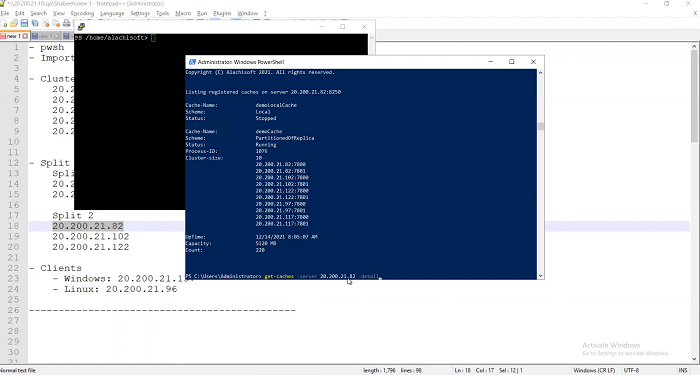
Parlerò con 82 e gli chiederò di fornirmi i dettagli di tutte le cache che hai. Quindi, .82 mi dice: "Ho una cache chiamata democache in cui ho cinque server: 82, 102, 122, 97 e 117". Un cluster di cinque server, perché al momento non c'è alcuna suddivisione.
Vado all'altro server, il 97.
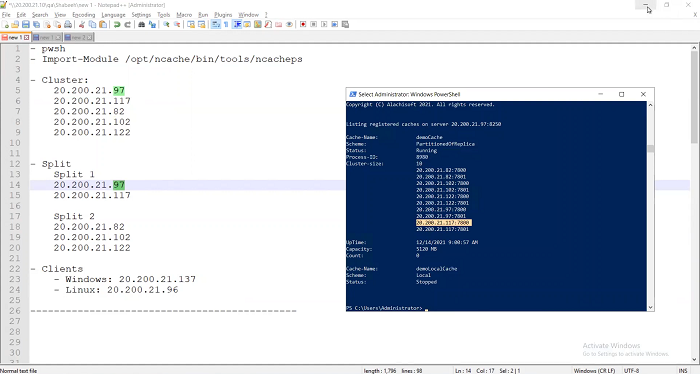
Gli chiederò la stessa cosa. Ho detto di darmi il tuo server. Mi risponde che ho una cache a cinque server: 82, 102, 122, 97 e 117, al momento. Quindi, è un cluster di cinque server, niente Split, tutto a posto.
Simula lo stress utilizzando il cmdlet Powershell Test-Stress
Tutto funziona bene. Ora avvio l'applicazione. Ho una finestra di PowerShell. In realtà, questa è una macchina Linux. Vi mostro cosa è successo. Forza! Riapro PowerShell. Mi scuso. Importerò solo questo modulo che è... NCache modulo di gestione. Devi farlo solo su Linux. Non devi importarlo su Windows. Poi dirò Test-Stress democache. Bene. Quindi, ora ho eseguito questo strumento. Farò lo stesso qui.
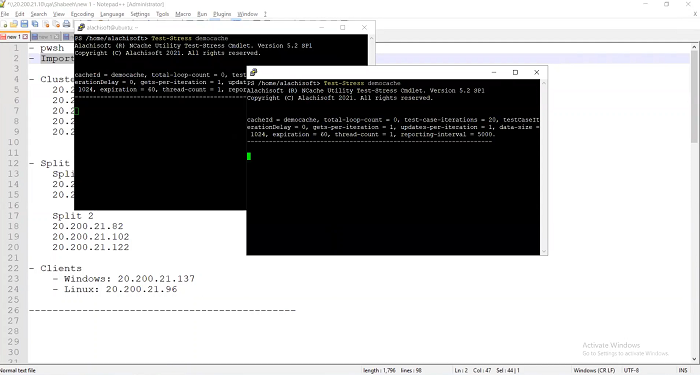
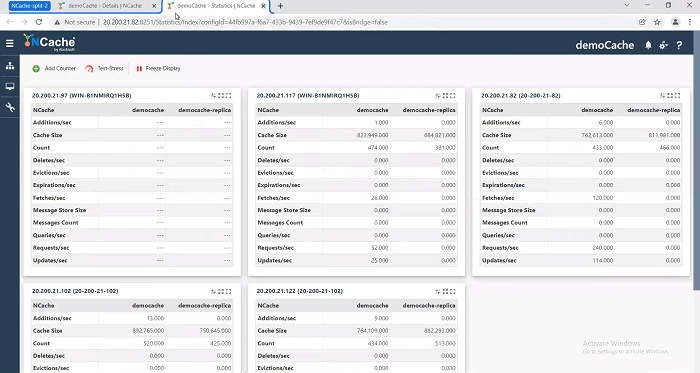
Dirò Test-Stress democache. Li ho entrambi. Ora guarda, c'è attività in corso. C'è attività su tutti e cinque i nodi, come puoi vedere qui, uno, due, tre, quattro, cinque. C'è attività su tutti e cinque i nodi. Proprio qui, posso vederlo. Anche qui. Ho cinque nodi. Parlo di nuovo di 97, questo è 97 ora.
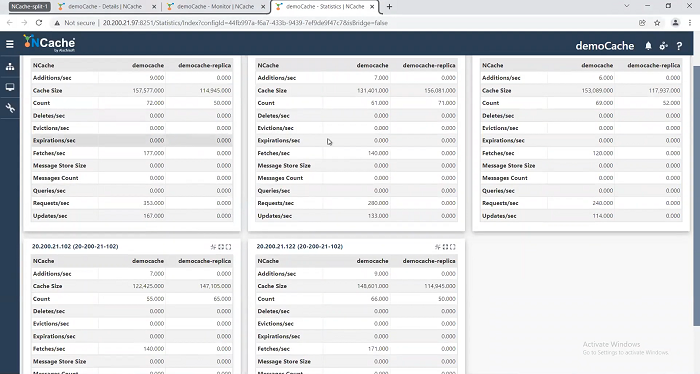
Vediamo se vedo lo stesso anche qui. Quindi, vado a .82 e vedo che ci sono cinque nodi attivi. Anche la finestra delle statistiche mostra l'attività.
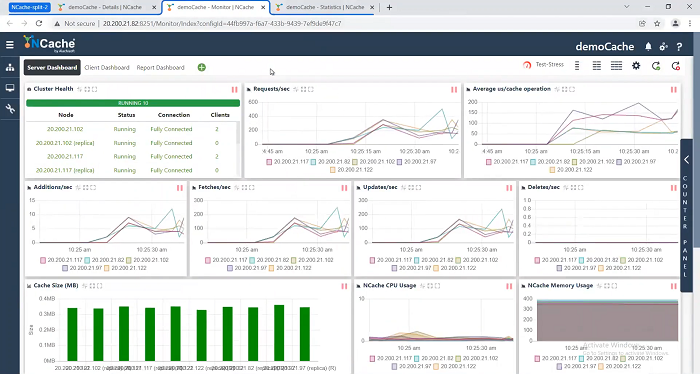
Bene! Quindi, tutto funziona correttamente. Normalmente, non aprirei questo e il monitor del gestore della cache su due server diversi. Il motivo per cui lo apro è perché devo mostrare la suddivisione e, quando avviene, devo mostrarvi cosa sta succedendo da entrambi i lati della suddivisione.
Indurre una disconnessione di rete
Bene! Ora che tutto è in funzione, passo alla presentazione. Quello che farò è usare la regola firewall su queste due caselle. Userò il firewall qui. Userò un firewall qui. Ho già impostato queste due regole. Quindi, effettuerò l'accesso. Ho effettuato l'accesso a 97 qui. Ho una regola qui. Andrò a, diciamo, ho una regola in entrata. È NCache, l'ho appena chiamato NCache Split-brain. Questa regola dice di bloccare la connessione su quali porte, dalla 78 alla 7900, quella è la cache.
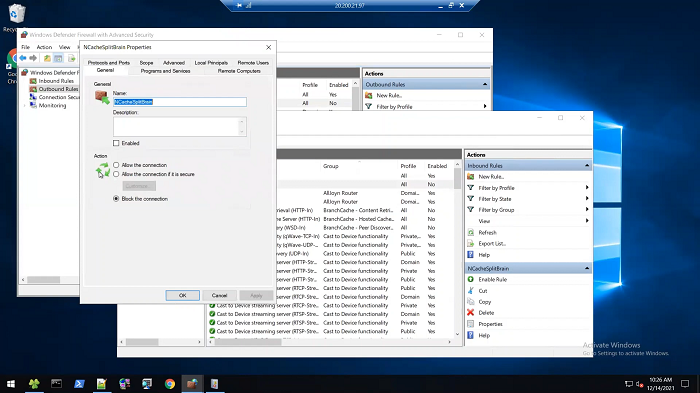
NCache Avvia un processo separato per ogni cache. Quindi, il processo di cache utilizza per impostazione predefinita le porte da 7800 a 7900. Sebbene sia configurabile, potresti utilizzare una porta diversa, nel qual caso dovrai bloccarla se vuoi simulare questo comportamento. La porta 8250 è la porta di gestione.
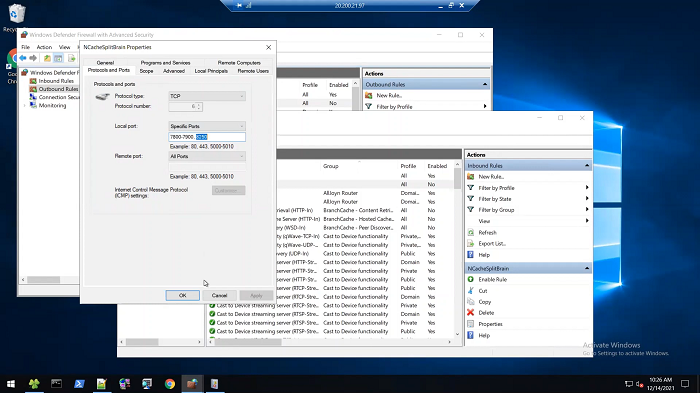
Scope dice di bloccare 82, 102, 122. Quindi, dico a questo, di bloccare l'accesso a queste tre caselle, questo è fondamentalmente ciò che dice.
Quindi, ho questa porta. Dirò "abilita regola" e ho la stessa porta per una regola in uscita. È una... Quindi, blocca il traffico in uscita. E ora andrò alla 117 e bloccherò anche quella. Andrò alla 117. Di nuovo, ho una regola in entrata proprio qui. Stessa cosa qui. Blocca connessione, porte, 78 79, ambito, tutte e tre queste caselle. Ok. Quindi, dirò "abilita regola". È abilitata. Andrò all'altra e dirò "abilita regola" proprio qui.
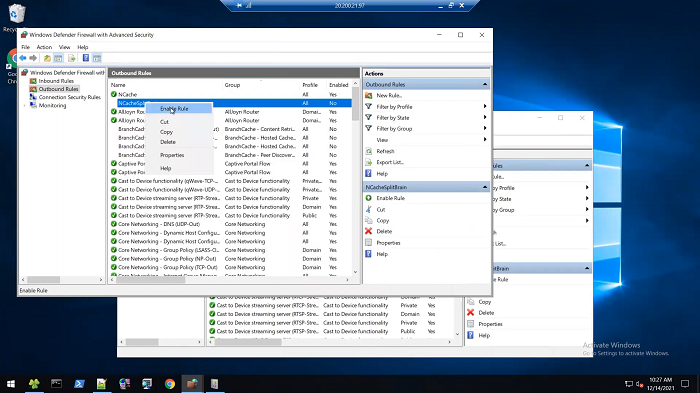
Bene, ecco cosa ho fatto: ho attivato il firewall su tutti questi.
Formazione di due sottogruppi
Quindi, ora la divisione inizierà ad avvenire. Anche se non avverrà immediatamente e posso vederlo perché chiederò prima a 82, che è questo, quanti server hai nella cache? Dice ok! Ne ho 82, 102, 122, 97, 117. Quindi, ha ancora tutti e cinque perché la divisione non è ancora avvenuta. Sta ancora esaminando i nuovi tentativi e tutto il resto. Chiederò all'altro, quanti server hai? Ne ha ancora uno, due, tre, quattro, cinque. Quindi, nessuna divisione è ancora avvenuta perché ci saranno ancora nuovi tentativi e timeout. Ma la divisione avverrà presto.
Ora vengo qui e vedo se inizia a vedere qualche arresto. Quindi, sto parlando di 97, 97 è il lato del cluster a due nodi.
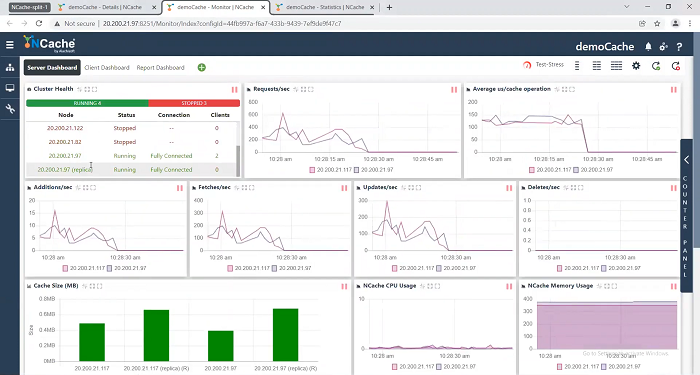
Quindi, 97 mi sta dicendo che sta vedendo solo... Quindi, non sta vedendo 102, 182, 82 dice che sono fermi ma 97 e 117 funzionano bene. Okay! Vediamo cosa mostra l'altro lato. L'altro lato dello split che era quest'altro lato. Quindi, stavo parlando con 97, ora parlerò con 82 come puoi vedere questo è l'82, proprio qui c'è l'82. Indirizzo IP... dice okay! Dice 102, 122. Quindi, dice che 122 è parzialmente connesso e 82 è completamente connesso.
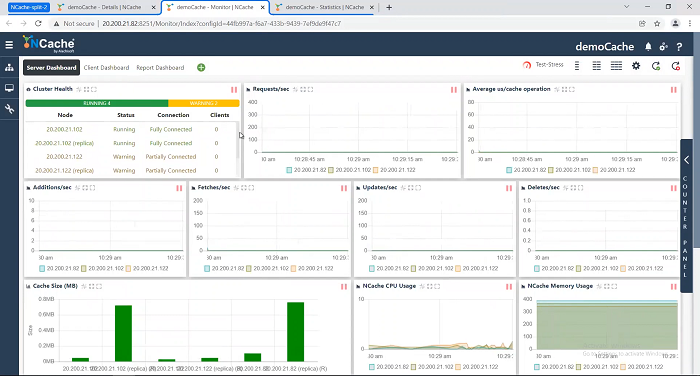
Sta ancora attraversando la fase di recupero. Sta ancora attraversando questa fase di tentativi in cui 122 non è in grado di comunicare con alcuni degli altri nodi, ma andrà avanti e quello che succederà è... vi mostrerò velocemente...
Quindi, c'è una funzionalità di cui vi ho parlato, che nel cluster: se c'è un nodo parzialmente connesso, rimuove quel nodo parzialmente connesso o parzialmente connesso dal cluster per creare un cluster sano. Quindi, quello che sta succedendo adesso è che sta rimuovendo quell'altro cluster, quell'altro nodo che è un nodo parzialmente connesso. Ora, torniamo qui e vediamo cosa dice la riga di comando. Sto parlando con 82 che, come ho detto, è il cluster a tre nodi. Quindi, dovrebbe... vediamo quanti ne ha? Ops, proprio qui, dice 82, ne ha uno, due, tre, quattro. Quindi, ne ha quattro. Non ne ha ancora cinque. Ne ha quattro. Sta ancora passando attraverso... rimuoverà forzatamente i nodi così come sono e ora andrò a 97, che è proprio qui, e chiederò: "Ok, quanti server hai?". E 97 ne ha solo due.
Quindi, 97 ha già stabilito il fatto di non poter vedere gli altri tre. Quindi, pensa "ok, sono l'unico ammasso qui". Non sa che c'è una divisione perché, come ho detto, la divisione è solo... NCache Riconosce una divisione solo quando questa connessione viene ripristinata. Quindi, al momento pensa solo che gli altri nodi siano morti. Quindi, dice ok, continuerò con questi due nodi. E, lasciami andare all'altro qui. Vediamo cosa ha. Oh, ok! Ora ne ha anche tre rimasti. Quindi, è passato e ha fatto anche questo. Ha rimosso il nodo parzialmente disconnesso per raggiungere ora un cluster sano. Ma è un cluster di soli tre nodi, giusto?
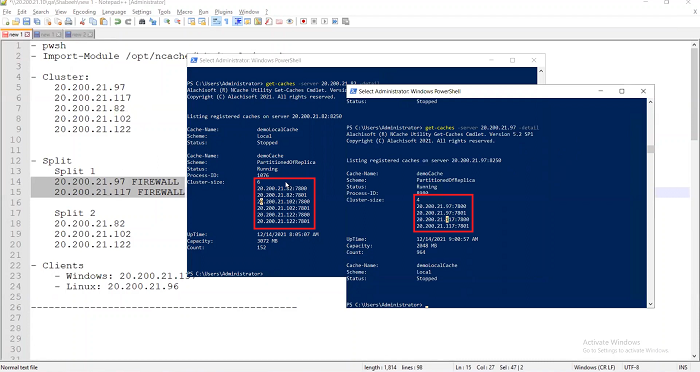
Quindi, ho parlato con il server .82 qui, che è proprio qui. Gli ho chiesto quanti server hai nella cache, ma ne dice solo tre. Ho chiesto al server 97 quanti server hai nella cache, ma ne dice solo due.
Bene! Quindi, si è verificata una suddivisione. Come parte della suddivisione, vedrai che finora l'applicazione non ha generato alcuna eccezione. Ciò significa che la suddivisione è avvenuta senza alcuna perdita di dati. Probabilmente l'applicazione non ha riscontrato alcuna eccezione, ma in alcuni casi si verificheranno delle eccezioni.
Rilevamento e ripristino dello split brain al ripristino della rete
Bene! Ora, il prossimo passo che farò è andare avanti e attivare lo split-brain. Quindi, voglio ripristinare la connessione in modo che lo split-brain venga rilevato e venga avviato un ripristino. Ma, prima di farlo, vi mostrerò che nella mia configurazione della cache, se vado alle impostazioni del cluster, che è il primo argomento qui, se vado fino in fondo, ho già abilitato il ripristino automatico per lo split-brain.
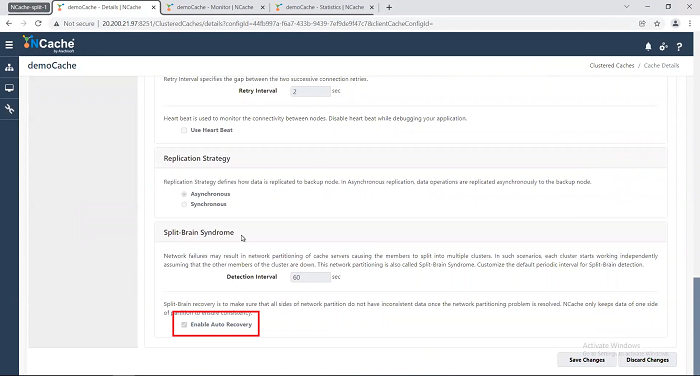
Quindi, se si abilita il ripristino automatico, ciò significa NCache si riprenderà automaticamente da uno split brain una volta che lo rileva. E, come ho detto, rileva lo split brain quando la connessione viene ripristinata.
Quindi, torniamo ora al 97 e disattiviamo questo firewall. E, per prima cosa, farò il 97. Andrò qui e dirò: "Disabilita questa regola". Andrò qui e dirò: "Disabilita questa regola".
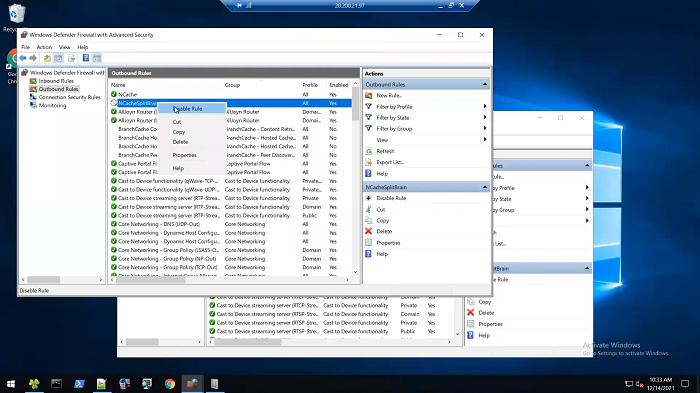
Okay! L'ho fatto, ora vado qui al 117 e dico: disabilitiamo anche la regola qui. Disabilitiamo la regola. Disabilitiamo la regola. Okay! Ora ho disabilitato le regole. Quindi, questo firewall è spento, il che significa che ora possono vedersi, o meglio, tra poco potranno vedersi. Non succederà all'istante, ma potranno vedersi. E, come potete vedere...
Quindi, torno di nuovo qui e dico "mostrami la tua cache". Di nuovo, tengo questo davanti a me e dico "certo, sto parlando con 82 in questo momento" e dico "mostrami le tue cache". 82 dice: "Ne ho 82, 102, 122". Quindi, finora ha ancora tre cache. Non vede le altre due. Vado all'altra e dico "mostrami le tue cache". Dice 97 e 117. Finora il recupero split-brain non si è attivato, ma lo farà. Lo farà perché ci vuole un po' di tempo prima che i nuovi tentativi si verifichino. Come puoi vedere qui, vedo già un due tre quattro cinque server. E qui un due tre quattro cinque server.
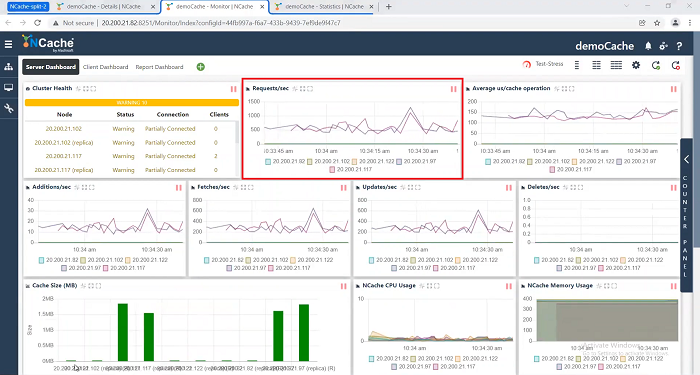
Ma, di nuovo, farò affidamento sul mio buon vecchio strumento PowerShell da riga di comando per dirmelo. Farò quella chiamata "get caches". Parlerò con 82 e dirò "mostrami quanti server hai". Ha ancora uno, due, tre. E, dico "mostrami quanti server hai proprio qui". Ha ancora uno, due. Quindi, di nuovo, uno, due e uno, due, tre. Quindi, non c'è stata alcuna connessione. Quindi, lo split-brain non è stato ancora recuperato. Ed è per questo che sarà ancora parzialmente connesso, parzialmente connesso, e i client continuano a funzionare.
Ok! Lasciami andare di nuovo. Facciamone un altro. Non è ancora finito. Ok! Vai qui. 97... Dai! Ok! Ora, sta iniziando a vedere l'altro nodo. 82, 102, 122 e anche 97 proprio qui. Ma è ancora parziale. Deve vederne due e dovresti vedere sia la partizione che la replica ed è per questo che probabilmente non è ancora in grado di comunicare con 97 perché... Ok! Ora, 82, 102, 122, 97, di nuovo cinque nodi sono ripristinati qui. Tutti e cinque.
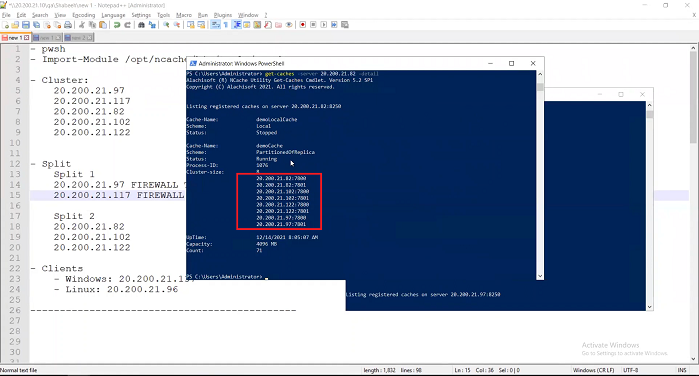
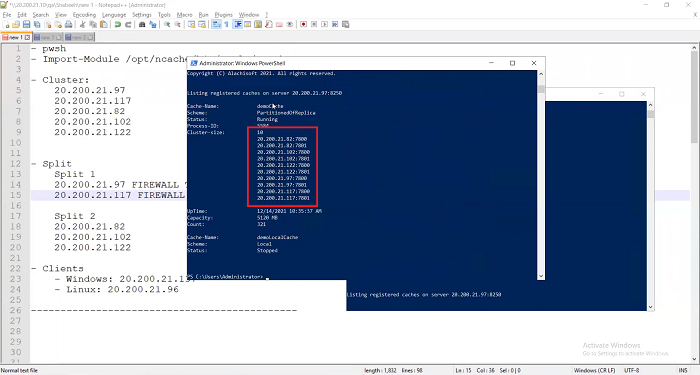
Fammi andare a questo. Questo. In qualche modo... Dai! Lo cambierò qui. Quindi, invece di 82 dirò 97 qui. Ora fallo. Vedrò che anche 97 mi mostra cinque nodi, uno due tre quattro cinque. Okay. Quindi, tutti e cinque i nodi sono ricollegati.
Ora vengo qui. Lasciatemi riavviare questo monitor. Torno qui di nuovo. Questa cache, dirò statistiche. Vedo che tutti e cinque funzionano e i client stanno comunicando con loro. Quindi, ancora una volta, il fatto che il client stia comunicando con tutti e cinque significa che anche le connessioni client vengono ripristinate automaticamente. E il monitor mi mostrerà anche tutti e cinque qui. Quindi, come potete vedere, tutti e cinque i nodi sono completamente connessi.
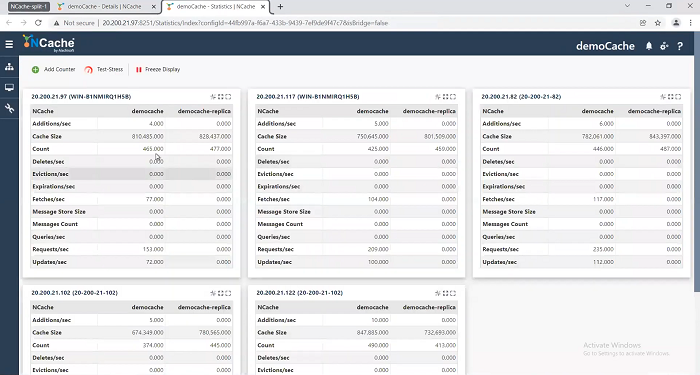
Ok! Ora passiamo all'altro Uno. Sono andato all'altro? Questo. Ok! Dirò ok, statistiche. Tutti e cinque... sto parlando di tutti e cinque qui, come puoi vedere, l'attività si sta verificando su tutti e cinque e dirò di monitorare ciò che sta accadendo qui.
Conclusione
Quindi, siamo passati da un cluster sano a uno split e poi di nuovo a un cluster sano. E possiamo vedere anche qui che abbiamo un cluster a cinque nodi. Quindi, questa è praticamente la fine di questa demo. Continuate a giocare con NCache e vedere che con il recupero split-brain si ottiene questa capacità aggiuntiva di elevata disponibilità.