NCache Architettura
Oggi parlerò di NCache Architettura. NCache è un archivio distribuito in memoria per applicazioni .NET e Java. È estremamente veloce e scalabile. Inoltre, puoi utilizzarlo nelle tue applicazioni server ad alte transazioni per migliorare le prestazioni e la scalabilità delle tue applicazioni.
Usi comuni di NCache
Cache distribuita
I due modi comuni NCache viene utilizzato. Il numero uno è come un Cache distribuita dove memorizzi nella cache i dati dell'applicazione per ridurre quei costosi viaggi nel database e, il numero due è un Messaggistica e flussi piattaforma. Esaminerò brevemente entrambi i punti prima di passare all'architettura.
-
Memorizzazione nella cache dei dati dell'app
Quindi, nella cache distribuita, la memorizzazione nella cache dei dati dell'applicazione significa che si utilizza un NCache L'API di solito memorizza semplicemente nella cache i dati dell'applicazione, quindi non è necessario accedere al database con la stessa frequenza, perché la cache è molto più veloce del database stesso. È anche più scalabile perché è in memoria, quindi è veloce. È vicina all'applicazione, quindi è veloce, ed è distribuita, quindi è scalabile. E, se hai un'applicazione .NET e stai utilizzando EF Core, puoi usare NCache anche tramite EF Core e anche NHibernate ed EF 6. Se hai applicazioni Java puoi usare NCache come cache di secondo livello Hibernate. Puoi anche usarla come cache Spring o programmarla per JCache. -
Memorizzazione nella cache dell'app Web
La seconda parte dell'utilizzo della cache distribuita è, se si dispone di applicazioni Web, che è possibile memorizzare le proprie sessioni in NCache poi NCache replica queste sessioni su più server, in modo che se ce n'è uno NCache server che si blocca senza che tu perda dati ma queste sessioni sono molto scalabili perché è un archivio distribuito ed è ovviamente super veloce. È disponibile anche la funzionalità di sessione multi-sito in tutti i linguaggi .NET, Java, Nodejs, ecc. Oltre alle sessioni, ad esempio, per .NET 6, le applicazioni ASP.NET Core possono memorizzare le loro Cache di risposta in NCache e possono anche usare NCache la backplane per SignalRSignalR è pensato per applicazioni web live in cui l'applicazione web deve inviare eventi ai client. Inoltre, se si utilizza .NET 4.8, è anche possibile memorizzare lo stato della sessione. Visualizza stato, Cache di outpute anche SignalR.
NCache per applicazioni mission critical
Lascia che ti mostri rapidamente cosa NCache Assomiglia. Ecco di cosa si tratta come cache distribuita per applicazioni mission critical. Uso la parola mission critical perché nella maggior parte dei casi vediamo che i clienti usano NCache in applicazioni molto sensibili che sono rivolte al cliente e sono molto importanti per il loro business. Quindi, NCache è, sai, parte della tua infrastruttura molto critica in quel caso.

E, come ho detto, si tratta di applicazioni server ad alto volume di transazioni. Si tratta di applicazioni web. Si tratta di microservizi, API web o altre applicazioni server. Ovviamente, è possibile utilizzare .NET, Java, Node.js o Python. Queste applicazioni tentano di accedere al database, che sia un SQL Server, Oracle, Db2, MySQL o qualsiasi altro database relazionale, oppure accedono ai dati del mainframe legacy o magari utilizzano un database NoSQL come MongoDB, Cosmos DB, Cassandra o altri. In questa situazione, NCache diventa una cache distribuita da... si usa NCache come due o più server come livello di caching separato, anche se non è necessario disporre di un livello di caching separato, l'applicazione può essere eseguita nella stessa casella come NCache e funziona perfettamente, ma l'architettura di distribuzione più diffusa è quella di avere un livello di memorizzazione nella cache separato, che è semplicemente un modo più pulito di utilizzare NCache.
Quindi, diciamo che si inizia con un cluster di cache a 2 server, NCache grappolo, NCache raggruppa la memoria, la CPU e le risorse della scheda di rete di tutti questi server in un'unica capacità logica e, diciamo, stai caricando più transazioni attraverso le tue applicazioni su NCache e questi due server sono al massimo, puoi facilmente aggiungere un terzo server, o un quarto server, o un quinto server e così via, NCache non diventa mai un collo di bottiglia. Questa è una cosa che non puoi fare con i tuoi database. I database non sono scalabili. NoSQL è scalabile, ma nella maggior parte dei casi abbiamo scoperto che le persone devono usare database relazionali per una serie di motivi aziendali e hanno anche mainframe legacy. Quindi, poiché il livello di archiviazione dei dati non è scalabile NCache aiuta la scalabilità della tua applicazione consentendoti di memorizzare nella cache quanti più dati possibile. L'obiettivo generale è di avere circa l'80% del tempo in cui dovresti trovare i dati da NCache piuttosto che utilizzare il database. Se riesci a raggiungere questo rapporto, allora hai alleggerito la pressione sui database e la tua applicazione sarà scalabile.
Messaggistica e flussi
Il secondo caso d'uso comune, o utilizzo di NCache è utilizzarlo come piattaforma di messaggistica e flussi in cui è possibile avere più applicazioni che possono comunicare tra loro tramite Messaggistica Pub/Sub, attraverso Interrogazione continua, o NCache Eventi basati su. Lascia che ti mostri come funziona. Quindi, ad esempio, se hai un'applicazione server ad alto traffico che deve gestire molta messaggistica in tempo reale o elaborazione di flussi, puoi usare NCache. Ora lo stesso NCache Quella che era una cache distribuita ora diventa una piattaforma di messaggistica e streaming. Ancora una volta, si tratta di un archivio distribuito in memoria. È scalabile in modo lineare. Replica i messaggi su più server. Infatti, NCache contiene anche la Persistenza.

Quindi, con questo, si possono avere diverse applicazioni, ad esempio, la messaggistica Pub/Sub è un metodo molto diffuso, è una metodologia, un paradigma in cui più editori e più abbonati possono comunicare tra loro in modo disaccoppiato. Disaccoppiato significa che l'editore non sa chi è l'abbonato, pubblica semplicemente messaggi su determinati argomenti e questi abbonati possono riceverli. Le query continue funzionano allo stesso modo. Quindi, questi sono i due metodi più comuni. NCache viene utilizzato.
.NET e applicazioni Java
Ora parliamo di come NCache gestisce le applicazioni .NET rispetto a quelle Java. NCache ha una capacità multipiattaforma nativa davvero unica che troverai molto interessante, lascia che ti spieghi meglio.
Edizione .NET
NCache Cerca di fornirti una soluzione nativa sia per .NET che per Java. Con questo intendo dire che quando hai un'applicazione .NET, l'intero stack applicativo utilizza .NET, non stai usando altro che .NET. Quindi, ad esempio, NCache ha un client .NET nativo che è quello che la tua applicazione utilizzerà sulla tua applicazione. Questo viene eseguito sul tuo server applicativo e NCache ha sviluppato questo in 'C Sharp' (C#), al 100%.
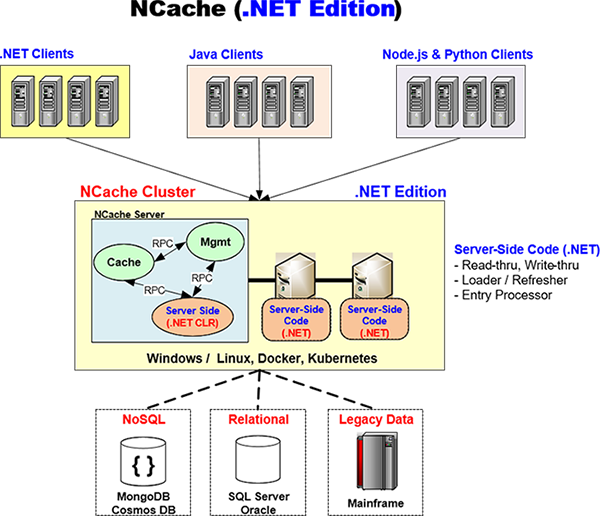
Allo stesso modo, se hai codice lato server come Read-through, Write-through, Right-behind, Loader/Refresher che hai scritto in .NET, NCache eseguirà quel codice nel suo processo .NET CLR. Lasciate che vi mostri come. E tornerò su questo diagramma più e più volte. Quindi, ad esempio, ecco un NCache architettura, qui hai un'applicazione .NET che potrebbe essere in esecuzione su Windows o Linux. Ha un'architettura nativa NCache Client .NET. E questo sta parlando con un NCache cluster che è un'edizione .NET NCache Cluster. Ciò significa che anche il codice lato server è .NET.
Adesso la strada NCache è progettato e, questo è il motivo per cui ciò che lo rende davvero potente per il supporto nativo multipiattaforma è che c'è un processo di cache, c'è un processo di gestione, entrambi separati dal processo di codice lato server. E c'è una RPC ad altissime prestazioni. È una RPC in memoria che NCache usa, quello NCache ha sviluppato un proprio RPC proprietario, estremamente veloce. Ecco come la cache interagisce con il codice lato server. Ad esempio, se deve chiamare il Read-through Handler, quest'ultimo verrà eseguito all'interno di questo processo CLR .NET per accedere al database, recuperare i dati e poi passarli alla cache. Lo stesso vale per Write-through, Loader e Refresher. Quindi, l'intera esperienza della tua applicazione è .NET.
Edizione Java
Bene, passiamo al lato Java. Di nuovo, allo stesso modo, abbiamo un codice Java lato server. NCache ha un client Java al 100% che gira sul tuo server applicativo, esattamente come .NET. Ecco la Java Edition. Supponiamo di avere un'applicazione Java che molto probabilmente gira su Linux, o forse anche su Windows, forse su Docker, forse su Kubernetes. Quindi, quell'applicazione incorporerà NCache Java Client che, come ho detto qui, è Java nativo al 100%, e poi questo Java Client è identico al .NET Client. Comunica anche con NCache Cluster nello stesso modo in cui lo fa il client .NET utilizzando NCacheil protocollo socket proprietario e il NCache il server è progettato in modo che il codice Java lato server venga eseguito sulla propria JVM.
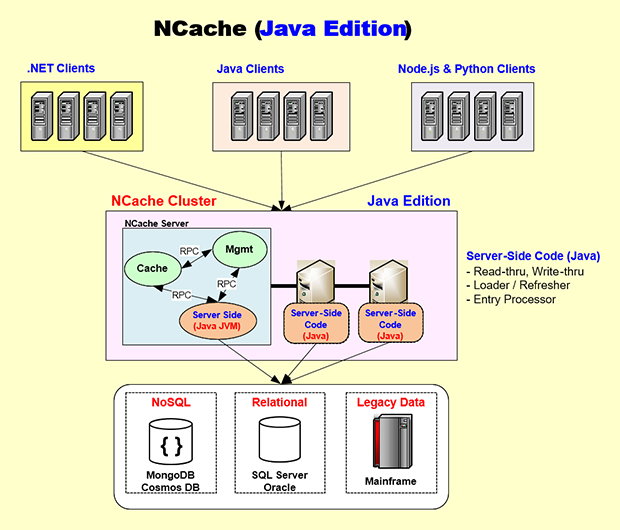
Quindi, tutto lo sviluppo, i test e il debug che farete saranno tutti in processi JVM nativi. E questo processo di cache chiamerà, ad esempio, il gestore Read-through che accederà, ad esempio, a Oracle o DB2, o persino a un database SQL Server, e otterrà i dati e li passerà al processo di cache. Anche in questo caso, viene utilizzata la stessa RPC in memoria ad alte prestazioni. Quindi, avendo un'architettura che incapsula il codice .NET e Java nei loro processi nativi, NCache è in grado di fornirti uno stack nativo sia per Java che per .NET.
E, ancora una volta, nel caso di un'applicazione Java, potresti voler sviluppare su Windows o Mac OS e NCache lo supporta completamente, o anche Linux e, quindi, è più probabile che tu usi Docker e Kubernetes, rispetto alla gente di .NET NCache Fornisce le immagini Docker e il supporto completo per Kubernetes, Azure AKS, AWS EKS, Google GKE o Red Hat OpenShift. È possibile utilizzarlo in modo estremamente semplice.
Così, NCache è davvero unico. Offre un'esperienza .NET nativa e allo stesso tempo un'esperienza Java nativa. Quindi, se sei un negozio Java non hai la sensazione di utilizzare un prodotto non Java, e se sei un negozio .NET non hai la sensazione di utilizzare un prodotto non .NET. Questa è la bellezza di NCache il modo in cui è progettato.
Cluster dinamico
Architettura peer-to-peer (auto-riparazione)
- Nessun singolo punto di errore (nessun master/slave)
- Coordinatore del cluster nodo più vecchio, il successivo più vecchio è il successore automatico
Ok, ora entriamo nel vivo Clustering dinamico parte NCache Architettura che garantisce l'alta disponibilità. E, un attimo, ok. Quindi, la prima parte è il cluster dinamico. Quando uso la parola cluster non mi riferisco al cluster Kubernetes, o a qualsiasi altro cluster a livello di sistema operativo. Questo è NCacheIl cluster basato su TCP di . E questo cluster ha un'architettura peer-to-peer. Peer-to-peer significa che non c'è né master né slave. Il problema del master/slave è che se il master si blocca, lo slave diventa inoperativo o subisce limitazioni, mentre in un'architettura peer-to-peer ogni nodo ha le stesse capacità. Ovviamente c'è un nodo coordinatore del cluster, che è il nodo più vecchio e, se quel nodo si blocca, il successivo più vecchio viene automaticamente selezionato come coordinatore del cluster. Il coordinatore del cluster gestisce l'appartenenza al cluster. Gestisce la mappa di distribuzione, lo stato del cluster e un sacco di altre cose che spiegherò più avanti.
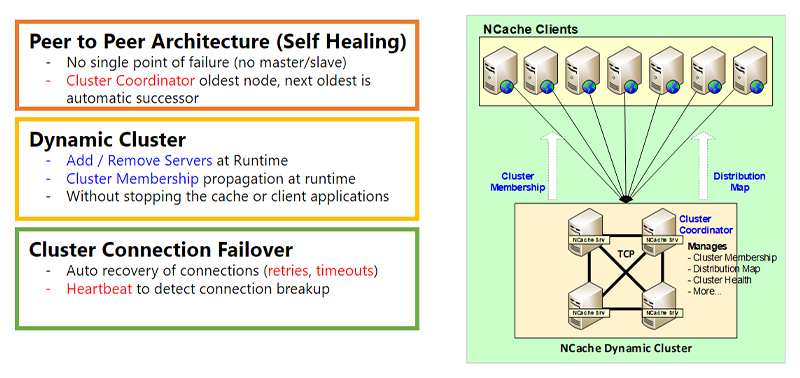
Cluster dinamico
- Aggiungi / Rimuovi server in fase di esecuzione
- Appartenenza al cluster propagazione in fase di esecuzione
- Senza arrestare la cache o le applicazioni client
Il clustering dinamico consente di aggiungere o rimuovere server dal cluster in fase di esecuzione senza arrestare la cache o l'applicazione. Non si verifica alcuna interruzione. E, ad esempio, quando si aggiunge un nuovo server al cluster, l'appartenenza al cluster viene ovviamente aggiornata in fase di esecuzione e le informazioni di runtime vengono quindi propagate ai client. Ne parlerò più approfonditamente nella prossima diapositiva.
Failover della connessione del cluster
- Ripristino automatico delle connessioni (riprova, timeout)
- Battito cardiaco per rilevare l'interruzione della connessione
Esiste anche una funzionalità di failover della connessione cluster. Quindi, poiché si tratta di socket, sebbene i server del cluster si trovino solitamente nella stessa subnet, abbastanza vicini tra loro, potrebbe non essere sempre così. Abbiamo clienti che hanno server distribuiti anche in regioni diverse e funziona perfettamente, anche se nella maggior parte dei casi consigliamo... NCache I server dovrebbero essere abbastanza vicini tra loro. Tuttavia, potrebbe comunque verificarsi un errore di connessione. In tal caso, NCache ha una logica di ripetizione dei tentativi e ci sono dei timeout. C'è una logica di heartbeat, tutto questo per garantire che sia tutto dinamico.
Client dinamici e configurazione dinamica
Connessioni client dinamiche
- Aggiungi/Rimuovi client in fase di esecuzione
- Senza fermarsi la cache o le applicazioni client
L'altra parte dell'architettura dinamica sono i client dinamici. Quindi, proprio come in questo caso, il cluster aveva la possibilità di aggiungere o rimuovere server in fase di esecuzione, e anche di aggiungere o rimuovere client in fase di esecuzione. Cosa significa client? Un client è... NCache Il client che gira sul tuo server applicativo, il tuo server web, è la parte con cui la tua applicazione comunica. Quindi, puoi aggiungere un client in fase di esecuzione e rimuoverlo senza fermarti. NCache, la cache o l'applicazione senza alcuna interruzione. Questa è la prima parte.
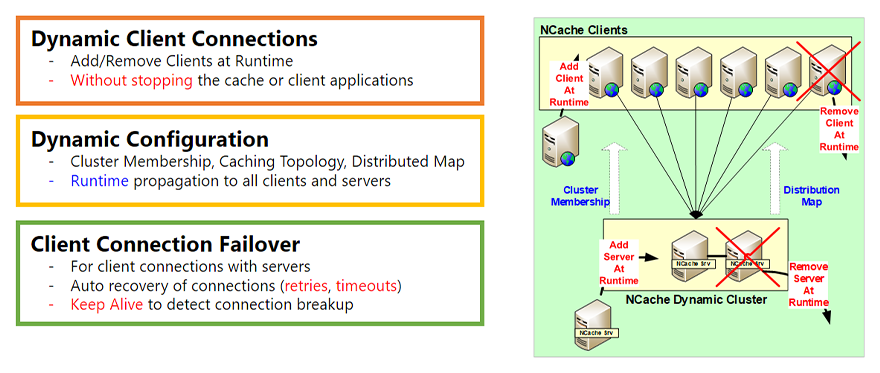
Configurazione dinamica
- Appartenenza al cluster, topologia di memorizzazione nella cache, mappa distribuita
- Runtime propagazione a tutti i client e server
La seconda parte è la Configurazione Dinamica. Quindi, come ho accennato nell'ultima diapositiva, quando si aggiunge un server al cluster, l'appartenenza al cluster cambia. Bene, questo viene propagato a tutti i client esistenti connessi, in modo che sappiano che c'è un nuovo server a cui devono connettersi. Quindi, se scelgono di farlo in base alla topologia di caching, possono connettersi anche a quel server. Inoltre, a seconda della topologia, potrebbe esserci una Mappa di Distribuzione. Una Mappa di Distribuzione è più adatta alla Cache Partizionata e alla Cache Replica Partizionata. Tuttavia, quando si aggiunge un server, questo viene aggiornato e questo viene propagato in fase di esecuzione. E ci sono anche molte altre modifiche di configurazione. C'è una funzionalità di applicazione a caldo che è possibile eseguire e che viene propagata in fase di esecuzione. Quindi, questa è la seconda parte.
Failover della connessione client
- Per le connessioni client con i server
- Ripristino automatico delle connessioni (riprova, timeout)
- Keep Alive per rilevare l'interruzione della connessione
La terza parte è che, ancora una volta, c'è un failover della connessione client, che funziona allo stesso modo del failover della connessione cluster. Ma in realtà è ancora più necessario perché i client probabilmente non saranno sempre molto vicini ai server del cluster. E potrebbero esserci router o firewall tra di loro. Quindi, la connessione tra i client e il cluster ha maggiori probabilità di interrompersi. Quindi, NCache ha una capacità di ripetizione abbastanza intelligente, timeout. C'è anche la capacità di mantenere attivo, in modo che il client rimanga connesso anche se la connessione si interrompe, il client si riconnette al NCache Grappolo.
Rilevamento e recupero del cervello diviso
Un altro argomento importante dell'aspetto dinamico di NCache L'architettura è il cervello diviso. Il cervello diviso è un fenomeno che può verificarsi nel cluster.
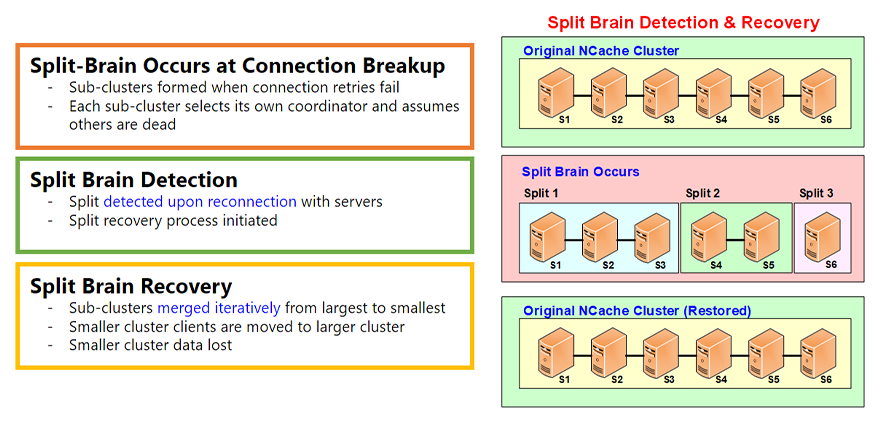
Lo split-brain si verifica quando si interrompe la connessione
- Sottocluster formati quando i tentativi di connessione falliscono
- Ogni sotto-cluster seleziona il proprio coordinatore e presume che gli altri siano morti
E lo Split Brain si verifica ogni volta che, diciamo, se si dispone di un cluster sano di sei server, si verifica uno split brain quando la connessione tra alcuni di questi server si interrompe per qualche motivo e, ogni volta che si hanno connessioni di rete, queste possono interrompersi. E lo vediamo continuamente. Quindi, quando ciò accade, si formano dei sottocluster. Diciamo che, in questo caso, c'è uno Split 1, uno Split 2, uno Split 3. Ogni sottocluster pensa di essere il sopravvissuto. Quindi, crea il proprio coordinatore di cluster e diventa un cluster indipendente.
Rilevamento del cervello diviso
- Diviso rilevato alla riconnessione con i server
- Avviato il processo di recupero diviso
Tuttavia, tutte queste divisioni ricordano che facevano parte di un cluster sano e questi server non se ne sono andati volontariamente, non se ne sono andati in modo fluido. Non hai eseguito un "leave node" dal NCache Management Tool, invece, ha interrotto la connessione. Quindi, continueranno a cercare questi server per vedere se la connessione di rete è stata ripristinata. E, il più delle volte, forse cinque, dieci minuti, mezz'ora, un'ora dopo, la connessione sarà probabilmente ripristinata.
Recupero del cervello diviso
- Sotto-cluster uniti iterativamente dal più grande al più piccolo
- I client del cluster più piccolo vengono spostati in un cluster più grande
- Dati di cluster più piccoli persi
Quando ciò accade, si verifica uno Split Brain Recovery. Ed è lì che queste divisioni vengono unite. Questi sottocluster vengono uniti in modo iterativo dal più grande al più piccolo, e ovviamente si verifica una perdita di dati perché questi sono diventati cluster indipendenti e ora alcuni dati devono essere persi. Ma tutto viene fatto automaticamente in base alle regole specificate.
Ci sono maggiori dettagli sul cervello diviso in un articolo separato video ma questo tipo di ti dà una panoramica. È una caratteristica molto importante che assicura che il tuo NCache Il cluster rimane sano e può riprendersi ogni volta che si verifica una scissione cerebrale.
Topologie di memorizzazione nella cache
Ok, ora passiamo a Topologie di memorizzazione nella cacheLe topologie di caching riguardano essenzialmente l'archiviazione dei dati, le strategie di replica e anche le strategie di connessione client. Esistono quattro topologie: cache partizionata, replica di partizioni, cache replicata e cache con mirroring. Prendiamo in considerazione la cache partizionata.
Cache partizionata
- Cache divisa in partizioni in fase di esecuzione
- Una partizione per server cache. 100 bucket per l'intero cluster di cache distribuiti uniformemente
- L'aggiunta/rimozione del server crea/elimina la partizione
Cache partizionata In pratica, l'intera cache è suddivisa in partizioni, ogni server ne ha una. E c'è il concetto di bucket. Quindi, ogni partizione ha dei bucket. Un totale di 100 bucket per l'intera cache. Quindi, a seconda del numero di partizioni presenti, questi bucket sono equamente suddivisi tra loro.
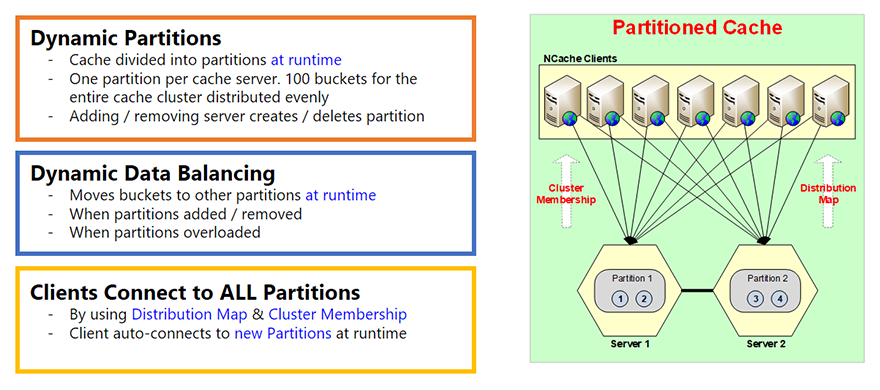
Queste partizioni vengono create in fase di esecuzione, e questa è la parte importante. Quindi, quando si aggiunge un server, viene creata una partizione. Supponiamo di iniziare con un server, c'è una sola partizione, tutti i 100 bucket si trovano in quella partizione. Se si aggiunge un secondo server in fase di esecuzione, non solo vengono aggiornate le informazioni di appartenenza al cluster, come ho menzionato nelle diapositive precedenti, ma viene aggiornata anche la mappa di distribuzione. Una mappa di distribuzione è essenzialmente una mappa che indica quale partizione contiene quali bucket. Quindi, supponiamo che si aggiunga una seconda partizione, la mappa di distribuzione verrà modificata. Una mappa di distribuzione è in realtà una mappa hash che mappa i bucket. Il valore della mappa hash varia in base ai bucket. E questo non cambia in base alla quantità di dati aggiunti, cambia solo quando si modifica il numero di server, il numero di partizioni o si esegue il ribilanciamento dei dati. Quindi, le partizioni sono dinamiche.
Bilanciamento dinamico dei dati
- Sposta i bucket in altre partizioni in fase di esecuzione
- Quando le partizioni vengono aggiunte/rimosse
- Quando le partizioni sono sovraccariche
La seconda parte riguarda il bilanciamento dinamico dei dati. Quindi, poiché tutto questo è basato su hash map, è molto probabile che, a seconda del tipo di chiavi utilizzate, alcuni bucket ricevano più dati di altri. E, alla fine, alcune partizioni saranno quasi piene e altre quasi vuote. E, quando ciò accade, NCache Dispone di questa funzionalità che consente di impostare una soglia. Supponiamo che, se una partizione si riempie per più dell'80%, ne venga rimosso il 20%, il 10% o il 5%. Non "rimuovere", intendo "bilanciare dinamicamente". Quindi, il bilanciamento dei dati significa prelevare i bucket dalla partizione 1 e copiarli in un'altra, oppure spostarli in altre partizioni. Il bilanciamento dei dati garantisce che i dati e tutte le partizioni siano equamente uniformi.
Il client si connette a tutte le partizioni
- Utilizzando Mappa di distribuzione & Appartenenza al cluster
- Il client si connette automaticamente a nuove partizioni in fase di esecuzione
Nella cache partizionata, ogni client si connette a tutte le partizioni o a tutti i server. Il motivo è che desidera accedere direttamente a qualsiasi elemento desideri in un'unica chiamata. Se fosse connesso a un solo server, ad esempio, e volesse l'elemento numero 3, parlerebbe con il server 1, il server 1 si recherebbe al server 2 e lo otterrebbe. Si tratta di un'operazione a due hop, non ottimizzata come se il client potesse accedere direttamente alla posizione dei dati. Il client lo sa grazie a una mappa di distribuzione. Ecco perché la mappa di distribuzione viene creata per aiutare i client a sapere dove si trovano i dati, in modo che possano accedervi direttamente.
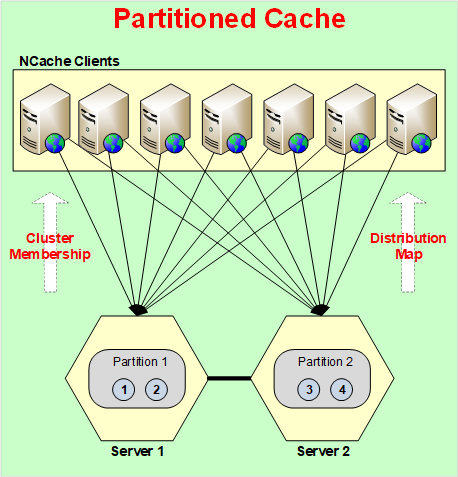
Quindi, la cache partizionata non ha replica. Quindi, se un server si blocca, si perdono i dati. Non c'è modo di farlo, a meno che non si utilizzi la "Persistenza", di cui parlerò tra poco. In questo caso, anche la cache partizionata non perde alcun dato.
Cache di replica partizione
Repliche di partizioni (dinamiche)
- Creato in fase di esecuzione quando le partizioni vengono aggiunte/rimosse
- Situato su un server diverso rispetto alla partizione
- Nessun cliente parla con loroI clienti comunicano con le partizioni.
Le partizioni comunicano/si replicano con le repliche.
La topologia successiva è la cache partizione-replica. Questa è la nostra topologia più popolare, tra l'altro, perché offre il meglio di entrambi i mondi. Offre il partizionamento, ovvero la scalabilità. E offre anche la replica, ovvero l'alta disponibilità. Quindi, non c'è perdita di dati. Ad esempio, è lo stesso della cache partizionata: tutto è uguale, ma ogni partizione ora ha una replica su un server diverso. Quindi, la partizione uno si trova sul Server 1, quindi la sua replica si chiama Replica 1, che in questo caso si trova sul Server 2. Quindi, proprio come le partizioni sono state create dinamicamente al momento, le repliche vengono create anche in fase di esecuzione, quando le partizioni vengono aggiunte o rimosse. E ovviamente si trovano sempre su un server diverso.
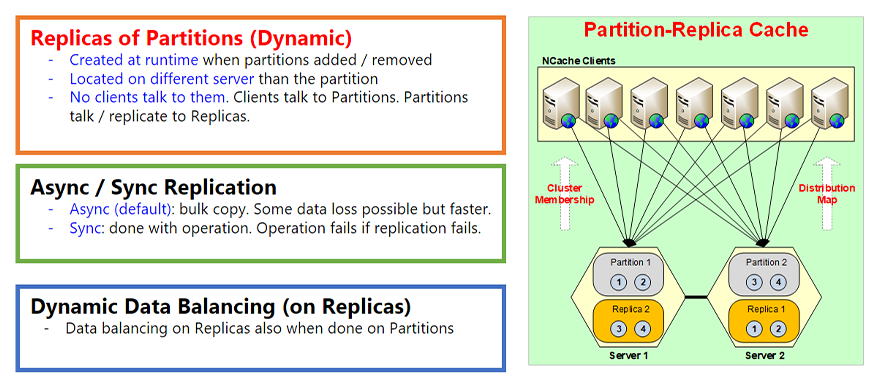
L'altro aspetto è che tutte le repliche sono passive. Passivo significa che nessun client comunica direttamente con loro. I client comunicano solo con le partizioni e le partizioni aggiornano la propria replica. Quindi, ogni volta che si aggiorna qualcosa nella partizione, la partizione lo aggiorna nella replica. E questo aggiornamento è asincrono per impostazione predefinita. Asincrono significa che può essere più veloce. Innanzitutto, il client non deve attendere che la replica avvenga, in secondo luogo è possibile eseguire una replica in blocco. Quindi, è possibile combinare centinaia o migliaia di questi aggiornamenti e spostarli o inviarli alla replica contemporaneamente. Questo perché il costo di questo viaggio di rete è molto più rapido o molto più costoso rispetto alla combinazione dei dati.
Replicazione asincrona/sincrona
- Asincrono (predefinito): copia in blocco. Possibile perdita di dati, ma più veloce.
- Sincronizza: operazione completata. L'operazione fallisce se la replica fallisce.
Tuttavia, la replica asincrona ovviamente non è sempre coerente. È coerente alla fine, il che è sufficiente per circa il 95-99% dei casi, e ci sono circa dall'1 al 5% dei casi in cui si ha a che fare con dati molto sensibili. Quindi, non si desidera una replica asincrona, ma una replica sincrona. Esiste una funzionalità chiamata "Replica Sincrona" che è possibile attivare e, quando si attiva questa funzionalità, ogni volta che il client aggiorna gli elementi nella partizione, l'operazione non viene completata finché la partizione non aggiorna prima la replica. Quindi, se la replica fallisce, l'operazione fallisce. Ecco perché, se l'operazione ha avuto successo, anche la replica ha avuto successo. Questa è una funzionalità molto importante.
Bilanciamento dinamico dei dati (sulle repliche)
- Bilanciamento dei dati sulle repliche anche quando eseguito sulle partizioni
Infine, proprio come nella topologia partizionata, anche nella topologia cache partizionata è presente il bilanciamento dinamico dei dati sulle repliche. Quindi, quando le partizioni vengono bilanciate dinamicamente, le repliche devono corrispondere, perché sono sempre copie identiche della partizione. Quindi, anche queste saranno sottoposte a un bilanciamento dei dati.
Partizionamento dinamico
Vediamo ora rapidamente come avviene realmente il partizionamento dinamico. Supponiamo di avere un cluster di due server, composto da 6 elementi, e di voler aggiungere un terzo server. Non aggiungo altri dati perché si tratta di un altro caso d'uso, ma è solo il modo in cui i dati vengono spostati su altre partizioni quando si aggiunge un altro nodo.
Supponiamo di aggiungere un nodo. Quindi, ora c'è un terzo server. Quindi, viene creata la Partizione 3 e ora riceve dati dalla Partizione 3 e dalla Partizione 1. Quindi, riceve alcuni dati dalla Partizione 2 e altri dalla Partizione 1. Quindi, supponiamo che prenda l'Elemento 2 dalla Partizione 3, l'Elemento 1 dalla Partizione 4 e diventi la Partizione 2.
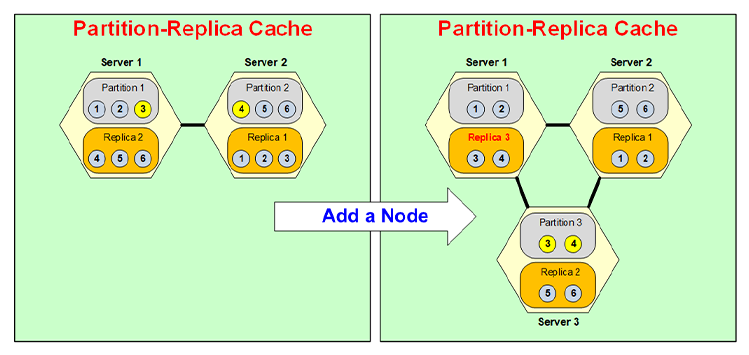
Ora che è diventata la Partizione 3, la sua replica deve essere su un server diverso, quindi, diciamo, viene posizionata sul Server 1. Quindi, il Server 1 aveva la Replica 2, viene convertita nella Replica 3 e poi la Replica 2 viene spostata sul Server 3. Quindi, ad esempio, ora la Replica 3 conterrà 3, 4 invece di 4, 5, 6, e la Replica 2 conterrà 5, 6. Tutto ciò verrà fatto dinamicamente in fase di esecuzione senza che l'applicazione subisca alcuna interruzione.
La stessa cosa accade al contrario, se un server si guasta, diciamo che avevi una partizione a tre NCache Cluster e Server 3 sono andati in crash, o lo hai fatto tu o è andato in crash lui, non appena ciò accade, perché la Partizione 3 non è più disponibile. Replica 3, come puoi vedere, ne ho cambiato il colore, diventa attiva. Normalmente, come ho detto, le repliche non sono attive, giusto? Solo le partizioni sono attive, ma ora questa diventa partizionata. Tuttavia, è solo temporaneo perché non si vogliono avere due partizioni sullo stesso server e quindi nessuna replica.
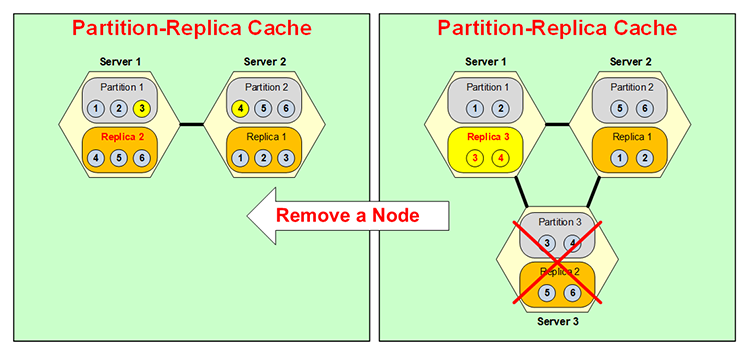
Quindi, ora questo si fonde qui con la Partizione 1, quindi, diciamo, l'Elemento 3 va alla Partizione 1, l'Elemento 4 va alla Partizione 2, e la tua situazione è questa qui e questa Replica 3 ora diventa Replica 2. Quindi, la stessa cosa accade al contrario, tutto in fase di esecuzione, Partizionamento Dinamico, molto, molto flessibile, molto dinamico. Questa dinamicità aggiunge la potenza di alta disponibilità di NCache.
Modalità di manutenzione
Beh, sebbene il partizionamento dinamico sia molto utile e potente, ci sono alcuni casi in cui non si desidera ripartizionare, e uno di questi casi è la manutenzione programmata. Supponiamo che si stia eseguendo una patch del sistema operativo e che quella patch manderà in tilt il server per cinque o dieci minuti. Beh, sai che l'intero cluster di cache potrebbe contenere decine di gigabyte di dati. Quindi, non si desidera ripartizionare solo per quei cinque minuti e poi ripartizionare di nuovo quando si ripristina il nodo. Quindi, è possibile attivare una funzione di manutenzione programmata. NCache in tal caso, quando si disattiva questo nodo, è necessario farlo nuovamente tramite lo strumento di gestione; ciò attiva le cose per cui questa replica diventa attiva, ma non c'è alcun ripartizionamento.
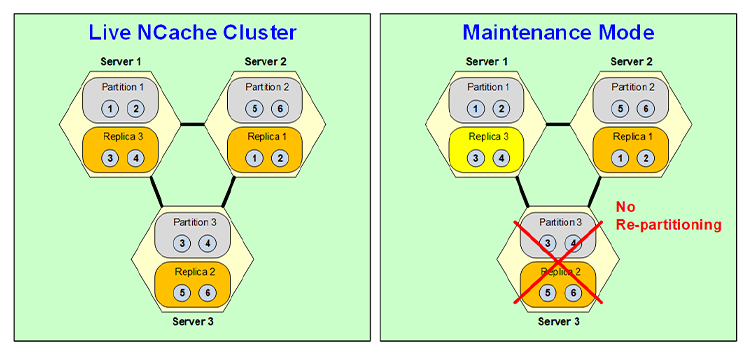
Quindi, rimane una configurazione a due server con Partizione 1 Replica 3, Partizione 2 Replica 1 e questa Replica 3 è in realtà la Partizione 3, il che significa che è attiva e funzionante. Ovviamente, non si tratta di alta disponibilità perché, sebbene la Partizione 1 sia sottoposta a backup, la Partizione 2 non ha alcun backup e la Replica 3 non ha alcun backup. Tuttavia, questo è solo temporaneo perché è necessario solo per 5-10 minuti. Quindi, una volta che questo server torna attivo, torna allo stato precedente e diventa di nuovo una replica quando questa diventa di nuovo una partizione. Ecco come funziona la funzionalità di manutenzione programmata di NCache .
Cache replicata
La topologia successiva è chiamata a Cache replicataIn questa topologia è possibile avere due o più server, ognuno dei quali dispone di una copia completa della cache e di un server attivo, il che significa che ogni server ha dei client connessi. Tuttavia, in questo caso, ogni client si connette a un solo server, poiché quel server dispone dell'intera cache. Pertanto, non è necessario connettersi a due server, come avviene con una partizione o una replica di partizione.

Con questa topologia, tutte le letture sono superveloci perché l'intera cache è presente, ma gli aggiornamenti devono essere eseguiti in modo sincrono. Poiché entrambi i server sono attivi, lo stesso elemento potrebbe essere aggiornato simultaneamente qui e qui e ovviamente non si vuole incorrere in problemi di integrità dei dati. Quindi, l'aggiornamento avviene in modo sincrono, con uno schema di indicizzazione, un indice, un numero di sequenza emesso e ogni elemento viene aggiornato nella stessa sequenza. Questo consente di eseguire sempre gli aggiornamenti in modo corretto. Tuttavia, il costo è che un aggiornamento sincrono significa che se si dispone di un client che aggiorna l'Elemento 1, questo server notificherà all'Elemento 2 di aggiornare l'Elemento 1. Solo quando entrambi i server hanno aggiornato correttamente l'Elemento 1, l'aggiornamento ha esito positivo e il controllo viene ripristinato. Ciò significa che non è veloce quanto la topologia Partition o Partition Replica, ma l'operazione è garantita: se l'aggiornamento ha esito positivo, significa che viene sempre eseguito su tutti i server.
Questa topologia è adatta per operazioni ad alta intensità di lettura. Per un cluster a due server, anche le scritture sono piuttosto veloci, non quanto la replica delle partizioni, ma ragionevolmente veloci nella maggior parte delle situazioni. Tuttavia, aggiungendo più server, le prestazioni degli aggiornamenti diminuiscono. Anzi, diventa più lenta perché più server devono essere aggiornati in modo sincrono. Questa topologia ha quindi i suoi utilizzi, ed è per questo che la manteniamo. Molti dei nostri clienti la utilizzano in situazioni particolari.
cache specchiata
La quarta topologia è chiamata cache specchiataAnche questa è una topologia molto specifica. È una topologia a 2 nodi. Ci sono un nodo attivo e uno passivo. Anche in questo caso, il nodo attivo ha l'intera cache e una copia della cache si trova sul nodo passivo. Tutti i client si connettono al nodo attivo e aggiornano il nodo attivo per tutti i dati, e gli aggiornamenti vengono replicati o replicati in modo asincrono sul nodo passivo. E questo asincrono significa anche che è piuttosto veloce, proprio come Partition Replica.

In questa topologia, se un nodo attivo dovesse mai interrompersi, il nodo passivo diventa automaticamente attivo e tutti i client si spostano automaticamente sul nodo passivo o su quello appena attivato. In questo modo non si verificano tempi di inattività, né interruzioni. Questo è il cosiddetto supporto al failover automatico, ed è proprio questo che intendevo. E poi, ovviamente, quando il nodo attivo si riattiva, questo diventa di nuovo attivo e la stessa cosa avviene al contrario.
Quindi, la topologia Mirror è molto utile anche per casi specifici. Non è scalabile oltre questi due server, ma ha una sua utilità perché tutti i client si connettono qui, e quindi è possibile eseguire una replica su un server diverso. Voglio dire, potrebbe essere utile, ad esempio, in caso di disaster recovery.
Persistenza viva
Un'altra caratteristica molto potente di NCache è chiamato Persistenza vivaLa persistenza live è disponibile solo per topologie di partizioni e repliche di partizioni ed è live, il che significa che quando si aggiorna la cache in fase di esecuzione, anche l'archivio di persistenza viene aggiornato immediatamente. L'aggiornamento dell'archivio persistente è asincrono. Pertanto, non interferisce con le prestazioni dell'applicazione o NCache prestazioni. Quindi, ecco come la tua applicazione può rimanere molto veloce. La persistenza viene eseguita a livello di bucket. Quindi, ci sono 100 bucket che rappresentano l'intera cache che viene mantenuta in un archivio di documenti NoSQL. È un archivio basato su file, quindi non è un archivio basato su server. Non è un server di database NoSQL, è un archivio di documenti NoSQL che NCache usi. Puoi usarlo in una posizione comune che è comune a tutti i server nel NCache cluster, e in questo modo possono tutti fare affidamento sullo stesso archivio persistente.
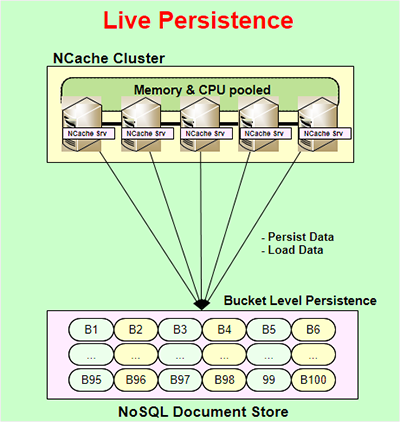
Alcuni dei vantaggi di questa funzionalità, e il motivo per cui è stata fornita, sono: innanzitutto, qualsiasi cosa tu stia rendendo persistente, puoi, ad esempio, rendere persistente l'intera cache, e l'intera cache sarà sempre mantenuta. Puoi dire che qualsiasi cosa tu stia aggiornando nella cache, con una differenza di pochi millisecondi, viene anche conservata nell'archivio persistente. Quindi, puoi prenderla e ricaricarla in una cache diversa, oppure, se tutti i server dovessero bloccarsi, puoi sempre riavviarli dagli archivi persistenti. Non perdi alcun dato, tranne una quantità molto piccola di dati. Oppure, se vuoi spostare la cache da un ambiente all'altro, puoi farlo facilmente.
L'altro vantaggio è che aggiunge effettivamente maggiore alta disponibilità alle topologie di partizione e replica di partizione. Beh, topologia di partizione, e ne parlerò qui. Quindi, la cache partizionata, come ho detto prima, non prevede alcuna replica, quindi, se una partizione o un server dovesse guastarsi, si perderebbe quella partizione, giusto? Beh, se la persistenza è attiva, non lo è. Perché una copia di quei dati viene conservata anche in questi bucket. Quindi, se questo server dovesse guastarsi, i bucket in memoria vengono riassegnati, ma ovviamente senza dati, ad altri server e ora quei server sanno che si tratta di bucket vuoti i cui dati sono presenti nell'archivio di persistenza, quindi ricaricheranno quei dati dall'archivio di persistenza.
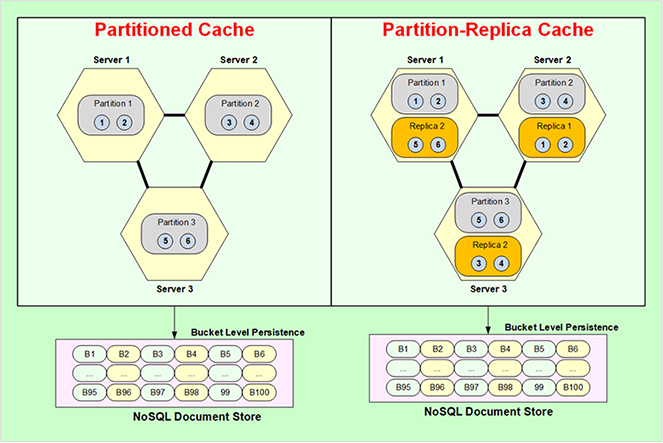
Ecco come non si perdono dati nemmeno in caso di guasto di un server, anche se si utilizza Partitioned-Cache. E si ottengono gli stessi vantaggi di Partitioned-Cache, sia con Partitioned-Replica che con Partitioned-Cache.
Il vantaggio che otterrai qui è che puoi utilizzare più memoria. Puoi archiviare più dati nella cache perché qui devi allocare più memoria per la replica, che non è necessario allocare qui, ma devi allocare l'archivio di persistenza. Quindi, questo è il vantaggio della cache partizionata. C'è anche un vantaggio nella replica di partizioni. Ed è piuttosto interessante che, sebbene questo offra già un'elevata disponibilità, questa elevata capacità si verifica solo se un server si guasta in un dato momento. Ad esempio, se due server dovessero guastarsi contemporaneamente senza la persistenza, anche nella replica di partizioni si perderebbero dati. Perché, sai, c'è una sola copia di ogni partizione e se due server dovessero guastarsi, avresti perso più server di quanti te ne possa permettere. Beh, con la persistenza non hai alcun problema, puoi semplicemente ricaricare tutti quei dati dall'archivio di persistenza.
Ovviamente, in entrambi i casi, bisogna tenere presente che ogni volta che si caricano dati dall'archivio di persistenza, prima si avevano tre server, ora ne abbiamo due. Tuttavia, i dati potrebbero avere un valore troppo elevato per essere contenuti nei due server, il che potrebbe rappresentare un altro problema: assicurarsi di avere memoria sufficiente sui due server rimanenti per contenere l'equivalente di tutti e tre i server. Questa è l'unica limitazione. Altrimenti, la persistenza aggiunge davvero valore sia alla cache partizionata che a quella di replica delle partizioni.
Cache cliente
Ok, un'altra caratteristica molto importante di NCache è chiamato Cache cliente. Offre una velocità InProc in un ambiente di archiviazione distribuito. Quindi, ad esempio, hai un ambiente di archiviazione distribuito NCache cluster, la tua applicazione è in esecuzione qui, di solito si tratta di una cache sopra il tuo database o qualsiasi altra cosa tu stia facendo, una cache client viene solitamente utilizzata quando hai uno scenario di cache distribuita e una cache client è una cache sopra questo cluster di cache e si trova molto vicino alla tua applicazione. Si trova sul server applicativo o sul NCache client box. E può anche essere InProc o OutProc, a seconda delle preferenze. Una cache InProc è superveloce perché mantiene i dati in forma di oggetto deserializzato sullo heap. Quindi, è come avere quell'oggetto sullo heap. Può essere anche più veloce.

Quindi, una cache InProc è super veloce ma allo stesso tempo il bello è che è sincronizzata con NCache cluster. E il modo in cui viene sincronizzato è quello in cui, qualunque cosa sia conservata nella cache client, il cluster ne è a conoscenza. Quindi, se qualcosa che era conservato in questa cache client viene aggiornato da un altro client nel cluster, il cluster notifica a quella cache client di aggiornarsi. E poi quella cache client si aggiorna in modo asincrono. Ovviamente, c'è un ritardo di qualche millisecondo, ma questo, come ho detto, nella maggior parte dei casi è il modello di coerenza finale, e di solito è accettabile nel 99% dei casi.
Se questo non è accettabile allora NCache ti fornisce... e la sincronizzazione ottimistica è quella predefinita, ovvero quando c'è un ritardo di qualche millisecondo e potrebbe tecnicamente verificarsi una situazione in cui i dati sono obsoleti, il che, come ho detto, va bene nel 99% dei casi. Ma, diciamo, se non fosse accettabile e i dati fossero molto sensibili ma si volesse comunque utilizzare la cache client, allora si potrebbe utilizzare una funzionalità di sincronizzazione pessimistica che si assicura che prima che l'applicazione recuperi qualcosa dalla cache client, la cache client controlli solo se esiste una versione più recente di quei dati. Questa è una chiamata più veloce rispetto all'acquisizione dei dati stessi perché, NCache Quindi conserva più informazioni di versione. E, se esiste una versione più recente di quei dati, la cache client la recupera, altrimenti la restituisce semplicemente dalla cache client.
Una cache client che puoi utilizzare senza alcuna modifica al codice. Si integra semplicemente nel tuo ambiente ed è ideale per situazioni con un elevato numero di letture. Quando si eseguono molte più letture, almeno 5:1, 10:1 è l'ideale, ma quando si arriva a 1:1, ad esempio nel caso di sessioni web, la cache client in realtà non è affatto utile. Anzi, non è affatto consigliata.
Replica WAN
Multi-zona / Multi-regione
Okay, un'altra parte di NCache è il dove NCache effettua Replica WAN per gestire la distribuzione multizona o multiregione delle tue applicazioni. Ad esempio, potresti distribuire la tua applicazione su due siti diversi per il DR e per il Disaster Recovery, uno attivo e uno passivo. E hai questa applicazione, un NCache in esecuzione, e qui hai un'applicazione che non è in esecuzione. Ma vuoi assicurarti che, se questo sito dovesse mai andare in crash, questo sia immediatamente in grado di riprendere il carico. Quindi, puoi installare un bridge. Un bridge è un cluster a 2 nodi che può trovarsi sugli stessi server del NCache principale, oppure potrebbe essere una cache dedicata separata, a tua scelta. E tutto ciò che aggiorni in questa cache viene replicato in modo asincrono attraverso la WAN nell'altra cache. Quindi, questa è la cache attiva-passiva.

Puoi fare la stessa cosa con un active-active. Supponiamo che tu abbia una situazione in cui anche questo sito è attivo, cosa puoi fare esattamente con un active-active in cui entrambi i siti possono aggiornarsi a vicenda? In tal caso, c'è anche una situazione in cui potrebbe verificarsi un conflitto. E un conflitto significa che lo stesso elemento, la stessa chiave, viene aggiornato su entrambi i siti contemporaneamente. In tal caso, il bridge applica per impostazione predefinita la logica "l'ultimo aggiornamento vince". Quindi, vince l'aggiornamento con il timestamp più recente. Ma, ad esempio, se lo desideri, potresti anche fornire una risoluzione dei conflitti e un gestore di risoluzione dei conflitti, ovvero il tuo codice .NET o Java che il bridge chiamerà, e passerà entrambe le copie dei dati o dell'oggetto a quel gestore di risoluzione. Quindi puoi analizzare il contenuto per determinare quale sia il più corretto, e quindi dire, ok, questo aggiornamento vince e quindi quell'aggiornamento viene applicato a entrambi i siti. Finché viene applicato a entrambe le parti, non ci sono conflitti.
Migliori NCache Ha la capacità di fornirti tre o più siti in modalità attivo-attivo, o attivo-passivo, o una combinazione di questi. Quindi, ad esempio, hai bisogno di almeno un sito attivo, ma poi potrebbero essere tutti passivi o potrebbero essere tutti attivi o potrebbe essere una combinazione di attivo e passivo. E, ancora una volta, allo stesso modo, quando c'è più di un sito attivo, questa potrebbe essere una risoluzione del conflitto.

Contenitori (Docker e Kubernetes)
Infine, i container Docker e Kubernetes sono diventati molto popolari. Quindi, NCache Ovviamente li supporta perché sono più popolari su Java e Linux che su .NET e Windows, ma sono sicuro che questo cambierà, sai, con il tempo. Quindi, in ogni caso, NCache è pienamente in grado di gestirlo in entrambi gli ambienti. Quindi, ad esempio, ecco un tipico Distribuzione di Kubernetes di NCache.

Ecco un file NCache distribuzione. C'è NCache ha il suo servizio di scoperta. Si tratta di pod che possono scalare e quindi si hanno applicazioni all'interno del cluster Kubernetes che sono NCache client e questo potrebbe essere Azure, AKS, AWS, EKS, Google GKE o Red Hat OpenShift. Red Hat OpenShift di solito è un altro cloud come AWS, Azure o Google o forse un altro Cloud ma NCache supporta tutti loro. E questo Pod potrebbe essere Linux, che è il caso più comune in Kubernetes, e NCache Funziona perfettamente. E l'applicazione può essere Linux o Windows. Quindi, potrebbero essere Linux o Windows, Linux o Windows.
Docker / Kubernetes (multizona)
Allo stesso modo, la replicazione WAN entra in gioco, anche se, ad esempio, grazie al cloud è possibile avere più zone di disponibilità. Si vuole realizzare un Kubernetes multizona.

Quindi, il modo in cui consigliamo è di creare un cluster Kubernetes, di averne due NCache distribuzioni, queste potrebbero essere attive-attive o attive-passive. E quindi il bridge può essere posizionato completamente qui, o completamente qui. Oppure si può anche avere un bridge suddiviso in modo che una parte si trovi in questa zona e una parte in quell'altra, e quindi la replica avviene in modo asincrono.
Penso che questo abbia coperto abbastanza l'argomento di oggi. Ti consiglio vivamente di visitare il nostro sito web e di dare un'occhiata a NCache Parco giochi che è davvero un modo molto rapido e semplice per utilizzare una copia live in esecuzione dal tuo browser NCachee puoi anche ottenere un 2-Node NCache Cluster con tutti gli strumenti senza alcuno sforzo di installazione. Oppure, se sei pronto, vieni qui e registrati e scarica o NCache Enterprise per .NET Edition o NCache Enterprise per Java Edition. Come ho detto, puoi ottenere il file .tar.gz per Linux, il file .msi oppure puoi anche ottenere il Docker. Puoi semplicemente scaricare un'immagine Docker di NCacheCon questo si conclude la mia presentazione. Grazie mille.